# mysql
**Repository Path**: Ernest_xin/mysql
## Basic Information
- **Project Name**: mysql
- **Description**: mysql学习手册
- **Primary Language**: Unknown
- **License**: Not specified
- **Default Branch**: master
- **Homepage**: None
- **GVP Project**: No
## Statistics
- **Stars**: 0
- **Forks**: 1
- **Created**: 2022-03-17
- **Last Updated**: 2024-10-29
## Categories & Tags
**Categories**: Uncategorized
**Tags**: None
## README
[TOC]
# **MySQL手册**
## MySQL概述
### 什么是MySQL
MySQL是最流行的开源关系型数据库管理系统, 由Oracle Corporation开发 。
网站:
### 什么是数据库
数据库(Database)是按照数据结构来组织、存储和管理数据的仓库。
每个数据库都有一个或多个不同的 API 用于创建,访问,管理,搜索和复制所保存的数据。
我们也可以将数据存储在文件中,但是在文件中读写数据速度相对较慢。
### 什么是关系型数据库( RDBMS )
关系型数据库(RDBMS),是建立在关系模型基础上的数据库,借助于集合代数等数学概念和方法来处理数据库中的数据。
RDBMS 即关系数据库管理系统(Relational Database Management System)的特点:
- 1.数据以表格的形式出现
- 2.每行为各种记录名称
- 3.每列为记录名称所对应的数据域
- 4.许多的行和列组成一张表单
- 5.若干的表单组成database
### RDBMS 术语
在我们开始学习MySQL 数据库前,让我们先了解下RDBMS的一些术语:
- **数据库:** 数据库是一些关联表的集合。
- **数据表:** 表是数据的矩阵。在一个数据库中的表看起来像一个简单的电子表格。
- **列:** 一列(数据元素) 包含了相同类型的数据, 例如邮政编码的数据。
- **行:**一行(=元组,或记录)是一组相关的数据,例如一条用户订阅的数据。
- **冗余**:存储两倍数据,冗余降低了性能,但提高了数据的安全性。
- **主键**:主键是唯一的。一个数据表中只能包含一个主键。你可以使用主键来查询数据。
- **外键:**外键用于关联两个表。
- **复合键**:复合键(组合键)将多个列作为一个索引键,一般用于复合索引。
- **索引:**使用索引可快速访问数据库表中的特定信息。索引是对数据库表中一列或多列的值进行排序的一种结构。类似于书籍的目录。
- **参照完整性:** 参照的完整性要求关系中不允许引用不存在的实体。与实体完整性是关系模型必须满足的完整性约束条件,目的是保证数据的一致性。
MySQL 为关系型数据库(Relational Database Management System), 这种所谓的"关系型"可以理解为"表格"的概念, 一个关系型数据库由一个或数个表格组成, 如图所示的一个表格:

- 表头(header): 每一列的名称;
- 列(col): 具有相同数据类型的数据的集合;
- 行(row): 每一行用来描述某条记录的具体信息;
- 值(value): 行的具体信息, 每个值必须与该列的数据类型相同;
- 键(key): 键的值在当前列中具有唯一性。
### MySQL数据库
MySQL 是一个关系型数据库管理系统,由瑞典MySQL AB 公司开发,目前属于 Oracle 公司。MySQL 是一种关联数据库管理系统,关联数据库将数据保存在不同的表中,而不是将所有数据放在一个大仓库内,这样就增加了速度并提高了灵活性。
- MySQL 是开源的,所以你不需要支付额外的费用。
- MySQL 支持大型的数据库。可以处理拥有上千万条记录的大型数据库。
- MySQL 使用标准的 SQL 数据语言形式。
- MySQL 可以运行于多个系统上,并且支持多种语言。这些编程语言包括 C、C++、Python、Java、Perl、PHP、Eiffel、Ruby 和 Tcl 等。
- MySQL 对PHP有很好的支持,PHP 是目前最流行的 Web 开发语言。
- MySQL 支持大型数据库,支持 5000 万条记录的数据仓库,32 位系统表文件最大可支持 4GB,64 位系统支持最大的表文件为8TB。
- MySQL 是可以定制的,采用了 GPL 协议,你可以修改源码来开发自己的 MySQL 系统。
#### MySQL是一个数据库管理系统
数据库是数据的结构化集合。它可以是从简单的购物清单到图片库或公司网络中的大量信息。
#### MySQL是关系型数据库
关系数据库将数据存储在单独的表中,而不是将所有数据放在一个大的库房中。数据库结构被组织成针对速度优化的物理文件。逻辑模型具有数据库,表,视图,行和列等对象,可提供灵活的编程环境。您可以设置管理不同数据字段之间关系的规则,例如一对一,一对多,唯一,必需或可选,以及 不同表之间的“ 指针 ”。数据库强制执行这些规则,因此使用设计良好的数据库,您的应用程序永远不会看到不一致,重复,孤立,过时或丢失的数据。
“ MySQL ” 的SQL部分代表 “ 结构化查询语言 ”。SQL是用于访问数据库的最常用的标准化语言。根据您的编程环境,您可以直接输入SQL(例如,生成报告),将SQL语句嵌入到用其他语言编写的代码中,或使用隐藏SQL语法的特定于语言的API。
SQL由ANSI / ISO SQL标准定义。SQL标准自1986年以来一直在发展,并且存在多个版本。在本手册中,“ SQL-92 ”是指1992年发布的标准,“ SQL:1999 ”是指1999年发布的标准,“ SQL:2003 ”是指当前版本的标准。我们在任何时候都使用短语 “ SQL标准 ”来表示当前版本的SQL标准。
#### MySQL软件是开源的。
## SQL基础
### SQL简介
当面对一个陌生的数据库时,通常需要一种方式与它进行交互,以完成用户所需要的各种工作,这个时候,就要用到 SQL 语言了。
SQL 是 Structure Query Language(结构化查询语言)的缩写,它是使用关系模型的数据库应用语言,由 IBM 在 20 世纪 70 年代开发出来,作为 IBM 关系数据库原型 System R 的原型关系语言,实现了关系数据库中的信息检索。
20 世纪 80 年代初,美国国家标准局(ANSI)开始着手制定 SQL 标准,最早的 ANSI 标准于 1986 年完成,就被叫作 SQL-86。标准的出台使 SQL 作为标准关系数据库语言的地位得到了 加强。SQL 标准目前已几经修改更趋完善。 正是由于 SQL 语言的标准化,所以大多数关系型数据库系统都支持 SQL 语言,它已经发展成为多种平台进行交互操作的底层会话语言
### SQL分类
SQL 语句主要可以划分为以下 3 个类别。
DDL(Data Definition Languages)语句:数据定义语言,这些语句定义了不同的数据段、 数据库、表、列、索引等数据库对象的定义。常用的语句关键字主要包括 create、drop、alter 等。
DML(Data Manipulation Language)语句:数据操纵语句,用于添加、删除、更新和查 询数据库记录,并检查数据完整性,常用的语句关键字主要包括 insert、delete、udpate 和 select 等。
DCL(Data Control Language)语句:数据控制语句,用于控制不同数据段直接的许可和 访问级别的语句。这些语句定义了数据库、表、字段、用户的访问权限和安全级别。主要的 语句关键字包括 grant、revoke 等
#### DDL 语句
DDL 是数据定义语言的缩写,简单来说,就是对数据库内部的对象进行创建、删除、修改的操作语言。它和 DML 语言的最大区别是 DML 只是对表内部数据的操作,而不涉及到表的定义、结构的修改,更不会涉及到其他对象。DDL 语句更多的被数据库管理员(DBA)所使用, 一般的开发人员很少使用。
#### DML 语句
DML 操作是指对数据库中表记录的操作,主要包括表记录的插入(insert)、更新(update)、
删除(delete)和查询(select),是开发人员日常使用最频繁的操作。
#### DCL 语句
DCL 语句主要是 DBA 用来管理系统中的对象权限时所使用,一般的开发人员很少使用。
## MySQL数据库
### 创建数据库
使用 **create** 命令创建数据库,语法如下:
```mysql
CREATE DATABASE db_name;
```
以下命令简单的演示了创建数据库的过程,数据名为 test1:
```mysql
mysql> CREATE DATABASE test1;
Query OK, 1 row affected (0.00 sec)
```
说明
执行完创建命令后,下面有一行提示“Query OK, 1 row affected (0.00 sec)”
“Query OK”表示上面的命令执行成功,读者可能奇怪,又不是执行 查询操作,为什么显示查询成功?其实这是 MySQL 的一个特点,所有的 DDL 和 DML(不包 括 SELECT)操作执行成功后都显示“Query OK”,这里理解为执行成功就可以了;
“1 row affected”表示操作只影响了数据库中一行的记录
“0.00 sec”则记录了操作执行的时间。
如果已经存在这个数据库,系统会提示:
```mysql
mysql> CREATE DATABASE test1;
ERROR 1007 (HY000): Can't create database 'test1'; database exists
```
### 查看系统中的数据库
要查看所有数据库,语法如下
```mysql
show databases;
```
如果需要知道系统中都存在哪些数据库,可以用以下命令来查看:
```mysql
mysql> show databases;
+--------------------+
| Database |
+--------------------+
| information_schema |
| cluster |
| mysql |
| test |
| test1 |
+--------------------+
5 rows in set (0.00 sec)
```
说明
可以发现,在上面的列表中除了刚刚创建的 test1 外,还有另外 4 个数据库,它们都是安装 MySQL 时系统自动创建的,其各自功能如下。
information_schema:主要存储了系统中的一些数据库对象信息。比如用户表信息、列信息、权限信息、字符集信息、分区信息等。
cluster:存储了系统的集群信息。
mysql:存储了系统的用户权限信息。
test:系统自动创建的测试数据库,任何用户都可以使用。
### 选择数据库
在查看了系统中已有的数据库后,可以用如下命令选择要操作的数据库:
```mysql
USE dbname
```
例如,选择数据库 test1:
```mysql
mysql> use test1
Database changed
```
### 删除数据库
删除数据库的语法很简单,如下所示:
```mysql
drop database dbname;
```
例如,要删除 test1数据库可以使用以下语句:
```mysql
mysql> drop database test1;
Query OK, 0 rows affected (0.00 sec)
```
说明
可以发现,提示操作成功后,后面却显示了“0 rows affected”,这个提示可以不用管它,在 MySQL 里面,drop 语句操作的结果显示都是“0 rows affected”。
**注意**:数据库删除后,下面的所有表数据都会全部删除,所以删除前一定要仔细检查并做好相应备份.
## MySQL表
### 创建表
创建MySQL数据表需要以下信息:
- 表名
- 表字段名
- 定义每个表字段
在数据库中创建一张表的基本语法如下:
```mysql
CREATE TABLE tablename
(column_name_1 column_type_1 constraints,
column_name_2 column_type_2 constraints,
……column_name_n column_type_n constraints);
```
因为 MySQL 的表名是以目录的形式存在于磁盘上,所以表名的字符可以用任何目录名允许 的字符。
column_name 是列的名字,column_type 是列的数据类型,contraints 是这个列的约 束条件,在后面会详细介绍。
例如,创建一个名称为 emp的表。
表中包括 3 个字段,ename(姓名),hiredate(雇用日期)、 sal(薪水),
字段类型分别为 varchar(10)、date、int(2)(关于字段类型将会在后面 介绍):
```mysql
mysql> create table emp(ename varchar(10),hiredate date,sal decimal(10,2),deptno int(2));
Query OK, 0 rows affected (0.02 sec)
```
实例解析:
- 如果你不想字段为 **NULL** 可以设置字段的属性为 **NOT NULL**, 在操作数据库时如果输入该字段的数据为**NULL** ,就会报错。
- AUTO_INCREMENT定义列为自增的属性,一般用于主键,数值会自动加1。
- PRIMARY KEY关键字用于定义列为主键。 您可以使用多列来定义主键,列间以逗号分隔。
- ENGINE 设置存储引擎,CHARSET 设置编码。
### 查看表定义
表创建完毕后,如果需要查看一下表的定义,可以使用如下命令:
```mysql
DESC tablename
```
例如,查看 emp 表,将输出以下信息:
```mysql
mysql> desc emp;
+----------+---------------+------+-----+---------+-------+
| Field | Type | Null | Key | Default | Extra |
+----------+---------------+------+-----+---------+-------+
| ename | varchar(10) | YES | | | |
| hiredate | date | YES | | | |
| sal | decimal(10,2) | YES | | | |
| deptno | int(2) | YES | | | |
+----------+---------------+------+-----+---------+-------+
4 rows in set (0.00 sec)
```
虽然 desc 命令可以查看表定义,但是其输出的信息还是不够全面,为了查看更全面的表定 义信息,有时就需要通过查看创建表的 SQL 语句来得到,可以使用如下命令实现:
语法
```mysql
show create table tablename \G;
```
例如查看 emp 表
```mysql
mysql> show create table emp \G;
*************************** 1. row ***************************
Table: emp
Create Table: CREATE TABLE `emp` (
`ename` varchar(20) DEFAULT NULL,
`hiredate` date DEFAULT NULL,
`sal` decimal(10,2) DEFAULT NULL,
`deptno` int(2) DEFAULT NULL,
KEY `idx_emp_ename` (`ename`)
) ENGINE=InnoDB DEFAULT CHARSET=gbk
1 row in set (0.02 sec)
ERROR:
No query specified
```
从上面表的创建 SQL 语句中,除了可以看到表定义以外,还可以看到表的 engine(存储引擎) 和 charset(字符集)等信息。
“\G”选项的含义是使得记录能够按照字段竖着排列,对于内 容比较长的记录更易于显示。
### 删除表
表的删除命令如下:
```mysql
DROP TABLE tablename
```
例如,要删除数据库 emp 可以使用以下命令:
```mysql
mysql> drop table emp;
Query OK, 0 rows affected (0.00 sec)
```
**注意**:MySQL中删除数据表是非常容易操作的, 但是你再进行删除表操作时要非常小心,因为执行删除命令后所有数据都会消失。
### 修改表
对于已经创建好的表,尤其是已经有大量数据的表,如果需要对表做一些结构上的改变,我们可以先将表删除(drop),然后再按照新的表定义重建表。这样做没有问题,但是必然要 做一些额外的工作,比如数据的重新加载。而且,如果有服务在访问表,也会对服务产生影响。
因此,在大多数情况下,表结构的更改一般都使用 alter table 语句,以下是一些常用的命令。
#### 修改表类型
修改表类型,语法如下:
```mysql
ALTER TABLE tablename MODIFY [COLUMN] column_definition [FIRST | AFTER col_name]
```
例如,修改表 emp 的 ename 字段定义,将 varchar(10)改为 varchar(20):
```mysql
mysql> alter table emp modify ename varchar(20);
Query OK, 0 rows affected (0.03 sec)
Records: 0 Duplicates: 0 Warnings: 0
mysql> desc emp;
+----------+---------------+------+-----+---------+-------+
| Field | Type | Null | Key | Default | Extra |
+----------+---------------+------+-----+---------+-------+
| ename | varchar(20) | YES | | | |
| hiredate | date | YES | | | |
| sal | decimal(10,2) | YES | | | |
| deptno | int(2) | YES | | | |
+----------+---------------+------+-----+---------+-------+
4 rows in set (0.00 sec)
```
#### 增加表字段
增加表字段,语法如下:
```mysql
ALTER TABLE tablename ADD [COLUMN] column_definition [FIRST | AFTER col_name]
```
例如,表 emp上新增加字段 age,类型为 int(3):
```mysql
mysql> alter table emp add column age int(3);
Query OK, 0 rows affected (0.03 sec)
Records: 0 Duplicates: 0 Warnings: 0
mysql> desc emp;
+----------+---------------+------+-----+---------+-------+
| Field | Type | Null | Key | Default | Extra |
+----------+---------------+------+-----+---------+-------+
| ename | varchar(20) | YES | | | |
| hiredate | date | YES | | | |
| sal | decimal(10,2) | YES | | | |
| deptno | int(2) | YES | | | |
| age | int(3) | YES | | | |
+----------+---------------+------+-----+---------+-------+
5 rows in set (0.00 sec)
```
#### 删除表字段
删除表字段,语法如下:
```mysql
ALTER TABLE tablename DROP [COLUMN] col_name
```
例如,将字段 age 删除掉:
```mysql
mysql> alter table emp drop column age;
Query OK, 0 rows affected (0.04 sec)
Records: 0 Duplicates: 0 Warnings: 0
mysql> desc emp;
+----------+---------------+------+-----+---------+-------+
| Field | Type | Null | Key | Default | Extra |
+----------+---------------+------+-----+---------+-------+
| ename | varchar(20) | YES | | | |
| hiredate | date | YES | | | |
| sal | decimal(10,2) | YES | | | |
| deptno | int(2) | YES | | | |
+----------+---------------+------+-----+---------+-------+
4 rows in set (0.00 sec)
```
#### 字段改名
字段改名,语法如下:
```mysql
ALTER TABLE tablename CHANGE [COLUMN] old_col_name column_definition [FIRST|AFTER col_name]
```
例如,将 age 改名为 age1,同时修改字段类型为 int(4):
```mysql
mysql> alter table emp change age age1 int(4) ;
Query OK, 0 rows affected (0.02 sec)
Records: 0 Duplicates: 0 Warnings: 0
mysql> desc emp;
+----------+---------------+------+-----+---------+-------+
| Field | Type | Null | Key | Default | Extra |
+----------+---------------+------+-----+---------+-------+
| ename | varchar(20) | YES | | | |
| hiredate | date | YES | | | |
| sal | decimal(10,2) | YES | | | |
| deptno | int(2) | YES | | | |
| age1 | int(4) | YES | | | |
+----------+---------------+------+-----+---------+-------+
5 rows in set (0.00 sec)
```
**注意**:change 和 modify都可以修改表的定义,不同的是 change 后面需要写两次列名,不方便。 但是 change 的优点是可以修改列名称,modify则不能。
#### 修改字段排列顺序
前面介绍的的字段增加和修改语法(ADD/CNAHGE/MODIFY)中,都有一个可选项 first|after column_name,这个选项可以用来修改字段在表中的位置,默认 ADD 增加的新字段是加在 表的最后位置,而 CHANGE/MODIFY 默认都不会改变字段的位置。
例如,将新增的字段 birth date 加在 ename 之后:
```mysql
mysql> alter table emp add birth date after ename;
Query OK, 0 rows affected (0.03 sec)
Records: 0 Duplicates: 0 Warnings: 0
mysql> desc emp;
+----------+---------------+------+-----+---------+-------+
| Field | Type | Null | Key | Default | Extra |
+----------+---------------+------+-----+---------+-------+
| ename | varchar(20) | YES | | | |
| birth | date | YES | | | |
| hiredate | date | YES | | | |
| sal | decimal(10,2) | YES | | | |
| deptno | int(2) | YES | | | |
| age | int(3) | YES | | | |
+----------+---------------+------+-----+---------+-------+
6 rows in set (0.00 sec)
```
修改字段 age,将它放在最前面:
```mysql
mysql> alter table emp modify age int(3) first;
Query OK, 0 rows affected (0.03 sec)
Records: 0 Duplicates: 0 Warnings: 0
mysql> desc emp;
+----------+---------------+------+-----+---------+-------+
| Field | Type | Null | Key | Default | Extra |
+----------+---------------+------+-----+---------+-------+
| age | int(3) | YES | | | |
| ename | varchar(20) | YES | | | |
| birth | date | YES | | | |
| hiredate | date | YES | | | |
| sal | decimal(10,2) | YES | | | |
| deptno | int(2) | YES | | | |
+----------+---------------+------+-----+---------+-------+
6 rows in set (0.00 sec)
```
**注意**:CHANGE/FIRST|AFTER COLUMN这些关键字都属于MySQL在标准 SQL上的扩展,在 其他数据库上不一定适用。
#### 表改名
表改名,语法如下:
```mysql
ALTER TABLE tablename RENAME [TO] new_tablename
```
例如,将表 emp 改名为 emp1,命令如下:
```mysql
mysql> alter table emp rename emp1;
Query OK, 0 rows affected (0.00 sec)
mysql> desc emp;
ERROR 1146 (42S02): Table 'sakila.emp' doesn't exist
mysql> desc emp1;
+----------+---------------+------+-----+---------+-------+
| Field | Type | Null | Key | Default | Extra |
+----------+---------------+------+-----+---------+-------+
| age | int(3) | YES | | | |
| ename | varchar(20) | YES | | | |
| birth | date | YES | | | |
| hiredate | date | YES | | | |
| sal | decimal(10,2) | YES | | | |
| deptno | int(2) | YES | | | |
+----------+---------------+------+-----+---------+-------+
6 rows in set (0.00 sec)
```
## MySQL表记录
### 插入记录
表创建好后,就可以往里插入记录了,MySQL 表中使用 **INSERT INTO** SQL语句来插入数据。
插入记录的基本语法如下:
```mysql
INSERT INTO table_name (field1,field2,……fieldn)
VALUES
(value1,value2,……valuesn);
```
如果数据是字符型,必须使用单引号或者双引号,如:"value"。
例如,向表 emp 中插入以下记录:
ename 为 zzx1,hiredate 为 2000-01-01,sal 为 2000,deptno 为 1,命令执行如下:
```mysql
mysql> insert into emp (ename,hiredate,sal,deptno) values('zzx1','2000-01-01','2000',1);
Query OK, 1 row affected (0.00 sec)
```
也可以不用指定字段名称,但是 values 后面的顺序应该和字段的排列顺序一致:
```mysql
mysql> insert into emp values('lisa','2003-02-01','3000',2);
Query OK, 1 row affected (0.00 sec)
```
对于含可空字段、非空但是含有默认值的字段、自增字段,可以不用在 insert 后的字段列表 里面出现,values 后面只写对应字段名称的 value,这些没写的字段可以自动设置为 NULL、 默认值、自增的下一个数字,这样在某些情况下可以大大缩短 SQL 语句的复杂性。
例如,只对表中的 ename 和 sal 字段显式插入值:
```mysql
mysql> insert into emp (ename,sal) values('dony',1000);
Query OK, 1 row affected (0.00 sec)
```
来查看一下实际插入值:
```mysql
mysql> select * from emp;
+--------+------------+---------+--------+
| ename | hiredate | sal | deptno |
+--------+------------+---------+--------+
| zzx | 2000-01-01 | 100.00 | 1 |
| lisa | 2003-02-01 | 400.00 | 2 |
| bjguan | 2004-04-02 | 100.00 | 1 |
| dony | NULL | 1000.00 | NULL |
+--------+------------+---------+--------+
```
果然,设置为可空的两个字段都显示为 NULL。
### 批量插入记录
在 MySQL 中,insert 语句还有一个很好的特性,可以一次性插入多条记录,语法如下:
```mysql
INSERT INTO table_name (field1, field2,……fieldn)
VALUES
(record1_value1, record1_value2,……record1_valuesn),
(record2_value1, record2_value2,……record2_valuesn),
……
(recordn_value1, recordn_value2,……recordn_valuesn) ;
```
可以看出,每条记录之间都用逗号进行了分隔。
下面的例子中,对表 dept 一次插入两条记录:
```mysql
mysql> insert into dept values(5,'dept5'),(6,'dept6');
Query OK, 2 rows affected (0.04 sec)
Records: 2 Duplicates: 0 Warnings: 0
mysql> select * from dept;
+--------+----------+
| deptno | deptname |
+--------+----------+
| 1 | tech |
| 2 | sale |
| 5 | fin |
| 5 | dept5 |
| 6 | dept6 |
+--------+----------+
5 rows in set (0.00 sec)
```
这个特性可以使得 MySQL 在插入大量记录时,节省很多的网络开销,大大提高插入效率。
### 更新记录
对于表里的记录值,可以通过 update 命令进行更改,语法如下:
```mysql
UPDATE tablename
SET field1=new-value1,
field2=new-value2,
……
fieldn=new-valuen
[WHERE CONDITION]
```
例如,将表 emp 中 ename 为“lisa”的薪水(sal)从 3000 更改为 4000:
```mysql
mysql> update emp set sal=4000 where ename='lisa';
Query OK, 1 row affected (0.00 sec)
Rows matched: 1 Changed: 1 Warnings: 0
```
### 更新多张表记录
在 MySQL 中,update 命令可以同时更新多个表中数据,语法如下:
```mysql
UPDATE t1,t2…tn
SET t1.field1=expr1,
tn.fieldn=exprn
[WHERE CONDITION]
```
在下例中,同时更新表 emp 中的字段 sal 和表 dept 中的字段 deptname:
```mysql
mysql> select * from emp;
+--------+------------+---------+--------+
| ename | hiredate | sal | deptno |
+--------+------------+---------+--------+
| zzx | 2000-01-01 | 100.00 | 1 |
| lisa | 2003-02-01 | 200.00 | 2 |
| bjguan | 2004-04-02 | 100.00 | 1 |
| dony | 2005-02-05 | 2000.00 | 4 |
+--------+------------+---------+--------+
4 rows in set (0.00 sec)
mysql> select * from dept;
+--------+----------+
| deptno | deptname |
+--------+----------+
| 1 | tech |
| 2 | sale |
| 5 | fin |
+--------+----------+
3 rows in set (0.00 sec)
mysql> update emp a,dept b set a.sal=a.sal*b.deptno,b.deptname=a.ename where
a.deptno=b.deptno;
Query OK, 3 rows affected (0.04 sec)
Rows matched: 5 Changed: 3 Warnings: 0
mysql> select * from emp;
+--------+------------+---------+--------+
| ename | hiredate | sal | deptno |
+--------+------------+---------+--------+
| zzx | 2000-01-01 | 100.00 | 1 |
| lisa | 2003-02-01 | 400.00 | 2 |
| bjguan | 2004-04-02 | 100.00 | 1 |
| dony | 2005-02-05 | 2000.00 | 4 |
+--------+------------+---------+--------+
4 rows in set (0.01 sec)
mysql> select * from dept;
+--------+----------+
| deptno | deptname |
+--------+----------+
| 1 | zzx |
| 2 | lisa |
| 5 | fin |
+--------+----------+
3 rows in set (0.00 sec)
```
自此,两个表的数据同时进行了更新。
注意:多表更新的语法更多地用在了根据一个表的字段,来动态的更新另外一个表的字段
### 删除记录
如果记录不再需要,可以用 delete 命令进行删除,语法如下:
```mysql
DELETE FROM tablename [WHERE CONDITION]
```
例如,在 emp中将 ename 为‘dony’的记录全部删除,命令如下:
```mysql
mysql> delete from emp where ename='dony';
Query OK, 1 row affected (0.00 sec)
```
### 批量删除多张表记录
在 MySQL 中可以一次删除多个表的数据,语法如下:
```mysql
DELETE t1,t2…tn FROM t1,t2…tn [WHERE CONDITION]
```
如果 from 后面的表名用别名,则 delete 后面的也要用相应的别名,否则会提示语法错误。 在下例中,将表 emp和 dept 中 deptno 为 3 的记录同时都删除:
```mysql
mysql> select * from emp;
+--------+------------+---------+--------+
| ename | hiredate | sal | deptno |
+--------+------------+---------+--------+
| zzx | 2000-01-01 | 100.00 | 1 |
| lisa | 2003-02-01 | 200.00 | 2 |
| bjguan | 2004-04-02 | 100.00 | 1 |
| bzshen | 2005-04-01 | 300.00 | 3 |
| dony | 2005-02-05 | 2000.00 | 4 |
+--------+------------+---------+--------+
5 rows in set (0.00 sec)
mysql> select * from dept;
+--------+----------+
| deptno | deptname |
+--------+----------+
| 1 | tech |
| 2 | sale |
| 3 | hr |
| 5 | fin |
+--------+----------+
4 rows in set (0.00 sec)
mysql> delete a,b from emp a,dept b where a.deptno=b.deptno and a.deptno=3;
Query OK, 2 rows affected (0.04 sec)
mysql> select * from emp;
+--------+------------+---------+--------+
| ename | hiredate | sal | deptno |
+--------+------------+---------+--------+
| zzx | 2000-01-01 | 100.00 | 1 |
| lisa | 2003-02-01 | 200.00 | 2 |
| bjguan | 2004-04-02 | 100.00 | 1 |
| dony | 2005-02-05 | 2000.00 | 4 |
+--------+------------+---------+--------+
4 rows in set (0.00 sec)
mysql> select * from dept;
+--------+----------+
| deptno | deptname |
+--------+----------+
| 1 | tech |
| 2 | sale |
| 5 | fin |
+--------+----------+
3 rows in set (0.00 sec)
```
**注意**:不管是单表还是多表,不加 where条件将会把表的所有记录删除,所以操作时一定要小心。
### 查询记录
数据插入到数据库中后,就可以用 SELECT 命令进行各种各样的查询,使得输出的结果符合 我们的要求。由于 SELECT 的语法很复杂,所有这里只介绍最基本的语法:
```mysql
SELECT * FROM tablename [WHERE CONDITION]
```
查询最简单的方式是将记录全部选出,在下面的例子中,将表 emp中的记录全部查询出来:
```mysql
mysql> select * from emp;
+--------+------------+---------+--------+
| ename | hiredate | sal | deptno |
+--------+------------+---------+--------+
| zzx | 2000-01-01 | 2000.00 | 1 |
| lisa | 2003-02-01 | 4000.00 | 2 |
| bjguan | 2004-04-02 | 5000.00 | 3 |
+--------+------------+---------+--------+
3 rows in set (0.00 sec)
```
其中“*”表示要将所有的记录都选出来,也可以用逗号分割的所有字段来代替,例如,以 下两个查询是等价的:
```mysql
mysql> select * from emp;
+--------+------------+---------+--------+
| ename | hiredate | sal | deptno |
+--------+------------+---------+--------+
| zzx | 2000-01-01 | 2000.00 | 1 |
| lisa | 2003-02-01 | 4000.00 | 2 |
| bjguan | 2004-04-02 | 5000.00 | 3 |
+--------+------------+---------+--------+
3 rows in set (0.00 sec)
mysql> select ename,hiredate,sal,deptno from emp;
+--------+------------+---------+--------+
| ename | hiredate | sal | deptno |
+--------+------------+---------+--------+
| zzx | 2000-01-01 | 2000.00 | 1 |
| lisa | 2003-02-01 | 4000.00 | 2 |
| bjguan | 2004-04-02 | 5000.00 | 3 |
+--------+------------+---------+--------+
3 rows in set (0.00 sec)
```
“*”的好处是当需要查询所有字段信息时候,查询语句很简单,但是要只查询部分字段的 时候,必须要将字段一个一个列出来。
上例中已经介绍了查询全部记录的语法,但是在实际应用中,用户还会遇到各种各样的查询 要求,下面将分别介绍。
#### 查询不重复的记录distinct
有时需要将表中的记录去掉重复后显示出来,可以用distinct 关键字来实现:
```mysql
mysql> select ename,hiredate,sal,deptno from emp;
+--------+------------+---------+--------+
| ename | hiredate | sal | deptno |
+--------+------------+---------+--------+
| zzx | 2000-01-01 | 2000.00 | 1 |
| lisa | 2003-02-01 | 4000.00 | 2 |
| bjguan | 2004-04-02 | 5000.00 | 1 |
+--------+------------+---------+--------+
3 rows in set (0.00 sec)
mysql> select distinct deptno from emp;
+--------+
| deptno |
+--------+
| 1 |
| 2 |
+--------+
2 rows in set (0.00 sec)
```
#### 条件查询where
在很多情况下,用户并不需要查询所有的记录,而只是需要根据限定条件来查询一部分数据, 用 where 关键字可以来实现这样的操作。
例如,需要查询所有 deptno为 1 的记录:
```mysql
mysql> select * from emp;
+--------+------------+---------+--------+
| ename | hiredate | sal | deptno |
+--------+------------+---------+--------+
| zzx | 2000-01-01 | 2000.00 | 1 |
| lisa | 2003-02-01 | 4000.00 | 2 |
| bjguan | 2004-04-02 | 5000.00 | 1 |
+--------+------------+---------+--------+
3 rows in set (0.00 sec)
mysql> select * from emp where deptno=1;
+--------+------------+---------+--------+
| ename | hiredate | sal | deptno |
+--------+------------+---------+--------+
| zzx | 2000-01-01 | 2000.00 | 1 |
| bjguan | 2004-04-02 | 5000.00 | 1 |
+--------+------------+---------+--------+
2 rows in set (0.00 sec)
```
结果集中将符合条件的记录列出来。
上面的例子中,where 后面的条件是一个字段的‘=’ 比较,除了‘=’外,还可以使用>、<、>=、<=、!=等比较运算符;多个条件之间还可以使 用 or、and 等逻辑运算符进行多条件联合查询,运算符会在以后详细讲解。
以下是一个使用多字段条件查询的例子:
```mysql
mysql> select * from emp where deptno=1 and sal<3000;
+-------+------------+---------+--------+
| ename | hiredate | sal | deptno |
+-------+------------+---------+--------+
| zzx | 2000-01-01 | 2000.00 | 1 |
+-------+------------+---------+--------+
1 row in set (0.00 sec)
```
#### 排序ORDER BY
我们经常会有这样的需求,取出按照某个字段进行排序后的记录结果集,这就用到了数据库 的排序操作,用关键字 ORDER BY 来实现,语法如下:
```mysql
SELECT * FROM tablename
[WHERE CONDITION]
[ORDER BY field1 [DESC|ASC],field2 [DESC|ASC],……fieldn [DESC|ASC]]
```
其中,DESC 和 ASC 是排序顺序关键字,DESC 表示按照字段进行降序排列,ASC 则表示升序 排列,如果不写此关键字默认是升序排列。ORDER BY 后面可以跟多个不同的排序字段,并 且每个排序字段可以有不同的排序顺序。
例如,把 emp表中的记录按照工资高低进行显示:
```mysql
mysql> select * from emp order by sal;
+--------+------------+---------+--------+
| ename | hiredate | sal | deptno |
+--------+------------+---------+--------+
| zzx | 2000-01-01 | 2000.00 | 1 |
| bzshen | 2005-04-01 | 3000.00 | 3 |
| lisa | 2003-02-01 | 4000.00 | 2 |
| bjguan | 2004-04-02 | 5000.00 | 1 |
+--------+------------+---------+--------+
4 rows in set (0.00 sec)
```
如果排序字段的值一样,则值相同的字段按照第二个排序字段进行排序,以此类推。如果只 有一个排序字段,则这些字段相同的记录将会无序排列。
例如,把 emp表中的记录按照部门编号 deptno 字段排序:
```mysql
mysql> select * from emp order by deptno;
+--------+------------+---------+--------+
| ename | hiredate | sal | deptno |
+--------+------------+---------+--------+
| zzx | 2000-01-01 | 2000.00 | 1 |
| bjguan | 2004-04-02 | 5000.00 | 1 |
| lisa | 2003-02-01 | 4000.00 | 2 |
| bzshen | 2005-04-01 | 4000.00 | 3 |
+--------+------------+---------+--------+
4 rows in set (0.00 sec)
```
对于 deptno相同的前两条记录,如果要按照工资由高到低排序,可以使用以下命令:
```mysql
mysql> select * from emp order by deptno,sal desc;
+--------+------------+---------+--------+
| ename | hiredate | sal | deptno |
+--------+------------+---------+--------+
| bjguan | 2004-04-02 | 5000.00 | 1 |
| zzx | 2000-01-01 | 2000.00 | 1 |
| lisa | 2003-02-01 | 4000.00 | 2 |
| bzshen | 2005-04-01 | 4000.00 | 3 |
+--------+------------+---------+--------+
4 rows in set (0.00 sec)
```
#### 限制LIMIT
对于排序后的记录,如果希望只显示一部分,而不是全部,这时,就可以使用 LIMIT 关键字 来实现,LIMIT 的语法如下:
```mysql
SELECT ……[LIMIT offset_start,row_count]
```
其中 offset_start 表示记录的起始偏移量,row_count 表示显示的行数。
在默认情况下,起始偏移量为 0,只需要写记录行数就可以,这时候,显示的实际就是前 n 条记录,看下面例子:
例如,显示 emp 表中按照 sal 排序后的前 3 条记录:
```mysql
mysql> select * from emp order by sal limit 3;
+--------+------------+---------+--------+
| ename | hiredate | sal | deptno |
+--------+------------+---------+--------+
| zzx | 2000-01-01 | 2000.00 | 1 |
| lisa | 2003-02-01 | 4000.00 | 2 |
| bzshen | 2005-04-01 | 4000.00 | 3 |
+--------+------------+---------+--------+
3 rows in set (0.00 sec)
```
如果要显示 emp 表中按照 sal 排序后从第二条记录开始,显示 3 条记录:
```mysql
mysql> select * from emp order by sal limit 1,3;
+--------+------------+---------+--------+
| ename | hiredate | sal | deptno |
+--------+------------+---------+--------+
| lisa | 2003-02-01 | 4000.00 | 2 |
| bzshen | 2005-04-01 | 4000.00 | 3 |
| bjguan | 2004-04-02 | 5000.00 | 1 |
+--------+------------+---------+--------+
3 rows in set (0.00 sec)
```
limit 经常和 order by 一起配合使用来进行记录的分页显示。
注意:limit属于MySQL扩展 SQL92 后的语法,在其他数据库上并不能通用。
#### 聚合
很多情况下,我们需要进行一些汇总操作,比如统计整个公司的人数或者统计每个部门的人数,这个时就要用到 SQL 的聚合操作。
聚合操作的语法如下:
```mysql
SELECT [field1,field2,……fieldn] fun_name
FROM tablename
[WHERE where_contition]
[GROUP BY field1,field2,……fieldn
[WITH ROLLUP]]
[HAVING where_contition]
```
对其参数进行以下说明。
fun_name 表示要做的聚合操作,也就是聚合函数,常用的有 sum(求和)、count(*)(记 录数)、max(最大值)、min(最小值)。
GROUP BY 关键字表示要进行分类聚合的字段,比如要按照部门分类统计员工数量,部门 就应该写在 group by 后面。
WITH ROLLUP 是可选语法,表明是否对分类聚合后的结果进行再汇总。
HAVING 关键字表示对分类后的结果再进行条件的过滤。
注意:having 和 where 的区别在于 having 是对聚合后的结果进行条件的过滤,而 where 是在聚 合前就对记录进行过滤,如果逻辑允许,我们尽可能用 where先过滤记录,这样因为结果 集减小,将对聚合的效率大大提高,最后再根据逻辑看是否用having进行再过滤
例如,要 emp表中统计公司的总人数:
```mysql
mysql> select count(1) from emp;
+----------+
| count(1) |
+----------+
| 4 |
+----------+
1 row in set (0.00 sec)
```
在此基础上,要统计各个部门的人数:
```mysql
mysql> select deptno,count(1) from emp group by deptno;
+--------+----------+
| deptno | count(1) |
+--------+----------+
| 1 | 2 |
| 2 | 1 |
| 4 | 1 |
+--------+----------+
3 rows in set (0.00 sec)
```
更细一些,既要统计各部门人数,又要统计总人数:
```mysql
mysql> select deptno,count(1) from emp group by deptno with rollup;
+--------+----------+
| deptno | count(1) |
+--------+----------+
| 1 | 2 |
| 2 | 1 |
| 4 | 1 |
| NULL | 4 |
+--------+----------+
4 rows in set (0.00 sec)
```
统计人数大于 1 人的部门:
```mysql
mysql> select deptno,count(1) from emp group by deptno having count(1)>1;
+--------+----------+
| deptno | count(1) |
+--------+----------+
| 1 | 2 |
+--------+----------+
1 row in set (0.00 sec)
```
最后统计公司所有员工的薪水总额、最高和最低薪水:
```mysql
mysql> select * from emp;
+--------+------------+---------+--------+
| ename | hiredate | sal | deptno |
+--------+------------+---------+--------+
| zzx | 2000-01-01 | 100.00 | 1 |
| lisa | 2003-02-01 | 400.00 | 2 |
| bjguan | 2004-04-02 | 100.00 | 1 |
| dony | 2005-02-05 | 2000.00 | 4 |
+--------+------------+---------+--------+
4 rows in set (0.00 sec)
mysql> select sum(sal),max(sal),min(sal) from emp;
+----------+----------+----------+
| sum(sal) | max(sal) | min(sal) |
+----------+----------+----------+
| 2600.00 | 2000.00 | 100.00 |
+----------+----------+----------+
1 row in set (0.00 sec)
```
## MySQL表连接
当需要同时显示多个表中的字段时,就可以用表连接来实现这样的功能。
JOIN 按照功能大致分为如下三类:
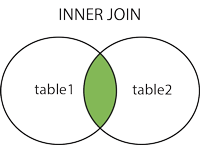
- **INNER JOIN(内连接,或等值连接)**:获取两个表中字段匹配关系的记录。
- **LEFT JOIN(左连接):**获取左表所有记录,即使右表没有对应匹配的记录。
- **RIGHT JOIN(右连接):** 与 LEFT JOIN 相反,用于获取右表所有记录,即使左表没有对应匹配的记录。
### INNER JOIN
从大类上分,表连接分为内连接和外连接,它们之间的最主要区别是內连接仅选出两张表中 互相匹配的记录,而外连接会选出其他不匹配的记录。我们最常用的是内连接。
例如,查询出所有雇员的名字和所在部门名称,因为雇员名称和部门分别存放在表 emp 和 dept 中,因此,需要使用表连接来进行查询:
```mysql
mysql> select * from emp;
+--------+------------+---------+--------+
| ename | hiredate | sal | deptno |
+--------+------------+---------+--------+
| zzx | 2000-01-01 | 2000.00 | 1 |
| lisa | 2003-02-01 | 4000.00 | 2 |
| bjguan | 2004-04-02 | 5000.00 | 1 |
| bzshen | 2005-04-01 | 4000.00 | 3 |
+--------+------------+---------+--------+
4 rows in set (0.00 sec)
mysql> select * from dept;
+--------+----------+
| deptno | deptname |
+--------+----------+
| 1 | tech |
| 2 | sale |
| 3 | hr |
+--------+----------+
3 rows in set (0.00 sec)
mysql> select ename,deptname from emp,dept where emp.deptno=dept.deptno;
+--------+----------+
| ename | deptname |
+--------+----------+
| zzx | tech |
| lisa | sale |
| bjguan | tech |
| bzshen | hr |
+--------+----------+
4 rows in set (0.00 sec)
```
外连接有分为左连接和右连接,具体定义如下。
左连接:包含所有的左边表中的记录甚至是右边表中没有和它匹配的记录
右连接:包含所有的右边表中的记录甚至是左边表中没有和它匹配的记录
### LEFT JOIN
MySQL left join 与 join 有所不同。 MySQL LEFT JOIN 会读取左边数据表的全部数据,即便右边表无对应数据。
例如,查询 emp 中所有用户名和所在部门名称:

```mysql
mysql> select * from emp;
+--------+------------+---------+--------+
| ename | hiredate | sal | deptno |
+--------+------------+---------+--------+
| zzx | 2000-01-01 | 2000.00 | 1 |
| lisa | 2003-02-01 | 4000.00 | 2 |
| bjguan | 2004-04-02 | 5000.00 | 1 |
| bzshen | 2005-04-01 | 4000.00 | 3 |
| dony | 2005-02-05 | 2000.00 | 4 |
+--------+------------+---------+--------+
5 rows in set (0.00 sec)
mysql> select * from dept;
+--------+----------+
| deptno | deptname |
+--------+----------+
| 1 | tech |
| 2 | sale |
| 3 | hr |
+--------+----------+
3 rows in set (0.00 sec)
mysql> select ename,deptname from emp left join dept on emp.deptno=dept.deptno;
+--------+----------+
| ename | deptname |
+--------+----------+
| zzx | tech |
| lisa | sale |
| bjguan | tech |
| bzshen | hr |
| dony | |
+--------+----------+
5 rows in set (0.00 sec)
```
比较这个查询和上例中的查询,都是查询用户名和部门名,两者的区别在于本例中列出了所 有的用户名,即使有的用户名(dony)并不存在合法的部门名称(部门号为 4,在 dept 中 没有这个部门);而上例中仅仅列出了存在合法部门的用户名和部门名称。
### RIGHT JOIN
MySQL RIGHT JOIN 会读取右边数据表的全部数据,即便左边边表无对应数据。
右连接和左连接类似,两者之间可以互相转化,例如,上面的例子可以改写为如下的右连接:

```mysql
mysql> select ename,deptname from dept right join emp on dept.deptno=emp.deptno;
+--------+----------+
| ename | deptname |
+--------+----------+
| zzx | tech |
| lisa | sale |
| bjguan | tech |
| bzshen | hr |
| dony | |
+--------+----------+
5 rows in set (0.00 sec)
```
## MySQL子查询
某些情况下,当我们查询的时候,需要的条件是另外一个 select 语句的结果,这个时候,就 要用到子查询。用于子查询的关键字主要包括 in、not in、=、!=、exists、not exists 等。
例如,从 emp表中查询出所有部门在 dept 表中的所有记录:
```mysql
mysql> select * from emp;
+--------+------------+---------+--------+
| ename | hiredate | sal | deptno |
+--------+------------+---------+--------+
| zzx | 2000-01-01 | 2000.00 | 1 |
| lisa | 2003-02-01 | 4000.00 | 2 |
| bjguan | 2004-04-02 | 5000.00 | 1 |
| bzshen | 2005-04-01 | 4000.00 | 3 |
| dony | 2005-02-05 | 2000.00 | 4 |
+--------+------------+---------+--------+
5 rows in set (0.00 sec)
mysql> select * from dept;
+--------+----------+
| deptno | deptname |
+--------+----------+
| 1 | tech |
| 2 | sale |
| 3 | hr |
| 5 | fin |
+--------+----------+
4 rows in set (0.00 sec)
mysql> select * from emp where deptno in(select deptno from dept);
+--------+------------+---------+--------+
| ename | hiredate | sal | deptno |
+--------+------------+---------+--------+
| zzx | 2000-01-01 | 2000.00 | 1 |
| lisa | 2003-02-01 | 4000.00 | 2 |
| bjguan | 2004-04-02 | 5000.00 | 1 |
| bzshen | 2005-04-01 | 4000.00 | 3 |
+--------+------------+---------+--------+
4 rows in set (0.00 sec)
```
如果子查询记录数唯一,还可以用=代替 in:
```mysql
mysql> select * from emp where deptno = (select deptno from dept);
ERROR 1242 (21000): Subquery returns more than 1 row
mysql> select * from emp where deptno = (select deptno from dept limit 1);
+--------+------------+---------+--------+
| ename | hiredate | sal | deptno |
+--------+------------+---------+--------+
| zzx | 2000-01-01 | 2000.00 | 1 |
| bjguan | 2004-04-02 | 5000.00 | 1 |
+--------+------------+---------+--------+
2 rows in set (0.00 sec)
```
某些情况下,子查询可以转化为表连接,例如:
```mysql
mysql> select * from emp where deptno in(select deptno from dept);
+--------+------------+---------+--------+
| ename | hiredate | sal | deptno |
+--------+------------+---------+--------+
| zzx | 2000-01-01 | 2000.00 | 1 |
| lisa | 2003-02-01 | 4000.00 | 2 |
| bjguan | 2004-04-02 | 5000.00 | 1 |
| bzshen | 2005-04-01 | 4000.00 | 3 |
+--------+------------+---------+--------+
4 rows in set (0.00 sec)
转换为表连接后:
mysql> select emp.* from emp ,dept where emp.deptno=dept.deptno;
+--------+------------+---------+--------+
| ename | hiredate | sal | deptno |
+--------+------------+---------+--------+
| zzx | 2000-01-01 | 2000.00 | 1 |
| lisa | 2003-02-01 | 4000.00 | 2 |
| bjguan | 2004-04-02 | 5000.00 | 1 |
| bzshen | 2005-04-01 | 4000.00 | 3 |
+--------+------------+---------+--------+
4 rows in set (0.00 sec)
```
注意:子查询和表连接之间的转换主要应用在两个方面:
MySQL 4.1 以前的版本不支持子查询,需要用表连接来实现子查询的功能
表连接在很多情况下用于优化子查询
## MySQL记录联合UNION
我们经常会碰到这样的应用,将两个表的数据按照一定的查询条件查询出来后,将结果合并 到一起显示出来,这个时候,就需要用 union 和 union all 关键字来实现这样的功能,具体语法如下:
```mysql
SELECT * FROM t1
UNION|UNION ALL
SELECT * FROM t2
……
UNION|UNION ALL
SELECT * FROM tn;
```
UNION 和 UNION ALL 的主要区别是 UNION ALL 是把结果集直接合并在一起,而 UNION 是将 UNION ALL 后的结果进行一次 DISTINCT,去除重复记录后的结果。
来看下面例子,将 emp和 dept 表中的部门编号的集合显示出来:
```mysql
mysql> select * from emp;
+--------+------------+---------+--------+
| ename | hiredate | sal | deptno |
+--------+------------+---------+--------+
| zzx | 2000-01-01 | 100.00 | 1 |
| lisa | 2003-02-01 | 400.00 | 2 |
| bjguan | 2004-04-02 | 100.00 | 1 |
| dony | 2005-02-05 | 2000.00 | 4 |
+--------+------------+---------+--------+
4 rows in set (0.00 sec)
mysql> select * from dept;
+--------+----------+
| deptno | deptname |
+--------+----------+
| 1 | tech |
| 2 | sale |
| 5 | fin |
+--------+----------+
3 rows in set (0.00 sec)
3 rows in set (0.00 sec)
mysql> select deptno from emp
union all
select deptno from dept;
+--------+
| deptno |
+--------+
| 1 |
| 2 |
| 1 |
| 4 |
| 1 |
| 2 |
| 5 |
+--------+
7 rows in set (0.00 sec)
```
如果希望将结果去掉重复记录后显示:
```mysql
mysql> select deptno from emp
union
select deptno from dept;
+--------+
| deptno |
+--------+
| 1 |
| 2 |
| 4 |
| 5 |
+--------+
4 rows in set (0.00 sec)
```
**UNION 语句**:用于将不同表中相同列中查询的数据展示出来;(不包括重复数据)
**UNION ALL 语句**:用于将不同表中相同列中查询的数据展示出来;(包括重复数据)
## MySQL数据类型
每一个常量,变量和参数都有数据类型,它用来指定一定的存储格式、约束和有效范围。 MySQL 提供了多种数据类型,主要包括数值型、字符串类型、日期和时间类型。不同的 MySQL 版本支持的数据类型可能会稍有不同,用户可以通过查询相应版本的帮助文件来获得具体信 息。本章将以 MySQL 5.0 为例,详细介绍 MySQL 中的各种数据类型。
### 数值类型
MySQL支持所有标准SQL数值数据类型。
这些类型包括严格数值数据类型(INTEGER、SMALLINT、DECIMAL和NUMERIC),以及近似数值数据类(FLOAT、REAL和DOUBLE PRECISION)。
关键字INT是INTEGER的同义词,关键字DEC是DECIMAL的同义词。
作为SQL标准的扩展,扩展后增加了 TINYINT、MEDIUMINT 和 BIGINT 这 3 种长度不同的整型,并增加了 BIT 类 型,用来存放位数据。
BIT数据类型保存位字段值,并且支持MyISAM、MEMORY、InnoDB和BDB表。
下面的表列出了 MySQL 5.0 中支持的所有数值类型
| 类型 | 大小 | 范围(有符号) | 范围(无符号) | 用途 |
| :----------- | :--------------------------------------- | :----------------------------------------------------------- | :----------------------------------------------------------- | :-------------- |
| TINYINT | 1 字节 | (-128,127) | (0,255) | 小整数值 |
| SMALLINT | 2 字节 | (-32 768,32 767) | (0,65 535) | 大整数值 |
| MEDIUMINT | 3 字节 | (-8 388 608,8 388 607) | (0,16 777 215) | 大整数值 |
| INT或INTEGER | 4 字节 | (-2 147 483 648,2 147 483 647) | (0,4 294 967 295) | 大整数值 |
| BIGINT | 8 字节 | (-9,223,372,036,854,775,808,9 223 372 036 854 775 807) | (0,18 446 744 073 709 551 615) | 极大整数值 |
| FLOAT | 4 字节 | (-3.402 823 466 E+38,-1.175 494 351 E-38),0,(1.175 494 351 E-38,3.402 823 466 351 E+38) | 0,(1.175 494 351 E-38,3.402 823 466 E+38) | 单精度 浮点数值 |
| DOUBLE | 8 字节 | (-1.797 693 134 862 315 7 E+308,-2.225 073 858 507 201 4 E-308),0,(2.225 073 858 507 201 4 E-308,1.797 693 134 862 315 7 E+308) | 0,(2.225 073 858 507 201 4 E-308,1.797 693 134 862 315 7 E+308) | 双精度 浮点数值 |
| DECIMAL | 对DECIMAL(M,D) ,如果M>D,为M+2否则为D+2 | 依赖于M和D的值 | 依赖于M和D的值 | 小数值 |
在整数类型中,按照取值范围和存储方式不同,分为 tinyint、smallint、mediumint、int、 bigint 这 5 个类型。如果超出类型范围的操作,会发生“Out of range”错误提示。
为了避免此类问题发生,在选择数据类型时要根据应用的实际情况确定其取值范围,最后根据确定的结 果慎重选择数据类型。
对于整型数据,MySQL 还支持在类型名称后面的小括号内指定显示宽度,例如 int(5)表 示当数值宽度小于 5 位的时候在数字前面填满宽度,如果不显示指定宽度则默认为 int(11)。
一般配合 zerofill 使用,顾名思义,zerofill 就是用“0”填充的意思,也就是在数字位数不够 的空间用字符“0”填满。以下几个例子分别描述了填充前后的区别。
创建表 t1,有 id1 和 id2两个字段,指定其数值宽度分别为 int 和 int(5)。
```mysql
mysql> create table t1 (id1 int,id2 int(5));
Query OK, 0 rows affected (0.03 sec)
mysql> desc t1;
+-------+---------+------+-----+---------+-------+
| Field | Type | Null | Key | Default | Extra |
+-------+---------+------+-----+---------+-------+
| id1 | int(11) | YES | | NULL | |
| id2 | int(5) | YES | | NULL | |
+-------+---------+------+-----+---------+-------+
2 rows in set (0.00 sec)
```
在 id1 和 id2 中都插入数值 1,可以发现格式没有异常。
```mysql
mysql> insert into t1 values(1,1);
Query OK, 1 row affected (0.00 sec)
mysql> select * from t1;
+------+------+
| id1 | id2 |
+------+------+
| 1 | 1 |
+------+------+ 1 row in set (0.00 sec)
```
分别修改 id1和 id2 的字段类型,加入 zerofill 参数:
```mysql
mysql> alter table t1 modify id1 int zerofill;
Query OK, 1 row affected (0.04 sec)
Records: 1 Duplicates: 0 Warnings: 0
mysql> alter table t1 modify id2 int(5) zerofill;
Query OK, 1 row affected (0.03 sec)
Records: 1 Duplicates: 0 Warnings: 0
mysql> select * from t1;
+------------+-------+
| id1 | id2 |
+------------+-------+
| 0000000001 | 00001 |
+------------+-------+
1 row in set (0.00 sec)
```
可以发现,在数值前面用字符“0”填充了剩余的宽度。
大家可能会有所疑问,设置了宽度限制后,如果插入大于宽度限制的值,会不会截断或者插不进去报错?
答案是肯定的:不会 对插入的数据有任何影响,还是按照类型的实际精度进行保存,这是,宽度格式实际已经没 有意义,左边不会再填充任何的“0”字符。
下面在表 t1 的字段 id1中插入数值 1,id2 中插 入数值 1111111,位数为 7,大于 id2的显示位数 5,再观察一下测试结果:
```mysql
mysql> insert into t1 values(1,1111111);
Query OK, 1 row affected (0.00 sec)
mysql> select * from t1;
+------------+---------+
| id1 | id2 |
+------------+---------+
| 0000000001 | 00001 |
| 0000000001 | 1111111 |
+------------+---------+
2 rows in set (0.00 sec)
```
很显然,如上面所说,id2 中显示了正确的数值,并没有受宽度限制影响。
所有的整数类型都有一个可选属性 UNSIGNED(无符号),如果需要在字段里面保存非负数或者需要较大的上限值时,可以用此选项,它的取值范围是正常值的下限取 0,上限取 原值的 2 倍,例如,tinyint 有符号范围是-128~+127,而无符号范围是 0~255。如果一个列 指定为 zerofill,则 MySQL 自动为该列添加 UNSIGNED属性。
另外,整数类型还有一个属性:AUTO_INCREMENT。
在需要产生唯一标识符或顺序值时, 可利用此属性,这个属性只用于整数类型。
AUTO_INCREMENT 值一般从 1 开始,每行增加 1。 在插入 NULL 到一个 AUTO_INCREMENT 列时,MySQL 插入一个比该列中当前最大值大 1 的 值。一个表中最多只能有一个AUTO_INCREMENT列。对于任何想要使用AUTO_INCREMENT 的 列,应该定义为 NOT NULL,并定义为 PRIMARY KEY或定义为 UNIQUE 键。例如,可按下列 任何一种方式定义 AUTO_INCREMENT 列:
```mysql
CREATE TABLE AI (ID INT AUTO_INCREMENT NOT NULL PRIMARY KEY);
CREATE TABLE AI (ID INT AUTO_INCREMENT NOT NULL ,PRIMARY KEY(ID));
CREATE TABLE AI (ID INT AUTO_INCREMENT NOT NULL ,UNIQUE(ID));
```
对于小数的表示,MySQL 分为两种方式:浮点数和定点数。
浮点数包括 float(单精度) 和 double(双精度),而定点数则只有 decimal 一种表示。
定点数在 MySQL 内部以字符串形 式存放,比浮点数更精确,适合用来表示货币等精度高的数据。
浮点数和定点数都可以用类型名称后加“(M,D)”的方式来进行表示,“(M,D)”表示该 值一共显示M 位数字(整数位+小数位) ,其中 D 位位于小数点后面,M 和 D 又称为精度和 标度。
例如,定义为 float(7,4)的一个列可以显示为-999.9999。MySQL 保存值时进行四舍五 入,因此如果在 float(7,4)列内插入 999.00009,近似结果是 999.0001。值得注意的是,浮点 数后面跟“(M,D)”的用法是非标准用法,如果要用于数据库的迁移,则最好不要这么使用。
float 和 double 在不指定精度时,默认会按照实际的精度(由实际的硬件和操作系统决定) 来显示,而 decimal 在不指定精度时,默认的整数位为 10,默认的小数位为 0。
下面通过一个例子来比较 float、double 和 decimal 三者之间的不同。
创建测试表,分别将 id1、id2、id3 字段设置为 float(5,2)、double(5,2)、decimal(5,2)。
```mysql
CREATE TABLE `t1` (
`id1` float(5,2) default NULL,
`id2` double(5,2) default NULL,
`id3` decimal(5,2) default NULL
)
```
往 id1、id2 和 id3 这 3 个字段中插入数据 1.23
```mysql
mysql> insert into t1 values(1.23,1.23,1.23);
Query OK, 1 row affected (0.00 sec)
mysql>
mysql> select * from t1;
+------+------+------+
| id1 | id2 | id3 |
+------+------+------+
| 1.23 | 1.23 | 1.23 |
+------+------+------+
1 row in set (0.00 sec)
```
可以发现,数据都正确地插入了表 t1。
再向 id1 和 id2 字段中插入数据 1.234,而 id3 字段中仍然插入 1.23
```mysql
mysql> insert into t1 values(1.234,1.234,1.23);
Query OK, 1 row affected (0.00 sec)
mysql> select * from t1;
+------+------+------+
| id1 | id2 | id3 |
+------+------+------+
| 1.23 | 1.23 | 1.23 |
| 1.23 | 1.23 | 1.23 |
+------+------+------+
2 rows in set (0.00 sec)
```
可以发现,id1、id2、id3 都插入了表 t1,但是 id1 和 id2 由于标度的限制,舍去了最后一位, 数据变为了 1.23。
同时向 id1、id2、id3 字段中都插入数据 1.234
```mysql
mysql> insert into t1 values(1.234,1.234,1.234);
Query OK, 1 row affected, 1 warning (0.00 sec)
mysql> show warnings;
+-------+------+------------------------------------------+
| Level | Code | Message |
+-------+------+------------------------------------------+
| Note | 1265 | Data truncated for column 'id3' at row 1 |
+-------+------+------------------------------------------+
1 row in set (0.00 sec)
mysql> select * from t1;
+------+------+------+
| id1 | id2 | id3 |
+------+------+------+
| 1.23 | 1.23 | 1.23 |
| 1.23 | 1.23 | 1.23 |
| 1.23 | 1.23 | 1.23 |
+------+------+------+
3 rows in set (0.00 sec)
```
此时发现,虽然数据都插入进去,但是系统出现了一个 warning,报告 id3 被截断。如果是 在传统的 SQLMode(第 16 章将会详细介绍 SQLMode)下,这条记录是无法插入的
将 id1、id2、id3 字段的精度和标度全部去掉,再次插入数据 1.23
```mysql
mysql> alter table t1 modify id1 float;
Query OK, 3 rows affected (0.03 sec)
Records: 3 Duplicates: 0 Warnings: 0
mysql> alter table t1 modify id2 double;
Query OK, 3 rows affected (0.04 sec)
Records: 3 Duplicates: 0 Warnings: 0
mysql> alter table t1 modify id3 decimal;
Query OK, 3 rows affected, 3 warnings (0.02 sec)
Records: 3 Duplicates: 0 Warnings: 0
mysql> desc t1;
+-------+---------------+------+-----+---------+-------+
| Field | Type | Null | Key | Default | Extra |
+-------+---------------+------+-----+---------+-------+
| id1 | float | YES | | NULL | |
| id2 | double | YES | | NULL | |
| id3 | decimal(10,0) | YES | | NULL | |
+-------+---------------+------+-----+---------+-------+
3 rows in set (0.00 sec)
mysql> insert into t1 values(1.234,1.234,1.234);
Query OK, 1 row affected, 1 warning (0.00 sec)
mysql> show warnings;
+-------+------+------------------------------------------+
| Level | Code | Message |
+-------+------+------------------------------------------+
| Note | 1265 | Data truncated for column 'id3' at row 1 |
+-------+------+------------------------------------------+
1 row in set (0.00 sec)
mysql> select * from t1;
+-------+-------+------+
| id1 | id2 | id3 |
+-------+-------+------+
| 1.234 | 1.234 | 1 |
+-------+-------+------+
1 row in set (0.00 sec)
```
这个时候,可以发现 id1、id2字段中可以正常插入数据,而 id3 字段的小数位被截断。
上面这个例子验证了上面提到的浮点数如果不写精度和标度,则会按照实际精度值显示,如 果有精度和标度,则会自动将四舍五入后的结果插入,系统不会报错;定点数如果不写精度 和标度,则按照默认值 decimal(10,0)来进行操作,并且如果数据超越了精度和标度值,系统 则会报错。
对于 BIT(位)类型,用于存放位字段值,BIT(M)可以用来存放多位二进制数,M 范围从 1~ 64,如果不写则默认为 1 位。对于位字段,直接使用 SELECT 命令将不会看到结果,可以用 bin()(显示为二进制格式)或者 hex()(显示为十六进制格式)函数进行读取。
下面的例子中,对测试表t2 中的 bit 类型字段 id 做 insert 和 select 操作,这里重点观察一下 select 的结果:
```mysql
mysql> desc t2;
+-------+--------+------+-----+---------+-------+
| Field | Type | Null | Key | Default | Extra |
+-------+--------+------+-----+---------+-------+
| id | bit(1) | YES | | NULL | |
+-------+--------+------+-----+---------+-------+
1 row in set (0.00 sec)
mysql> insert into t2 values(1);
Query OK, 1 row affected (0.00 sec)
mysql> select * from t2;
+------+
| id |
+------+
| |
+------+
1 row in set (0.00 sec)
```
可以发现,直接 select * 结果为 NULL。改用 bin()和 hex()函数再试试:
```mysql
mysql> select bin(id),hex(id) from t2;
+---------+---------+
| bin(id) | hex(id) |
+---------+---------+
| 1 | 1 |
+---------+---------+
1 row in set (0.00 sec)
```
结果可以正常显示为二进制数字和十六进制数字。 数据插入 bit 类型字段时,首先转换为二进制,如果位数允许,将成功插入;如果位数小于 实际定义的位数,则插入失败,下面的例子中,在 t2 表插入数字 2,因为它的二进制码是 “10”,而 id 的定义是 bit(1),将无法进行插入:
```mysql
mysql> insert into t2 values(2);
Query OK, 1 row affected, 1 warning (0.00 sec)
mysql> show warnings;
+---------+------+------------------------------------------------------+
| Level | Code | Message |
+---------+------+------------------------------------------------------+
| Warning | 1264 | Out of range value adjusted for column 'id' at row 1 |
+---------+------+------------------------------------------------------+
1 row in set (0.01 sec)
```
将 ID 定义修改为 bit(2)后,重新插入,插入成功:
```mysql
mysql> alter table t2 modify id bit(2);
Query OK, 1 row affected (0.02 sec)
Records: 1 Duplicates: 0 Warnings: 0
mysql> insert into t2 values(2);
Query OK, 1 row affected (0.00 sec)
mysql> select bin(id),hex(id) from t2;
+---------+---------+
| bin(id) | hex(id) |
+---------+---------+
| 1 | 1 |
| 10 | 2 |
+---------+---------+
2 rows in set (0.00 sec)
```
### 日期时间类型
MySQL 中有多种数据类型可以用于日期和时间的表示,不同的版本可能有所差异,表 3-2 中 列出了 MySQL 5.0 中所支持的日期和时间类型。
| 类型 | 大小 (字节) | 范围 | 格式 | 用途 |
| :-------- | :---------- | :----------------------------------------------------------- | :------------------ | :----------------------- |
| DATE | 3 | 1000-01-01/9999-12-31 | YYYY-MM-DD | 日期值 |
| TIME | 3 | '-838:59:59'/'838:59:59' | HH:MM:SS | 时间值或持续时间 |
| YEAR | 1 | 1901/2155 | YYYY | 年份值 |
| DATETIME | 8 | 1000-01-01 00:00:00/9999-12-31 23:59:59 | YYYY-MM-DD HH:MM:SS | 混合日期和时间值 |
| TIMESTAMP | 4 | 1970-01-01 00:00:00/2038结束时间是第 **2147483647** 秒,北京时间 **2038-1-19 11:14:07**,格林尼治时间 2038年1月19日 凌晨 03:14:07 | YYYYMMDD HHMMSS | 混合日期和时间值,时间戳 |
这些数据类型的主要区别如下:
如果要用来表示年月日,通常用 DATE 来表示。
如果要用来表示年月日时分秒,通常用 DATETIME 表示。
如果只用来表示时分秒,通常用 TIME 来表示。
如果需要经常插入或者更新日期为当前系统时间,则通常使用 TIMESTAMP 来表示。 TIMESTAMP 值返回后显示为“YYYY-MM-DD HH:MM:SS”格式的字符串,显示宽度固定 为 19 个字符。如果想要获得数字值,应在 TIMESTAMP 列添加+0。
如果只是表示年份,可以用 YEAR 来表示,它比 DATE 占用更少的空间。YEAR 有 2 位或 4 位格式的年。默认是 4 位格式。在 4 位格式中,允许的值是 1901~2155 和 0000。在 2 位格式中,允许的值是 70~69,表示从 1970~2069 年。MySQL 以 YYYY 格式显示 YEAR 值。
从表 3-2 中可以看出,每种日期时间类型都有一个有效值范围,如果超出这个范围,在 默认的 SQLMode 下,系统会进行错误提示,并将以零值来进行存储。不同日期类型零值的 表示如表 3-3 所示。
MySQL中日期和时间类型的零值表示 数据类型 零值表示 DATETIME 0000-00-00 00:00:00 DATE 0000-00-00 TIMESTAMP 00000000000000
Linux公社 www.linuxidc.com
64
TIME 00:00:00 YEAR 0000
DATE、TIME 和 DATETIME 是最常使用的 3 种日期类型,以下例子在 3 种类型字段插入 了相同的日期值,来看看它们的显示结果:
首先创建表 t,字段分别为 date、time、datetime 三种日期类型:
```mysql
mysql> create table t (d date,t time,dt datetime);
Query OK, 0 rows affected (0.01 sec)
mysql> desc t;
+-------+----------+------+-----+---------+-------+
| Field | Type | Null | Key | Default | Extra |
+-------+----------+------+-----+---------+-------+
| d | date | YES | | NULL | |
| t | time | YES | | NULL | |
| dt | datetime | YES | | NULL | |
+-------+----------+------+-----+---------+-------+
3 rows in set (0.01 sec)
```
用 now()函数插入当前日期:
```mysql
mysql> insert into t values(now(),now(),now());
Query OK, 1 row affected (0.00 sec)
```
查看显示结果:
```mysql
mysql> select * from t;
+------------+----------+---------------------+
| d | t | dt |
+------------+----------+---------------------+
| 2007-07-19 | 17:41:13 | 2007-07-19 17:41:13 |
+------------+----------+---------------------+
1 row in set (0.00 sec)
```
显而易见,DATETIME是DATE和TIME的组合,用户可以根据不同的需要,来选择不同的 日期或时间类型以满足不同的应用。
TIMESTAMP也用来表示日期,但是和DATETIME有所不同,后面的章节中会专门介绍。 下例对TIMESTAMP类型的特性进行一些测试。
创建测试表t,字段id1为TIMESTAMP类型:
```mysql
mysql> create table t (id1 timestamp);
Query OK, 0 rows affected (0.03 sec)
mysql> desc t;
+-------+-----------+------+-----+-------------------+-------+
| Field | Type | Null | Key | Default | Extra |
+-------+-----------+------+-----+-------------------+-------+
| id2 | timestamp | YES | | CURRENT_TIMESTAMP | |
+-------+-----------+------+-----+-------------------+-------+
1 row in set (0.00 sec)
```
可以发现,系统给 tm 自动创建了默认值 CURRENT_TIMESTAMP(系统日期) 。插入一个 NULL 值试试:
```mysql
mysql> insert into t values(null);
Query OK, 1 row affected (0.00 sec)
mysql> select * from t;
+---------------------+
| t |
+---------------------+
| 2007-07-04 16:37:24 |
+---------------------+
1 row in set (0.00 sec)
```
果然,t中正确插入了系统日期。注意,MySQL只给表中的第一个TIMESTAMP字段设置 默认值为系统日期,如果有第二个TIMESTAMP类型,则默认值设置为0值,测试如下:
```mysql
mysql> alter table t add id2 timestamp;
Query OK, 0 rows affected (0.03 sec)
Records: 0 Duplicates: 0 Warnings: 0
mysql> show create table t \G;
*************************** 1. row ***************************
Table: t
Create Table: CREATE TABLE `t` (
`id1` timestamp NOT NULL default CURRENT_TIMESTAMP,
`id2` timestamp NOT NULL default '0000-00-00 00:00:00'
) ENGINE=MyISAM DEFAULT CHARSET=gbk
1 row in set (0.00 sec))
```
当然,可以修改id2的默认值为其他常量日期,但是不能再修改为current_timestmap, 因为MySQL规定TIMESTAMP类型字段只能有一列的默认值为current_timestmap,如果强制修改,系统会报如下错误提示:
```mysql
mysql> alter table t modify id2 timestamp default current_timestamp;
ERROR 1293 (HY000): Incorrect table definition; there can be only one TIMESTAMP column with
CURRENT_TIMESTAMP in DEFAULT or ON UPDATE clause
```
TIMESTAMP还有一个重要特点,就是和时区相关。
当插入日期时,会先转换为本地时区后存放;而从数据库里面取出时,也同样需要将日期转换为本地时区后显示。这样,两个不 同时区的用户看到的同一个日期可能是不一样的,下面的例子演示了这个差别。
创建表t8,包含字段id1(TIMESTAMP)和id2(DATETIME),设置id2的目的是为 了和id1做对比:
```mysql
CREATE TABLE `t8` (
`id1` timestamp NOT NULL default CURRENT_TIMESTAMP,
`id2` datetime default NULL
)
Query OK, 0 rows affected (0.03 sec)
```
查看当前时区:
```mysql
mysql> show variables like 'time_zone';
+---------------+--------+
| Variable_name | Value |
+---------------+--------+
| time_zone | SYSTEM |
+---------------+--------+
1 row in set (0.00 sec)
```
可以发现,时区的值为“SYSTEM”,这个值默认是和主机的时区值一致的,因为我们在中国, 这里的“SYSTEM”实际是东八区(+8:00)。
用 now()函数插入当前日期:
```mysql
mysql> select * from t8;
+---------------------+---------------------+
| id1 | id2 |
+---------------------+---------------------+
| 2007-09-25 17:26:50 | 2007-09-25 17:26:50 |
+---------------------+---------------------+
1 row in set (0.01 sec)
```
结果显示 id1 和 id2 的值完全相同。
修改时区为东九区,再次查看表中日期:
```mysql
mysql> set time_zone='+9:00';
Query OK, 0 rows affected (0.00 sec)
mysql> select * from t8;
+---------------------+---------------------+
| id1 | id2 |
+---------------------+---------------------+
| 2007-09-25 18:26:50 | 2007-09-25 17:26:50 |
+---------------------+---------------------+
1 row in set (0.00 sec)
```
结果中可以发现,id1的值比id2的值快了1个小时,也就是说,东九区的人看到的“2007-09-25 18:26:50”是当地时区的实际日期,也就是东八区的“2007-09-25 17:26:50”,如果还是以 “2007-09-25 17:26:50”理解时间必然导致误差。
TIMESTAMP的取值范围为19700101080001到2038年的某一天,因此它不适合存放比较 久远的日期,下面简单测试一些这个范围:
```mysql
mysql> insert into t values (19700101080001);
Query OK, 1 row affected (0.00 sec)
mysql> select * from t;
+---------------------+
| t |
+---------------------+
| 1970-01-01 08:00:01 |
+---------------------+
1 row in set (0.00 sec)
mysql> insert into t values (19700101080000);
Query OK, 1 row affected, 1 warning (0.00 sec)
```
其中 19700101080000 超出了 tm 的下限,系统出现警告提示。查询一下,发现插入值变成 了 0 值。
```mysql
mysql> select * from t;
+---------------------+
| t |
+---------------------+
| 1970-01-01 08:00:01 |
| 0000-00-00 00:00:00 |
+---------------------+
2 rows in set (0.00 sec)
```
再来测试一下 TIMESTAMP 的上限值:
```mysql
mysql> insert into t values('2038-01-19 11:14:07');
Query OK, 1 row affected (0.00 sec)
mysql> select * from t;
+---------------------+
| t |
+---------------------+
| 2038-01-19 11:14:07 |
+---------------------+
1 row in set (0.00 sec)
mysql> insert into t values('2038-01-19 11:14:08');
Query OK, 1 row affected, 1 warning (0.00 sec)
mysql> select * from t;
+---------------------+
| t |
+---------------------+
| 2038-01-19 11:14:07 |
| 0000-00-00 00:00:00 |
+---------------------+
2 rows in set (0.00 sec)
```
从上面例子可以看出,TIMESTAMP和DATETIME的表示方法非常类似,区别主要有以下 几点。
TIMESTAMP支持的时间范围较小,其取值范围从19700101080001到2038年的某个 时间,而DATETIME是从1000-01-01 00:00:00到9999-12-31 23:59:59,范围更大。
表中的第一个TIMESTAMP列自动设置为系统时间。如果在一个TIMESTAMP列中插入 NULL,则该列值将自动设置为当前的日期和时间。在插入或更新一行但不明确给 TIMESTAMP列赋值时也会自动设置该列的值为当前的日期和时间,当插入的值超出 取值范围时,MySQL认为该值溢出,使用“0000-00-00 00:00:00”进行填补。
TIMESTAMP的插入和查询都受当地时区的影响,更能反应出实际的日期。而 DATETIME则只能反应出插入时当地的时区,其他时区的人查看数据必然会有误差 的。
TIMESTAMP的属性受MySQL版本和服务器SQLMode的影响很大,本章都是以MySQL 5.0为例进行介绍,在不同的版本下可以参考相应的MySQL帮助文档。
YEAR 类型主要用来表示年份,当应用只需要记录年份时,用 YEAR 比 DATE 将更节省空间。 下面的例子在表 t 中定义了一个 YEAR 类型字段,并插入一条记录:
```mysql
mysql> create table t(y year);
Query OK, 0 rows affected (0.01 sec)
mysql> desc t;
+-------+---------+------+-----+---------+-------+
| Field | Type | Null | Key | Default | Extra |
+-------+---------+------+-----+---------+-------+
| y | year(4) | YES | | NULL | |
+-------+---------+------+-----+---------+-------+
1 row in set (0.00 sec)
mysql> insert into t values(2100);
Query OK, 1 row affected (0.00 sec)
mysql> select * from t;
+------+
| y |
+------+
| 2100 |
+------+
1 row in set (0.00 sec)
```
MySQL 以 YYYY 格式检索和显示 YEAR 值,范围是 1901~2155。当使用两位字符串表示 年份时,其范围为“00”到“99”。
“00”到“69”范围的值被转换为 2000~2069 范围的 YEAR 值
“70”到“99”范围的值被转换为 1970~1999 范围的 YEAR 值。
细心的读者可能发现,在上面的例子中,日期类型的插入格式有很多,包括整数(如 2100)、字符串(如 2038-01-19 11:14:08)、函数(如 NOW())等,大家可能会感到疑惑,到 底什么样的格式才能够正确地插入到对应的日期字段中呢?下面以DATETIME为例进行介绍。
YYYY-MM-DD HH:MM:SS 或 YY-MM-DD HH:MM:SS 格式的字符串。允许“不严格” 语法:任何标点符都可以用做日期部分或时间部分之间的间割符。例如, “98-12-31 11:30:45”、 “98.12.31 11+30+45”、 “98/12/31 11*30*45”和“98@12@31 11^30^45” 是等价的。对于包括日期部分间割符的字符串值,如果日和月的值小于 10,不需 要指定两位数。 “1979-6-9”与“1979-06-09”是相同的。同样,对于包括时间部分间割符的字符串值,如果时、分和秒的值小于 10,不需要指定两位数。 “1979-10-30 1:2:3”与“1979-10-30 01:02:03”相同。
YYYYMMDDHHMMSS 或 YYMMDDHHMMSS格式的没有间割符的字符串,假定字符 串对于日期类型是有意义的。例如, “19970523091528”和“970523091528”被解 释为“1997-05-23 09:15:28”,但“971122129015”是不合法的(它有一个没有意 义的分钟部分),将变为“0000-00-00 00:00:00”。
YYYYMMDDHHMMSS 或 YYMMDDHHMMSS格式的数字,假定数字对于日期类型是 有意义的。例如,19830905132800和830905132800被解释为“1983-09-05 13:28:00”。 数字值应为 6、8、12 或者 14 位长。如果一个数值是 8 或 14 位长,则假定为 YYYYMMDD 或 YYYYMMDDHHMMSS 格式,前 4 位数表示年。如果数字 是 6 或 12 位长,则假定为 YYMMDD或 YYMMDDHHMMSS 格式,前 2 位数表示年。其他数字 被解释为仿佛用零填充到了最近的长度。
函数返回的结果,其值适合 DATETIME、DATE 或者 TIMESTAMP 上下文,例如 NOW() 或 CURRENT_DATE。
对于其他数据类型,其使用原则与上面的内容类似,限于篇幅,这里就不再赘述。
最后通过一个例子,说明如何采用不同的格式将日期“2007-9-3 12:10:10”插入到 DATETIME 列中。
```mysql
mysql> create table t6(dt datetime);
Query OK, 0 rows affected (0.03 sec)
mysql> insert into t6 values('2007-9-3 12:10:10');
Query OK, 1 row affected (0.00 sec)
mysql> insert into t6 values('2007/9/3 12+10+10');
Query OK, 1 row affected (0.00 sec)
mysql> insert into t6 values('20070903121010');
Query OK, 1 row affected (0.01 sec)
mysql> insert into t6 values(20070903121010);
Query OK, 1 row affected (0.00 sec)
mysql> select * from t6;
+---------------------+
| dt |
+---------------------+
| 2007-09-03 12:10:10 |
| 2007-09-03 12:10:10 |
| 2007-09-03 12:10:10 |
| 2007-09-03 12:10:10 |
+---------------------+
4 rows in set (0.00 sec)
```
### 字符串类型
MySQL 中提供了多种对字符数据的存储类型,不同的版本可能有所差异。以 5.0 版本为例, MySQL 包括了 CHAR、VARCHAR、BINARY、VARBINARY、BLOB、TEXT、ENUM 和 SET 等多种 字符串类型。表 3-4 中详细列出了这些字符类型的比较。
下面将分别对这些字符串类型做详细的介绍。
#### CHAR 和 VARCHAR 类型
CHAR 和 VARCHAR 很类似,都用来保存 MySQL 中较短的字符串。二者的主要区别在于存储 方式的不同:CHAR 列的长度固定为创建表时声明的长度,长度可以为从 0~255 的任何值; 而VARCHAR列中的值为可变长字符串,长度可以指定为0~255 (5.0.3以前)或者65535 (5.0.3 以后)之间的值。在检索的时候,CHAR 列删除了尾部的空格,而 VARCHAR 则保留这些空格。
下面的例子中通过给表vc中的VARCHAR(4)和char(4)字段插入相同的字符串来描述这个区别。
创建测试表 vc,并定义两个字段 v VARCHAR(4)和 c CHAR(4):
```mysql
mysql> CREATE TABLE vc (v VARCHAR(4), c CHAR(4));
Query OK, 0 rows affected (0.16 sec)
```
v 和 c 列中同时插入字符串“ab ”:
```mysql
mysql> INSERT INTO vc VALUES ('ab ', 'ab ');
Query OK, 1 row affected (0.05 sec)
```
显示查询结果:
```mysql
mysql> select length(v),length(c) from vc;
+-----------+-----------+
| length(v) | length(c) |
+-----------+-----------+
| 4 | 2 |
+-----------+-----------+
1 row in set (0.01 sec)
```
可以发现,c 字段的 length只有 2。给两个字段分别追加一个“+”字符看得更清楚:
```mysql
mysql> SELECT CONCAT(v, '+'), CONCAT(c, '+') FROM vc;
+----------------+----------------+
| CONCAT(v, '+') | CONCAT(c, '+') |
+----------------+----------------+
| ab + | ab+ |
+----------------+----------------+
1 row in set (0.00 sec)
```
显然,CHAR 列最后的空格在做操作时都已经被删除,而 VARCHAR 依然保留空格。
#### BINARY 和 VARBINARY 类型
BINARY 和 VARBINARY 类似于 CHAR 和 VARCHAR,不同的是它们包含二进制字符串 而不包含非二进制字符串。在下面的例子中,对表 t 中的 binary 字段 c 插入一个字符, 研究一下这个字符到底是怎么样存储的。
创建测试表 t,字段为 c BINARY(3):
```mysql
mysql> CREATE TABLE t (c BINARY(3));
Query OK, 0 rows affected (0.14 sec)
```
往 c 字段中插入字符“a” :
```mysql
mysql> INSERT INTO t SET c='a';
Query OK, 1 row affected (0.06 sec)
```
分别用以下几种模式来查看 c 列的内容:
```mysql
mysql> select *,hex(c),c='a',c='a\0',c='a\0\0' from t10;
+------+--------+-------+---------+-----------+
| c | hex(c) | c='a' | c='a\0' | c='a\0\0' |
+------+--------+-------+---------+-----------+
| a | 610000 | 0 | 0 | 1 |
+------+--------+-------+---------+-----------+
1 row in set (0.00 sec)
```
可以发现,当保存 BINARY 值时,在值的最后通过填充“0x00” (零字节)以达到指定的 字段定义长度。从上例中看出,对于一个 BINARY(3)列,当插入时'a'变为'a\0\0'。
#### ENUM 类型
ENUM中文名称叫枚举类型,它的值范围需要在创建表时通过枚举方式显式指定,对1~ 255 个成员的枚举需要 1 个字节存储;对于 255~65535 个成员,需要 2 个字节存储。最多 允许有 65535 个成员。下面往测试表 t 中插入几条记录来看看 ENUM 的使用方法。
创建测试表 t,定义 gender 字段为枚举类型,成员为'M'和'F':
```mysql
mysql> create table t (gender enum('M','F'));
Query OK, 0 rows affected (0.14 sec)
```
插入 4条不同的记录:
```mysql
mysql> INSERT INTO t VALUES('M'),('1'),('f'),(NULL);
Query OK, 4 rows affected (0.00 sec)
Records: 4 Duplicates: 0 Warnings: 0
mysql> select * from t;
+--------+
| gender |
+--------+
| M |
| M |
| F |
| NULL |
+--------+
4 rows in set (0.01 sec)
```
从上面的例子中,可以看出 ENUM 类型是忽略大小写的,对'M'、'f'在存储的时候将它们都转 成了大写,还可以看出对于插入不在 ENUM 指定范围内的值时,并没有返回警告,而是插 入了 enum('M','F')的第一值'M',这点用户在使用时要特别注意。
另外,ENUM 类型只允许从值集合中选取单个值,而不能一次取多个值。
#### SET 类型
Set 和 ENUM 类型非常类似,也是一个字符串对象,里面可以包含 0~64 个成员。根据 成员的不同,存储上也有所不同。
1~8 成员的集合,占1 个字节。
9~16 成员的集合,占 2 个字节。
17~24 成员的集合,占 3 个字节。
25~32 成员的集合,占 4 个字节。
33~64 成员的集合,占 8 个字节。
Set 和 ENUM 除了存储之外,最主要的区别在于 Set 类型一次可以选取多个成员,而 ENUM 则只能选一个。下面的例子在表 t 中插入了多组不同的成员:
```mysql
Create table t (col set ('a','b','c','d');
insert into t values('a,b'),('a,d,a'),('a,b'),('a,c'),('a');
mysql> select * from t;
+------+
| col |
+------+
| a,b |
| a,d |
| a,b |
| a,c |
| a |
+------+
5 rows in set (0.00 sec)
```
SET 类型可以从允许值集合中选择任意 1 个或多个元素进行组合,所以对于输入的值只要是 在允许值的组合范围内,都可以正确地注入到 SET 类型的列中。对于超出允许值范围的值例 如('a,d,f')将不允许注入到上面例子中设置的 SET 类型列中,而对于('a,d,a')这样包含重 复成员的集合将只取一次,写入后的结果为“a,d”,
## MySQL 运算符
MySQL支持多种类型的运算符,来连接表达式的项。这些类型主要包括算术运算符、比较运算符、逻辑运算符和位运算符。下面将通过实例对MySQL 5.0 支持的这几种运算符进行详细的介绍。
MySQL 主要有以下几种运算符:
- 算术运算符
- 比较运算符
- 逻辑运算符
- 位运算符
### 算术运算符
MySQL 支持的算术运算符包括加、减、乘、除和模运算。它们是最常使用、最简单的一类 运算符。表 4-1 列出了这些运算符及其作用。
MySQL 支持的算术运算符
| 运算符 | 作用 |
| :------- | :------------- |
| + | 加法 |
| - | 减法 |
| * | 乘法 |
| / 或 DIV | 除法,返回商 |
| % 或 MOD | 除法,返回余数 |
下例中简单地描述了这几种运算符的使用方法:
````
mysql> select 0.1+ 0.3333 ,0.1-0.3333, 0.1*0.3333, 1/2,1%2;
+-------------+------------+------------+--------+------+
| 0.1+ 0.3333 | 0.1-0.3333 | 0.1*0.3333 | 1/2 | 1%2 |
+-------------+------------+------------+--------+------+
| 0.4333 | -0.2333 | 0.03333 | 0.5000 | 1 |
+-------------+------------+------------+--------+------+
1 row in set (0.00 sec)
````
+运算符用于获得一个或多个值的和。
-运算符用于从一个值中减去另一个值。
*运算符使数字相乘,得到两个或多个值的乘积。
/运算符用一个值除以另一个值得到商。
%运算符用一个值除以另外一个值得到余数。
除法运算和模运算中,如果除数为 0,将是非法除数,返回结果为 NULL,如下例所示:
```
mysql> select 1/0, 100%0 ;
+------+-------+
| 1/0 | 100%0 |
+------+-------+
| NULL | NULL |
+------+-------+
1 row in set (0.02 sec)
```
对于模运算,还有另外一种表达方式,使用 MOD(a,b)函数与 a%b 效果一样:
```
mysql> select 3%2,mod(3,2);
+------+----------+
| 3%2 | mod(3,2) |
+------+----------+
| 1 | 1 |
+------+----------+
1 row in set (0.01 sec)
```
### 比较运算符
熟悉了最简单的算术运算符,再来看一下比较运算符。当使用SELECT语句进行查询时,MySQL 允许用户对表达式的左边操作数和右边操作数进行比较,比较结果为真,则返回 1,为假则 返回 0,比较结果不确定则返回 NULL。下面列出了 MySQL 5.0 支持的各种比较运算符。
MySQL 支持的比较运算符
| 运算符 | 作用 |
| -------------- | ------------------------- |
| = | 等于 |
| <>或!= | 不等于 |
| <=> | NULL安全的等于(NULL-safe) |
| < | 小于 |
| <= | 小于等于 |
| > | 大于 |
| >= | 大于等于 |
| BETWEEN | 存在与指定范围 |
| IN | 存在于指定集合 |
| IS NULL | 为 NULL |
| IS NOT NULL | 不为 NULL |
| LIKE | 通配符匹配 |
| REGEXP或 RLIKE | 正则表达式匹配 |
比较运算符可以用于比较数字、字符串和表达式。数字作为浮点数比较,而字符串以不 区分大小写的方式进行比较。下面通过实例来学习各种比较运算符的使用。
#### “=”运算符
“=”运算符,用于比较运算符两侧的操作数是否相等,如果两侧操作数相等返回值为 1, 否则为 0。注意 NULL 不能用于“=”比较。
```
mysql> select 1=0,1=1,NULL=NULL;
+-----+-----+-----------+
| 1=0 | 1=1 | NULL=NULL |
+-----+-----+-----------+
| 0 | 1 | NULL |
+-----+-----+-----------+
1 row in set (0.00 sec)
```
#### “<>”运算符
“<>”运算符,和“=”相反,如果两侧操作数不等,则值为 1,否则为 0。NULL 不能 用于“<>”比较。
```
mysql> select 1<>0,1<>1,null<>null;
+------+------+------------+
| 1<>0 | 1<>1 | null<>null |
+------+------+------------+
| 1 | 0 | NULL |
+------+------+------------+
1 row in set (0.00 sec)
```
#### “<=>”安全的等于运算符
“<=>”安全的等于运算符,和“=”类似,在操作数相等时值为 1,不同之处在于即使 操作的值为 NULL 也可以正确比较。
```
mysql> select 1<=>1,2<=>0 ,0<=>0, NULL<=>NULL;
+-------+-------+-------+-------------+
| 1<=>1 | 2<=>0 | 0<=>0 | NULL<=>NULL |
+-------+-------+-------+-------------+
| 1 | 0 | 1 | 1 |
+-------+-------+-------+-------------+
1 row in set (0.17 sec)
```
“<”运算符,当左侧操作数小于右侧操作数时,其返回值为 1,否则其值为 0。
````
mysql> select 'a'<'b' ,'a'<'a' ,'a'<'c',1<2;
+---------+---------+---------+-----+
| 'a'<'b' | 'a'<'a' | 'a'<'c' | 1<2 |
+---------+---------+---------+-----+
| 1 | 0 | 1 | 1 |
+---------+---------+---------+-----+
1 row in set (0.03 sec)
````
“<=”运算符,当左侧操作数小于等于右侧操作数时,其返回值为 1,否则返回值为 0。
```
mysql> select 'bdf'<='b','b'<='b' ,0<1;
+------------+----------+-----+
| 'bdf'<='b' | 'b'<='b' | 0<1 |
+------------+----------+-----+
| 0 | 1 | 1 |
+------------+----------+-----+
1 row in set (0.00 sec)
```
“>”运算符,当左侧操作数大于右侧操作数时,其返回值为 1,否则返回值为 0。
```
mysql> select 'a'>'b','abc'>'a' ,1>0;
+---------+-----------+-----+
| 'a'>'b' | 'abc'>'a' | 1>0 |
+---------+-----------+-----+
| 0 | 1 | 1 |
+---------+-----------+-----+
1 row in set (0.03 sec)
```
“>=”运算符,当左侧操作数大于等于右侧操作数时,其返回值为 1,否则返回值为 0。
```
mysql> select 'a'>='b','abc'>='a' ,1>=0 ,1>=1;
+----------+------------+------+------+
| 'a'>='b' | 'abc'>='a' | 1>=0 | 1>=1 |
+----------+------------+------+------+
| 0 | 1 | 1 | 1 |
+----------+------------+------+------+
1 row in set (0.00 sec)
```
“BETWEEN”运算符的使用格式为“a BETWEEN min AND max”,当 a 大于等于 min 并 且小于等于 max,则返回值为 1,否则返回 0;当操作数 a、min、max 类型相同时,此 表达式等价于(a>=min and a<=max),当操作数类型不同时,比较时会遵循类型转换原 则进行转换后,再进行比较运算。下例中描述了 BETWEEN 的用法:
```
mysql> select 10 between 10 and 20, 9 between 10 and 20;
+----------------------+---------------------+
| 10 between 10 and 20 | 9 between 10 and 20 |
+----------------------+---------------------+
| 1 | 0 |
+----------------------+---------------------+
1 row in set (0.00 sec)
```
“IN”运算符的使用格式为“a IN (value1,value2,…)”,当 a 的值存在于列表中时,则整 个比较表达式返回的值为 1,否则返回 0。
```
mysql> select 1 in (1,2,3) , 't' in ('t','a','b','l','e'),0 in (1,2);
+--------------+------------------------------+------------+
| 1 in (1,2,3) | 't' in ('t','a','b','l','e') | 0 in (1,2) |
+--------------+------------------------------+------------+
| 1 | 1 | 0 |
+--------------+------------------------------+------------+
1 row in set (0.00 sec)
```
“IS NULL”运算符的使用格式为“a IS NULL”,当 a 的值为 NULL,则返回值为 1,否则 返回 0。
```
mysql> select 0 is null, null is null;
+-----------+--------------+
| 0 is null | null is null |
+-----------+--------------+
| 0 | 1 |
+-----------+--------------+
1 row in set (0.02 sec)
```
“IS NOT NULL”运算符的使用格式为“a IS NOT NULL”。和“IS NULL”相反,当 a的 值不为 NULL,则返回值为 1,否则返回 0。
```
mysql> select 0 is not null, null is not null;
+----------------+-------------------+
| 0 is not null | null is not null |
+----------------+-------------------+
| 1 | 0 |
+----------------+-------------------+
1 row in set (0.00 sec)
```
“LIKE”运算符的使用格式为“a LIKE %123%”,当 a中含有字符串“123”时,则返回 值为 1,否则返回 0。
```
mysql> select 123456 like '123%',123456 like '%123%',123456 like '%321%';
+--------------------+---------------------+---------------------+
| 123456 like '123%' | 123456 like '%123%' | 123456 like '%321%' |
+--------------------+---------------------+---------------------+
| 1 | 1 | 0 |
+--------------------+---------------------+---------------------+ 1 row in set (0.00 sec)
```
“REGEXP”运算符的使用格式为“str REGEXP str_pat”,当 str 字符串中含有 str_pat 相匹配的字符串时,则返回值为 1,否则返回 0。REGEXP 运算符的使用方法将会在第 17 章中详细介绍。
```
mysql> select 'abcdef' regexp 'ab' ,'abcdefg' regexp 'k';
+----------------------+----------------------+
| 'abcdef' regexp 'ab' | 'abcdefg' regexp 'k' |
+----------------------+----------------------+
| 1 | 0 |
+----------------------+----------------------+
1 row in set (0.00 sec)
```
### 逻辑运算符
逻辑运算符又称为布尔运算符,用来确认表达式的真和假。MySQL 支持 4 种逻辑运算符
| 运算符号 | 作用 |
| :---------- | :------- |
| NOT 或 ! | 逻辑非 |
| AND 或 && | 逻辑与 |
| OR 或 \|\| | 逻辑或 |
| XOR | 逻辑异或 |
““NOT”或“!”表示逻辑非。返回和操作数相反的结果:当操作数为 0(假),则返回 值为 1,否则值为 0。但是有一点除外,那就是 NOT NULL 的返回值为 NULL,这一点请 大家注意。如下例所示:
```
mysql> select not 0, not 1, not null ;
+-------+-------+----------+
| not 0 | not 1 | not null |
+-------+-------+----------+
| 1 | 0 | NULL |
+-------+-------+----------+
1 row in set (0.00 sec)
```
““AND”或“&&”表示逻辑与运算。当所有操作数均为非零值并且不为 NULL 时,计 算所得结果为 1,当一个或多个操作数为 0 时,所得结果为 0,操作数中有任何一个为 NULL 则返回值为 NULL。如下例所示:
```
mysql> select (1 and 1),(0 and 1) ,(3 and 1 ) ,(1 and null);
+-----------+-----------+------------+--------------+
| (1 and 1) | (0 and 1) | (3 and 1 ) | (1 and null) |
+-----------+-----------+------------+--------------+
| 1 | 0 | 1 | NULL |
+-----------+-----------+------------+--------------+
1 row in set (0.00 sec)
```
“OR”或“||”表示逻辑或运算。当两个操作数均为非 NULL 值时,如有任意一个操作 数为非零值,则结果为 1,否则结果为 0。当有一个操作数为 NULL 时,如另一个操作 数为非零值,则结果为 1,否则结果为 NULL。假如两个操作数均为 NULL,则所得结果 为 NULL。如下例所示:
```
mysql> select (1 or 0) ,(0 or 0),(1 or null) ,(1 or 1),(null or null);
+----------+----------+-------------+----------+----------------+
| (1 or 0) | (0 or 0) | (1 or null) | (1 or 1) | (null or null) |
+----------+----------+-------------+----------+----------------+
| 1 | 0 | 1 | 1 | NULL |
+----------+----------+-------------+----------+----------------+ 1 row in set (0.00 sec)
```
“XOR”表示逻辑异或。当任意一个操作数为 NULL 时,返回值为 NULL。对于非 NULL 的 操作数,如果两个的逻辑真假值相异,则返回结果 1;否则返回 0。如下例所示:
```
mysql> select 1 xor 1 ,0 xor 0,1 xor 0,0 xor 1,null xor 1;
+---------+---------+---------+---------+------------+
| 1 xor 1 | 0 xor 0 | 1 xor 0 | 0 xor 1 | null xor 1 |
+---------+---------+---------+---------+------------+
| 0 | 0 | 1 | 1 | NULL |
+---------+---------+---------+---------+------------+
1 row in set (0.00 sec)
```
### 位运算符
位运算是将给定的操作数转化为二进制后,对各个操作数每一位都进行指定的逻辑运算, 得到的二进制结果转换为十进制数后就是位运算的结果。MySQL 5.0支持6种位运算符, 如表 4-4 所示。
| 运算符号 | 作用 |
| :------- | :------- |
| & | 按位与 |
| \| | 按位或 |
| ^ | 按位异或 |
| ! | 取反 |
| << | 左移 |
| >> | 右移 |
可以发现,位运算符中的位与“&”和位或“|”和前面介绍的逻辑与和逻辑或非常类 似。其他操作符和逻辑操作有所不同,下面将分别举例介绍。
“位与”对多个操作数的二进制位作逻辑与操作,例如 2&3,因为 2 的二进制数是 10, 3 是 11,所有 10&11 的结果是 10,十进制数字还是 2,来看实际结果:
```
mysql> select 2&3;
+-----+
| 2&3 |
+-----+
| 2 |
+-----+
1 row in set (0.00 sec)
```
可以对 2 个以上操作数做或操作,测试一下 2&3&4,因为 4 的二进制是 100,和上面的 10 做与操作 100&010 后,结果应该是 000,可以看实际结果为:
```
mysql> select 2&3&4;
+-------+
| 2&3&4 |
+-------+
| 0 |
+-------+ 1 row in set (0.00 sec)
```
“位或”对多个操作数的二进制位作逻辑或操作,还是上面的例子,2|3 的结果应该是 10|11,结果还是 11,应该是 3,实际结果如下:
```
mysql> select 2|3;
+-----+
| 2|3 |
+-----+
| 3 |
+-----+
1 row in set (0.00 sec)
```
“位异或”对操作数的二进制位做异或操作,10^11 的结果是 01,结果应该是 1,可以 看实际结果为:
```
mysql> select 2^3;
+-----+
| 2^3 |
+-----+
| 1 |
+-----+
1 row in set (0.00 sec)
```
“位取反”对操作数的二进制位作 NOT 操作,这里的操作数只能是一位,下面看一个经 典的取反例子:对 1 做位取反,具体如下所示:
```
mysql> select ~1 ,~ 18446744073709551614;
+----------------------+------------------------+
| ~1 | ~ 18446744073709551614 |
+----------------------+------------------------+
| 18446744073709551614 | 1 |
+----------------------+------------------------+
1 row in set (0.00 sec)
```
结果让大家可能有些疑惑, 1的位取反怎么会是这么大的数字?来研究一下,在 MySQL 中, 常量数字默认会以 8 个字节来表示,8 个字节就是 64位,常量 1 的二进制表示为 63 个“0” 加1个“1”,位取反后就是63个 “1”加一个“0”,转换为二进制后就是18446744073709551614, 实际结果如下:
```
mysql> select bin(18446744073709551614);
+------------------------------------------------------------------+
| bin(18446744073709551614) |
+------------------------------------------------------------------+
| 1111111111111111111111111111111111111111111111111111111111111110 |
+------------------------------------------------------------------+
1 row in set (0.00 sec)
```
“位右移”对左操作数向右移动右操作数指定的位数。例如 100>>3,就是对 100 的二进 制数 0001100100 右移 3 位,左边补 0,结果是 0000001100,转换为二进制数是 12,实 际结果如下:
```
mysql> select 100>>3;
+--------+
| 100>>3 |
+--------+
| 12 |
+--------+
1 row in set (0.00 sec)
```
“位左移”对左操作数向左移动右操作数指定的位数。例如 100<<3,就是对 100 的二进 制数 0001100100 左移 3 位,右边补 0,结果是 1100100000,转换为二进制数是 800, 实际结果如下:
```
mysql> select 100<<3;
+--------+
| 100<<3 |
+--------+
| 800 |
+--------+
1 row in set (0.00 sec)
```
### 运算符的优先级
前面介绍了 MySQL 支持的各种运算符的使用方法。在实际应用中,很可能将这些运算符进 行混合运算,那么应该先进行哪些运算符的操作呢?表 4-5 中列出了所有的运算符,优先级 由低到高排列,同一行中的运算符具有相同的优先级。
| 优先级顺序 | 运算符 |
| ---------- | -------------------------------------------------- |
| 1 | := |
| 2 | \|\|, OR, XOR |
| 3 | &&, AND |
| 4 | NOT |
| 5 | BETWEEN, CASE, WHEN, THEN, ELSE |
| 6 | =, <=>, >=, >, <=, <, <>, !=, IS, LIKE, REGEXP, IN |
| 7 | \| |
| 8 | & |
| 9 | <<, >> |
| 10 | -, + |
| 11 | *, /, DIV, %, MOD |
| 12 | ^ |
| 13 | - (一元减号), ~ (一元比特反转) |
| 14 | ! |
在实际运行的时候,可以参考表 4-5 中的优先级。实际上,很少有人能将这些优先级熟练记 忆,很多情况下我们都是用“()”来将需要优先的操作括起来,这样既起到了优先的作用, 又使得其他用户看起来更加易于理解。
## MySQL函数
经常编写程序的朋友一定体会得到函数的重要性,丰富的函数往往能使用户的工作事半功倍。
函数能帮助用户做很多事情,比如说字符串的处理、数值的运算、日期的运算等,在这方面 MySQL 提供了多种内建函数帮助开发人员编写简单快捷的 SQL 语句,其中常用的函数有字 符串函数、日期函数和数值函数。
在 MySQL 数据库中,函数可以用在 SELECT 语句及其子句(例如 where、order by、having 等) 中,也可以用在 UPDATE、DELETE 语句及其子句中。本章将配合一些实例对这些常用函数进 行详细的介绍。
### 字符串函数
字符串函数是最常用的一种函数了,如果大家编写过程序的话,不妨回过头去看看自己使用 过的函数,可能会惊讶地发现字符串处理的相关函数占已使用过的函数很大一部分。MySQL 中字符串函数也是最丰富的一类函数,表 5-1 中列出了这些函数以供参考。
| 函数 | 功能 |
| --------------------- | ------------------------------------------------------------ |
| CANCAT(S1,S2,…Sn) | 连接 S1,S2,…Sn 为一个字符串 |
| INSERT(str,x,y,instr) | 将字符串 str 从第 x位置开始,y 个字符长的子串替换为字符串 instr |
| LOWER(str) | 将字符串 str 中所有字符变为小写 |
| UPPER(str) | 将字符串 str 中所有字符变为大写 |
| LEFT(str ,x) | 返回字符串 str 最左边的 x个字符 |
| RIGHT(str,x) | 返回字符串 str 最右边的 x个字符 |
| LPAD(str,n ,pad) | 用字符串 pad 对 str 最左边进行填充,直到长度为 n 个字符长度 |
| RPAD(str,n,pad) | 用字符串 pad 对 str 最右边进行填充,直到长度为 n 个字符长度 |
| LTRIM(str) | 去掉字符串 str 左侧的空格 |
| RTRIM(str) | 去掉字符串 str 行尾的空格 |
| REPEAT(str,x) | 返回 str 重复 x次的结果 |
| REPLACE(str,a,b) | 用字符串 b 替换字符串 str 中所有出现的字符串 a |
| STRCMP(s1,s2) | 比较字符串 s1 和s2 |
| TRIM(str) | 去掉字符串行尾和行头的空格 |
| SUBSTRING(str,x,y) | 返回从字符串 str x位置起 y个字符长度的字串 |
下面通过具体的实例来逐个地研究每个函数的用法,需要注意的是这里的例子仅仅在于说明 各个函数的使用方法,所以函数都是单个出现的,但是在一个具体的应用中通常可能需要综 合几个甚至几类函数才能实现相应的应用。
CANCAT(S1,S2,…Sn)函数:把传入的参数连接成为一个字符串。
下面的例子把“aaa”、“bbb”、“ccc”3 个字符串连接成了一个字符串“aaabbbccc”。另外, 任何字符串与 NULL 进行连接的结果都将是 NULL。
```
mysql> select concat('aaa','bbb','ccc') ,concat('aaa',null);
+---------------------------+--------------------+
| concat('aaa','bbb','ccc') | concat('aaa',null) |
+---------------------------+--------------------+
| aaabbbccc | NULL |
+---------------------------+--------------------+
1 row in set (0.05 sec)
```
INSERT(str ,x,y,instr)函数:将字符串 str 从第 x 位置开始,y 个字符长的子串替换为字符 串 instr。
下面的例子把字符串“beijing2008you”中的从第 12个字符开始以后的 3 个字符替换成 “me”。
```
mysql> select INSERT('beijing2008you',12,3, 'me') ;
+-------------------------------------+
| INSERT('beijing2008you',12,3, 'me') |
+-------------------------------------+
| beijing2008me |
+-------------------------------------+
1 row in set (0.00 sec)
```
LOWER(str)和 UPPER(str)函数:把字符串转换成小写或大写。
在字符串比较中,通常要将比较的字符串全部转换为大写或者小写,如下例所示:
```
mysql> select LOWER('BEIJING2008'), UPPER('beijing2008');
+----------------------+----------------------+
| LOWER('BEIJING2008') | UPPER('beijing2008') |
+----------------------+----------------------+
| beijing2008 | BEIJING2008 |
+----------------------+----------------------+
1 row in set (0.00 sec)
```
LEFT(str,x)和 RIGHT(str,x)函数:分别返回字符串最左边的x个字符和最右边的x个字符。 如果第二个参数是 NULL,那么将不返回任何字符串。
下例中显示了对字符串“beijing2008”应用函数后的结果。
```
mysql> SELECT LEFT('beijing2008',7),LEFT('beijing',null),RIGHT('beijing2008',4);
+-----------------------+----------------------+------------------------+
| LEFT('beijing2008',7) | LEFT('beijing',null) | RIGHT('beijing2008',4) |
+-----------------------+----------------------+------------------------+
| beijing | | 2008 |
+-----------------------+----------------------+------------------------+
1 row in set (0.00 sec)
```
LPAD(str,n ,pad)和 RPAD(str,n ,pad)函数:用字符串 pad 对 str 最左边和最右边进行填充, 直到长度为 n个字符长度。
下例中显示了对字符串“2008”和“beijing”分别填充后的结果。
```
mysql> select lpad('2008',20,'beijing'),rpad('beijing',20,'2008');
+---------------------------+---------------------------+
| lpad('2008',20,'beijing') | rpad('beijing',20,'2008') |
+---------------------------+---------------------------+
| beijingbeijingbe2008 | beijing2008200820082 |
+---------------------------+---------------------------+
1 row in set (0.00 sec)
```
LTRIM(str)和 RTRIM(str)函数:去掉字符串 str 左侧和右侧空格。
下例中显示了字符串“beijing”加空格进行过滤后的结果。
```
mysql> select ltrim(' |beijing'),rtrim('beijing| ');
+---------------------+------------------------+
| ltrim(' |beijing') | rtrim('beijing| ') |
+---------------------+------------------------+
| |beijing | beijing| |
+---------------------+------------------------+
1 row in set (0.00 sec)
```
REPEAT(str,x)函数:返回 str 重复 x 次的结果。
下例中对字符串“mysql”重复显示了 3 次。
```
mysql> select repeat('mysql ',3);
+--------------------+
| repeat('mysql ',3) |
+--------------------+
| mysql mysql mysql |
+--------------------+
1 row in set (0.00 sec)
```
REPLACE(str,a,b)函数:用字符串 b 替换字符串 str中所有出现的字符串 a。
下例中用字符串“2008”代替了字符串“beijing_2010”中的“_2010”。
```
mysql> select replace('beijing_2010','_2010','2008');
+----------------------------------------+
| replace('beijing_2010','_2010','2008') |
+----------------------------------------+
| beijing2008 |
+----------------------------------------+
1 row in set (0.00 sec)
```
STRCMP(s1,s2)函数:比较字符串 s1 和 s2 的 ASCII 码值的大小。如果 s1 比 s2 小,那么返回-1; 如果 s1 与 s2 相等,那么返回 0;如果 s1 比 s2 大,那么返回 1。如下例:
```
mysql> select strcmp('a','b'),strcmp('b','b'),strcmp('c','b');
+-----------------+-----------------+-----------------+
| strcmp('a','b') | strcmp('b','b') | strcmp('c','b') |
+-----------------+-----------------+-----------------+
| -1 | 0 | 1 |
+-----------------+-----------------+-----------------+
1 row in set (0.00 sec)
```
TRIM(str)函数:去掉目标字符串的开头和结尾的空格。
下例中对字符串“$ beijing2008 $ ”进行了前后空格的过滤。
```
mysql> select trim(' $ beijing2008 $ ');
+-----------------------------+
| trim(' $ beijing2008 $ ') |
+-----------------------------+
| $ beijing2008 $ |
+-----------------------------+
1 row in set (0.00 sec)
```
SUBSTRING(str,x,y)函数:返回从字符串 str 中的第 x 位置起 y 个字符长度的字串。
此函数经常用来对给定字符串进行字串的提取,如下例所示。
```
mysql> select substring('beijing2008',8,4),substring('beijing2008',1,7);
+------------------------------+------------------------------+
| substring('beijing2008',8,4) | substring('beijing2008',1,7) |
+------------------------------+------------------------------+
| 2008 | beijing |
+------------------------------+------------------------------+
```
### 数值函数
MySQL 中另外一类很重要的函数就是数值函数,这些函数能处理很多数值方面的运算。可 以想象,如果没有这些函数的支持,用户在编写有关数值运算方面的代码时将会困难重重, 举个例子,如果没有 ABS 函数的话,如果要取一个数值的绝对值,就需要进行好多次判断 才能返回这个值,而数字函数能够大大提高用户的工作效率。表 5-2 中列出了在 MySQL 中 会经常使用的数值函数。
| 函数 | 功能 |
| ------------- | ------------------------------------- |
| ABS(x) | 返回 x的绝对值 |
| CEIL(x) | 返回大于 x 的最大整数值 |
| FLOOR(x) | 返回小于 x的最大整数值 |
| MOD(x,y) | 返回 x/y 的模 |
| RAND() | 返回 0 到 1 内的随机值 |
| ROUND(x,y) | 返回参数 x的四舍五入的有 y 位小数的值 |
| TRUNCATE(x,y) | 返回数字 x截断为 y 位小数的结果 |
下面将结合实例对这些函数进行介绍。
ABS(x)函数:返回 x 的绝对值。
下例中显示了对正数和负数分别取绝对值之后的结果。
```
mysql> select ABS(-0.8) ,ABS(0.8);
+-----------+----------+
| ABS(-0.8) | ABS(0.8) |
+-----------+----------+
| 0.8 | 0.8 |
+-----------+----------+
1 row in set (0.09 sec)
```
CEIL(x)函数:返回大于 x的最大整数。
下例中显示了对 0.8 和-0.8 分别 CEIL 后的结果。
````
mysql> select CEIL(-0.8),CEIL(0.8);
+------------+-----------+
| CEIL(-0.8) | CEIL(0.8) |
+------------+-----------+
| 0 | 1 |
+------------+-----------+
1 row in set (0.03 sec)
````
FLOOR(x)函数:返回小于 x的最大整数,和 CEIL 的用法刚好相反。
下例中显示了对 0.8 和-0.8 分别 FLOOR 后的结果。
```
mysql> select FLOOR(-0.8), FLOOR(0.8);
+-------------+------------+
| FLOOR(-0.8) | FLOOR(0.8) |
+-------------+------------+
| -1 | 0 |
+-------------+------------+
1 row in set (0.00 sec)
```
MOD(x,y)函数:返回 x/y 的模。
和 x%y 的结果相同,模数和被模数任何一个为 NULL 结果都为 NULL。如下例所示:
```
mysql> select MOD(15,10),MOD(1,11),MOD(NULL,10);
+------------+-----------+--------------+
| MOD(15,10) | MOD(1,11) | MOD(NULL,10) |
+------------+-----------+--------------+
| 5 | 1 | NULL |
+------------+-----------+--------------+
1 row in set (0.00 sec)
```
RAND()函数:返回 0 到 1 内的随机值。
每次执行结果都不一样,如下例所示:
```
mysql> select RAND(),RAND();
+------------------+------------------+
| RAND() | RAND() |
+------------------+------------------+
| 0.12090325459922 | 0.83369727882901 |
+------------------+------------------+
1 row in set (0.00 sec)
```
利用此函数可以取任意指定范围内的随机数,比如需要产生 0~100 内的任意随机整数,可 以操作如下:
```
mysql> select ceil(100*rand()),ceil(100*rand());
+------------------+------------------+
| ceil(100*rand()) | ceil(100*rand()) |
+------------------+------------------+
| 91 | 15 |
+------------------+------------------+
1 row in set (0.00 sec)
```
ROUND(x,y)函数:返回参数 x的四舍五入的有 y 位小数的值。
如果是整数,将会保留 y 位数量的 0;如果不写 y,则默认 y 为 0,即将 x四舍五入后取整。 适合于将所有数字保留同样小数位的情况。如下例所示。
```
mysql> select ROUND(1.1),ROUND(1.1,2),ROUND(1,2);
+------------+--------------+------------+
| ROUND(1.1) | ROUND(1.1,2) | ROUND(1,2) |
+------------+--------------+------------+
| 1 | 1.10 | 1.00 |
+------------+--------------+------------+
1 row in set (0.00 sec)
```
TRUNCATE(x,y)函数:返回数字 x 截断为 y 位小数的结果。
注意 TRUNCATE 和 ROUND 的区别在于 TRUNCATE 仅仅是截断,而不进行四舍五入。下例中 描述了二者的区别:
```
mysql> select ROUND(1.235,2),TRUNCATE(1.235,2);
+----------------+-------------------+
| ROUND(1.235,2) | TRUNCATE(1.235,2) |
+----------------+-------------------+
| 1.24 | 1.23 |
+----------------+-------------------+
1 row in set (0.00 sec)
```
### 日期和时间函数
有时我们可能会遇到这样的需求:当前时间是多少、下个月的今天是星期几、统计截止到当 前日期前 3 天的收入总和等。这些需求就需要日期和时间函数来实现,表 5-3 列出了 MySQL 中支持的一些常用日期和时间函数。
### 流程函数
流程函数也是很常用的一类函数,用户可以使用这类函数在一个 SQL 语句中实现条件选择, 这样做能够提高语句的效率。表 5-6 列出了 MySQL 中跟条件选择有关的流程函数,下面将 通过具体的实例来讲解每个函数的用法。
| 函数 | 功能 |
| :----------------------------------------------------------- | :---------------------------------------------------- |
| IF(value,t f) | 如果 value是真,返回 t;否则返回f |
| IFNULL(value1,value2) | 如果 value1 不为空返回 value1,否则返回 value2 |
| CASE WHEN [value1] THEN[result1]…ELSE[default]END | 如果 value1 是真,返回 result1,否则返回default |
| CASE [expr] WHEN [value1] THEN[result1]…ELSE[default]END | 如果 expr 等于 value1,返回 result1,否则返回 default |
下面的例子中模拟了对职员薪水进行分类,这里首先创建并初始化一个职员薪水表:
```
mysql> create table salary (userid int,salary decimal(9,2));
Query OK, 0 rows affected (0.06 sec)
```
插入一些测试数据:
```
mysql> insert into salary values(1,1000),(2,2000), (3,3000),(4,4000),(5,5000), (1,null);
Query OK, 6 rows affected (0.00 sec)
mysql> select * from salary;
+--------+---------+
| userid | salary |
+--------+---------+
| 1 | 1000.00 |
| 2 | 2000.00 |
| 3 | 3000.00 |
| 4 | 4000.00 |
| 5 | 5000.00 |
| 1 | NULL |
+--------+---------+
6 rows in set (0.00 sec)
```
接下来,通过这个表来介绍各个函数的应用。
IF(value,t,f)函数:我们认为月薪在 2000 元以上的职员属于高薪,用“high”表示;而 2000 元以下的职员属于低薪,用“low”表示。
````
mysql> select if(salary>2000,'high','low') from salary;
+------------------------------+
| if(salary>2000,'high','low') |
+------------------------------+
| low |
| low |
| high |
| high |
| high |
+------------------------------+
5 rows in set (0.01 sec)
````
IFNULL(value1,value2)函数:这个函数一般用来替换 NULL 值的,我们知道 NULL 值是不 能参与数值运算的,下面这个语句就是把 NULL 值用 0 来替换。
```
mysql> select ifnull(salary,0) from salary;
+------------------+
| ifnull(salary,0) |
+------------------+
| 1000.00 |
| 2000.00 |
| 3000.00 |
| 4000.00 |
| 5000.00 |
| 0.00 |
+------------------+
6 rows in set (0.00 sec)
```
CASE WHEN [value1] THEN[result1]…ELSE[default]END 函 数 : 我 们 也 可 以 用 case when…then 函数实现上面例子中高薪低薪的问题。
```
mysql> select case when salary<=2000 then 'low' else 'high' end from salary;
+---------------------------------------------------+
| case when salary<=2000 then 'low' else 'high' end |
+---------------------------------------------------+
| low |
| low |
| high |
| high |
| high |
| high |
+---------------------------------------------------+
6 rows in set (0.00 sec)
```
CASE [expr] WHEN [value1] THEN[result1]…ELSE[default]END 函数:这里还可以分多种情况把职 员的薪水分多个档次,比如下面的例子分成高、中、低 3 种情况。同样还可以分成更多种情 况,这里就不再举例了,有兴趣的读者可以自己测试一下。
```
mysql> select case salary when 1000 then 'low' when 2000 then 'mid' else 'high' end from
salary;
+-----------------------------------------------------------------------+
| case salary when 1000 then 'low' when 2000 then 'mid' else 'high' end |
+-----------------------------------------------------------------------+
| low |
| mid |
| high |
| high |
| high |
| high |
+-----------------------------------------------------------------------+
6 rows in set (0.00 sec)
```
### 其他常用函数
MySQL 提供的函数很丰富,除了前面介绍的字符串函数、数字函数、日期函数、流程函数 以外还有很多其他函数,在此不再一一列举,有兴趣的读者可以参考 MySQL 官方手册。表 5-7 列举了一些其他常用的函数。
| 函数 | 功能 |
| -------------- | ------------------------- |
| DATABASE() | 返回当前数据库名 |
| VERSION() | 返回当前数据库版本 |
| USER() | 返回当前登录用户名 |
| INET_ATON(IP) | 返回 IP地址的数字表示 |
| INET_NTOA(num) | 返回数字代表的IP 地址 |
| PASSWORD(str) | 返回字符串 str 的加密版本 |
| MD5() | 返回字符串 str 的 MD5 值 |
下面结合实例简单介绍一下这些函数的用法。
DATABASE()函数:返回当前数据库名。
```
mysql> select DATABASE();
+------------+
| DATABASE() |
+------------+
| test |
+------------+
1 row in set (0.00 sec)
```
VERSION()函数:返回当前数据库版本。
```
mysql> select VERSION();
+-----------+
| VERSION() |
+-----------+
| 5.0.18-nt |
+-----------+
1 row in set (0.00 sec)
```
USER()函数:返回当前登录用户名。
```
mysql> select USER();
+----------------+
| USER() |
+----------------+
| root@localhost |
+----------------+
1 row in set (0.03 sec)
```
INET_ATON(IP)函数:返回 IP 地址的网络字节序表示。
```
mysql> select INET_ATON('192.168.1.1');
+--------------------------+
| INET_ATON('192.168.1.1') |
+--------------------------+
| 3232235777 |
+--------------------------+
1 row in set (0.00 sec)
```
INET_NTOA(num)函数:返回网络字节序代表的 IP 地址。
```
mysql> select INET_NTOA(3232235777);
+-----------------------+
| INET_NTOA(3232235777) |
+-----------------------+
| 192.168.1.1 |
+-----------------------+
1 row in set (0.00 sec)
```
INET_ATON(IP)和INET_NTOA(num)函数主要的用途是将字符串的IP地址转换为数字表示的网 络字节序,这样可以更方便地进行 IP 或者网段的比较。比如在下面的表 t 中,要想知道在“192.168.1.3”和“192.168.1.20”之间一共有多少 IP 地址:
```
mysql> select * from t;
+--------------+
| ip |
+--------------+
| 192.168.1.1 |
| 192.168.1.3 |
| 192.168.1.6 |
| 192.168.1.10 |
| 192.168.1.20 |
| 192.168.1.30 |
+--------------+
6 rows in set (0.00 sec)
```
按照正常的思维,应该用字符串来进行比较,下面是字符串的比较结果:
```
mysql> select * from t where ip>='192.168.1.3' and ip<='192.168.1.20';
Empty set (0.01 sec)
```
结果没有如我们所愿,竟然是个空集。
其实原因就在于字符串的比较是一个字符一个字符的比较,当对应字符相同时候,就比较下一个,直到遇到能区分出大小的字符,才停止比较, 后面的字符也将忽略。
显然,在此例中,“192.168.1.3”其实比“192.168.1.20”要“大”, 因为“3”比“2”大,而不能用我们日常的思维 3<20,所以“ip>='192.168.1.3' and ip<='192.168.1.20'”必然是个空集。 在这里,如果要想实现上面的功能,就可用函数 INET_ATON 来实现,将 IP 转换为字节序后 再比较,如下所示:
```
mysql> select * from t where inet_aton(ip)>=inet_aton('192.168.1.3') and
inet_aton(ip)<=inet_aton('192.168.1.20');
+--------------+
| ip |
+--------------+
| 192.168.1.3 |
| 192.168.1.6 |
| 192.168.1.10 |
| 192.168.1.20 |
+--------------+
4 rows in set (0.00 sec)
```
结果完全符合我们的要求。
PASSWORD(str)函数:返回字符串 str 的加密版本,一个 41 位长的字符串。
此函数只用来设置系统用户的密码,但是不能用来对应用的数据加密。如果应用方面有加密 的需求,可以使用 MD5 等加密函数来实现。 下例中显示了字符串“123456”的 PASSWORD 加密后的值:
```
mysql> select PASSWORD('123456');
+-------------------------------------------+
| PASSWORD('123456') |
+-------------------------------------------+
| *6BB4837EB74329105EE4568DDA7DC67ED2CA2AD9 |
+-------------------------------------------+
1 row in set (0.08 sec)
```
MD5(str)函数:返回字符串 str 的 MD5 值,常用来对应用中的数据进行加密。
下例中显示了字符串“123456”的 MD5 值:
```
mysql> select MD5('123456');
+----------------------------------+
| MD5('123456') |
+----------------------------------+
| e10adc3949ba59abbe56e057f20f883e |
+----------------------------------+
1 row in set (0.06 sec)
```
## MySQL字符集
从本质上来说,计算机只能识别二进制代码,因此,不论是计算机程序还是其处理的数据,最终都必须转换成二进制码,计算机才能认识。
为了使计算机不仅能做科学计算,也能处理文字信息,人们想出了给每个文字符号编码以便于计算机识别处理的办法,这就是计算机字符集的由来。
下面将详细介绍字符集的发展历程以及MySQL 中字符集的使用。
### 字符集概述
简单地说字符集就是一套文字符号及其编码、比较规则的集合。
1960 年代初期,美国标准化组织 ANSI 发布了第一个计算机字符集──ASCII(American Standard Code for Information Interchange),后来进一步变成了国际标准 ISO-646。这个字符集采用7位编码, 定义了包括大小写英文字母、阿拉伯数字和标点符号,以及 33 个控制符号等。虽然现在看 来,这个美式的字符集很简单,包括的符号也很少,但直到今天它依然是计算机世界里奠基 性的标准,其后制定的各种字符集基本都兼容 ASCII 字符集。
自 ASCII 之后,为了处理不同的文字,各大计算机公司、各国政府、标准化组织等先后 发明了几百种字符集,如大家熟悉的 ISO-8859 系列、GB2312-80、GBK、BIG5 等。这些五花 八门的字符集,从收录的字符到编码规则各不相同,给计算机软件开发和移植带来了很大困 难。一个软件要在使用不同文字的国家或地区发布,必须进行本地化开发!基于这个原因,统一字符编码,成了 1980 年代计算机业的迫切需要和普遍共识。
### Unicode简述
为了统一字符编码,国际标准化组织ISO(International Organization for Standardization)的一 些成员国于1984年发起制定新的国际字符集标准,以容纳全世界各种语言文字和符号。这个标准最后叫做“Universal Multiple-Octet Coded Character Set”,简称UCS,标准编号则定为 ISO-10646。
ISO-10646标准采用4字节(32bit)编码,因此简称UCS-4。
具体编码规则是:将 代码空间划分为组(group)、面(plane)、行(row)和格(ceil);第1个字节代表组(group), 第2个字节代表面(plane),第3个字节代表行(row),第4个字节代表格(ceil),并规定字 符编码的第32位必须为0,且每个面(plane)的最后两个码位FFFEh和FFFFh保留不用;因此, ISO-1064共有128个群组(0~0x7F),每个群组有256个字面(00~0xFF),每个字面有256行 (00~0xFF),每行包括256格(0~0xFF),共有256 * 128 = 32,768 个字面,每个字面有256×256 -2=65,534个码位,合计65534×32768=2,147,418,112 个码位。
ISO-10646发布以后,遭到了部分美国计算机公司的反对。1988年Xerox公司提议制定新的以 16位编码的统一字符集Unicode,并联合Apple、IBM、DEC、Sun、Microsoft、Novell等公司成 立Unicode协会(The Unicode Consortium),并成立Unicode技术委员会(Unicode Technical Committee),专门负责Unicode文字的搜集、整理和编码,并于1991年推出了Unicode 1.0。
都是为了解决字符编码统一问题,ISO和Unicode协会却推出了两个不同的编码标准,这显然 是不利的。后来,大家都认识到了这一点,经过双方谈判,1991年10月达成协议,ISO将Unicode编码并入ISO-10646的0组0字面,叫作基本多语言文字面(Basic Multi-lingual Plane, BMP), 共有65,534个码位,并根据不同用途分为若干区域。除BMP外的32,767个字面又分为辅助字 面(supplementary planes)和专用字面(private use planes)两部分,辅助字面用以收录 ISO-10646后续搜集的各国文字,专用字面供使用者自定义收录ISO-10646未收录的文字符号。 其实,大部分用户只使用BMP字面就足够了,早期的ISO-10646-1标准也只要求实现BMP字面, 这样只需要2字节来编码就足够了,Unicode也正是这么做的,这叫作ISO-10646编码的基本 面形式,简称为UCS-2编码,UCS-2编码转换成UCS-4编码也很容易,只要在前面加两个取值 为0的字节即可。
ISO-10646的编码空间足以容纳人类从古至今使用过的所有文字和符号,但其实许多文字符 号都已经很少使用了,超过99%的在用文字符号都编入了BMP,因此,绝大部分情况下, Unicode的双字节编码方式都能满足需求,而这种双字节编码方式比起ISO-10646的4字节原 始编码来说,在节省内存和处理时间上都具有优势,这也是Unicode编码方式更流行的原因。 但如果万一要使用ISO-10646 BMP字面以外的文字怎么办呢?Unicode提出了名为UTF-16或 代理法(surrogates)的解决方案,UTF是UCS/Unicode Transformation Format 的缩写。UTF-16 的解决办法是:对BMP字面的编码保持二字节不变,对其他字面的文字按一定规则将其32 位编码转换为两个16位的Unicode编码,其两个字节的取值范围分别限定为0xD800~0xDBFF 和0xDC00~0xDFFF,因此,UTF-16共有(4×256)×(4×256)=1048576个码位。
虽然UTF-16解决了ISO-10646除BMP外第1至第15字面的编码问题,但当时的计算机和网络世 界还是ASCII的天下,只能处理单字节数据流,UTF-16在离开Unicode环境后,在传输和处理 中都存在问题。于是Unicode又提出了名为UTF-8的解决方案,UTF-8按一定规则将一个 ISO-10646或Unicode字元码转换成1至4个字节的编码,其中将ASCII码(0~0x7F)转换成单 字节编码,也就是严格兼容ASCII字符集;UTF-8的2字节编码,用以转换ISO-10646标准 0x0080~0x07FF的UCS-4原始码;UTF-8的3字节编码,用以转换ISO-10646标准 0x0800~ 0xFFFF的UCS-4原始码;UTF-8的4字节编码,用以转换ISO-10646标准 0x00010000~0001FFFF 的UCS-4原始码。
上述各种编码方式,看起来有点让人迷惑。其实,ISO-10646只是给每一个文字符号分配了 一个4字节无符号整数编号(UCS-4),并未规定在计算机中如何去表示这个无符号整数编号。 UTF-16和UTF-8就是其两种变通表示方式。
ISO-10646与Unicode统一以后,两个组织虽然都继续发布各自的标准,但二者之间是一致的。 由于Unicode最早投入应用,其编码方式更加普及,因此,许多人都知道Unicode,但对ISO- 10646却了解不多。但由于二者是一致的,因此,区分ISO-10646和Unicode的意义也就不大 了。现在,大家说Unicode和ISO-10646,一般指的是同一个东西,只是Unicode更直接、更普 及罢了。
二者不同版本的对应关系如下。
Unicode 2.0等同于ISO/IEC 10646-1:1993。
Unicode 3.0等同于ISO/IEC 10646-1:2000。
Unicode 4.0等同于ISO/IEC 10646:2003。
最后要说的是,UTF-16和UTF-32因字节序的不同,又有了UTF-16BE(Big Endian)、UTF-16LE (Little Endian)和UTF-32BE(Big Endian)、UTF-32LE(Little Endian)等,在此不做进一步介绍。
## MySQL索引
索引是数据库中用来提高性能的最常用工具。本章主要介绍了MySQL 5.0 支持的索引类型, 并简单介绍了索引的设计原则。在后面的优化篇中,将会对索引做更多的介绍。
### 索引概述
所有 MySQL 列类型都可以被索引,对相关列使用索引是提高 SELECT 操作性能的最佳途径。
根据存储引擎可以定义每个表的最大索引数和最大索引长度,每种存储引擎(如 MyISAM、 InnoDB、BDB、MEMORY 等)对每个表至少支持 16 个索引,总索引长度至少为 256 字节。
大多数存储引擎有更高的限制。
MyISAM 和 InnoDB 存储引擎的表默认创建的都是 BTREE 索引。
MySQL 目前还不支持函数索引,但是支持前缀索引,即对索引字段的前 N 个字符创建索引。
前缀索引的长度跟存 储引擎相关,对于 MyISAM 存储引擎的表,索引的前缀长度可以达到 1000 字节长,而对于 InnoDB 存储引擎的表,索引的前缀长度最长是 767 字节。请注意前缀的限制应以字节为单位进行测量,而 CREATE TABLE 语句中的前缀长度解释为字符数。在为使用多字节字符集的列指定前缀长度时一定要加以考虑。
MySQL 中还支持全文本(FULLTEXT)索引,该索引可以用于全文搜索。但是当前最新版本中(5.0)只有 MyISAM 存储引擎支持 FULLTEXT 索引,并且只限于 CHAR、VARCHAR 和 TEXT 列。索引总是对整个列进行的,不支持局部(前缀)索引。
也可以为空间列类型创建索引,但是只有MyISAM 存储引擎支持空间类型索引,且索引的字段必须是非空的。
默认情况下,MEMORY 存储引擎使用 HASH 索引,但也支持 BTREE 索引。
索引在创建表的时候可以同时创建,也可以随时增加新的索引。
创建新索引的语法为:
```mysql
CREATE [UNIQUE|FULLTEXT|SPATIAL] INDEX index_name
[USING index_type]
ON tbl_name (index_col_name,...)
index_col_name: col_name [(length)] [ASC | DESC]
```
也可以使用 ALTER TABLE 的语法来增加索引,语法可 CREATE INDEX 类似,可以查询帮助获得详细的语法,这里不再复述。
例如,要为 city 表创建了 10 个字节的前缀索引,语法是:
```mysql
mysql> create index cityname on city (city(10));
Query OK, 600 rows affected (0.26 sec)
Records: 600 Duplicates: 0 Warnings: 0
```
如果以 city 为条件进行查询,可以发现索引 cityname 被使用:
```mysql
mysql> explain select * from city where city = 'Fuzhou' \G
*************************** 1. row ***************************
id: 1
select_type: SIMPLE
table: city
type: ref
possible_keys: cityname
key: cityname
key_len: 32
ref: const
rows: 1
Extra: Using where
1 row in set (0.00 sec)
```
索引的删除语法为:
```mysql
DROP INDEX index_name ON tbl_name
```
例如,想要删除 city 表上的索引 cityname,可以操作如下:
````mysql
mysql> drop index cityname on city;
Query OK, 600 rows affected (0.23 sec)
Records: 600 Duplicates: 0 Warnings: 0
````
### 设计索引的原则
索引的设计可以遵循一些已有的原则,创建索引的时候请尽量考虑符合这些原则,便于 提升索引的使用效率,更高效地使用索引。
搜索的索引列,不一定是所要选择的列。换句话说,最适合索引的列是出现在 WHERE 子句中的列,或连接子句中指定的列,而不是出现在 SELECT 关键字后的选择列表中的列。
使用惟一索引。考虑某列中值的分布。索引的列的基数越大,索引的效果越好。例 如,存放出生日期的列具有不同值,很容易区分各行。而用来记录性别的列,只含有“ M” 和“F”,则对此列进行索引没有多大用处,因为不管搜索哪个值,都会得出大约一半的行。
使用短索引。如果对字符串列进行索引,应该指定一个前缀长度,只要有可能就应 该这样做。例如,如果有一个 CHAR(200)列,如果在前 10 个或 20 个字符内,多数值是惟一 的,那么就不要对整个列进行索引。对前10个或20个字符进行索引能够节省大量索引空间, 也可能会使查询更快。较小的索引涉及的磁盘 IO 较少,较短的值比较起来更快。更为重要 的是,对于较短的键值,索引高速缓存中的块能容纳更多的键值,因此,MySQL 也可以在 内存中容纳更多的值。这样就增加了找到行而不用读取索引中较多块的可能性。
利用最左前缀。在创建一个n列的索引时,实际是创建了MySQL可利用的n个索引。 多列索引可起几个索引的作用,因为可利用索引中最左边的列集来匹配行。这样的列集称为最左前缀。
不要过度索引。不要以为索引“越多越好”,什么东西都用索引是错误的。每个额 外的索引都要占用额外的磁盘空间,并降低写操作的性能。在修改表的内容时,索引必须进 行更新,有时可能需要重构,因此,索引越多,所花的时间越长。如果有一个索引很少利用 或从不使用,那么会不必要地减缓表的修改速度。此外,MySQL 在生成一个执行计划时, 要考虑各个索引,这也要花费时间。创建多余的索引给查询优化带来了更多的工作。索引太 多,也可能会使 MySQL 选择不到所要使用的最好索引。只保持所需的索引有利于查询优化。
对于 InnoDB 存储引擎的表,记录默认会按照一定的顺序保存,如果有明确定义的主 键,则按照主键顺序保存。如果没有主键,但是有唯一索引,那么就是按照唯一索引的顺序 保存。如果既没有主键又没有唯一索引,那么表中会自动生成一个内部列,按照这个列的顺 序保存。按照主键或者内部列进行的访问是最快的,所以 InnoDB 表尽量自己指定主键,当 表中同时有几个列都是唯一的,都可以作为主键的时候,要选择最常作为访问条件的列作为 主键,提高查询的效率。另外,还需要注意,InnoDB 表的普通索引都会保存主键的键值, 所以主键要尽可能选择较短的数据类型,可以有效地减少索引的磁盘占用,提高索引的缓存 效果。
### BTREE 索引与 HASH索引
MEMORY 存储引擎的表可以选择使用 BTREE 索引或者 HASH 索引,两种不同类型的索引各有其不同的适用范围。
HASH 索引有一些重要的特征需要在使用的时候特别注意,如下所示。
只用于使用=或<=>操作符的等式比较。
优化器不能使用 HASH 索引来加速 ORDER BY 操作。
MySQL 不能确定在两个值之间大约有多少行。如果将一个 MyISAM 表改为 HASH 索 引的 MEMORY 表,会影响一些查询的执行效率。
只能使用整个关键字来搜索一行。
而对于 BTREE 索引,当使用>、<、>=、<=、BETWEEN、!=或者<>,或者 LIKE 'pattern'(其 中'pattern'不以通配符开始)操作符时,都可以使用相关列上的索引。
下列范围查询适用于 BTREE 索引和 HASH 索引:
```
SELECT * FROM t1 WHERE key_col = 1 OR key_col IN (15,18,20);
```
下列范围查询只适用于 BTREE 索引:
```
SELECT * FROM t1 WHERE key_col > 1 AND key_col < 10;
SELECT * FROM t1 WHERE key_col LIKE 'ab%' OR key_col BETWEEN 'lisa' AND 'simon';
```
例如,创建一个和 city 表完全相同的 MEMORY 存储引擎的表 city_memory:
```mysql
mysql> CREATE TABLE city_memory (
city_id SMALLINT UNSIGNED NOT NULL AUTO_INCREMENT,
city VARCHAR(50) NOT NULL,
country_id SMALLINT UNSIGNED NOT NULL,
last_update TIMESTAMP NOT NULL DEFAULT CURRENT_TIMESTAMP ON UPDATE
CURRENT_TIMESTAMP,
PRIMARY KEY (city_id),
KEY idx_fk_country_id (country_id)
)ENGINE=Memory DEFAULT CHARSET=utf8;
Query OK, 0 rows affected (0.03 sec)
mysql> insert into city_memory select * from city;
Query OK, 600 rows affected (0.00 sec)
Records: 600 Duplicates: 0 Warnings: 0
```
当对索引字段进行范围查询的时候,只有 BTREE 索引可以通过索引访问:
```
mysql> explain SELECT * FROM city WHERE country_id > 1 and country_id < 10 \G
*************************** 1. row ***************************
id: 1
select_type: SIMPLE
table: city
type: range
possible_keys: idx_fk_country_id
key: idx_fk_country_id
key_len: 2
ref: NULL
rows: 24
Extra: Using where
1 row in set (0.00 sec)
```
而 HASH 索引实际上是全表扫描的:
````
mysql> explain SELECT * FROM city_memory WHERE country_id > 1 and country_id < 10 \G
*************************** 1. row ***************************
id: 1
select_type: SIMPLE
table: city_memory
type: ALL
possible_keys: idx_fk_country_id
key: NULL
key_len: NULL
ref: NULL
rows: 600
Extra: Using where
1 row in set (0.00 sec)
````
了解了 BTREE索引和 HASH索引不同后,当使用MEMORY表的时候,如果是默认创建的HASH 索引,就要注意 SQL 语句的编写,确保可以使用上索引,如果一定要使用范围查询,那么 在创建索引的时候,就应该选择创建成 BTREE 索引。
## MySQL视图
MySQL 从 5.0.1 版本开始提供视图功能,下面将对 MySQL 中的视图进行介绍。
### 什么是视图
视图(View)是一种虚拟存在的表,对于使用视图的用户来说基本上是透明的。
视图并不在数据库中实际存在,行和列数据来自定义视图的查询中使用的表,并且是在使用视图时动态生成的。
视图相对于普通的表的优势主要包括以下几项。
简单:使用视图的用户完全不需要关心后面对应的表的结构、关联条件和筛选条件, 对用户来说已经是过滤好的复合条件的结果集。
安全:使用视图的用户只能访问他们被允许查询的结果集,对表的权限管理并不能 限制到某个行某个列,但是通过视图就可以简单的实现。
数据独立:一旦视图的结构确定了,可以屏蔽表结构变化对用户的影响,源表增加 列对视图没有影响;源表修改列名,则可以通过修改视图来解决,不会造成对访问 者的影响。
### 视图操作
视图的操作包括创建或者修改视图、删除视图,以及查看视图定义。
#### 创建或者修改视图
创建视图需要有 CREATE VIEW 的权限,并且对于查询涉及的列有 SELECT 权限。如果使用 CREATE OR REPLACE 或者 ALTER 修改视图,那么还需要该视图的 DROP 权限。
创建视图的语法为:
```mysql
CREATE [OR REPLACE] [ALGORITHM = {UNDEFINED | MERGE | TEMPTABLE}]
VIEW view_name [(column_list)]
AS select_statement
[WITH [CASCADED | LOCAL] CHECK OPTION]
```
修改视图的语法为:
```mysql
ALTER [ALGORITHM = {UNDEFINED | MERGE | TEMPTABLE}]
VIEW view_name [(column_list)]
AS select_statement
[WITH [CASCADED | LOCAL] CHECK OPTION]
```
例如,要创建了视图 staff_list_view,可以使用以下命令:
```mysql
mysql> CREATE OR REPLACE VIEW staff_list_view AS
SELECT s.staff_id,s.first_name,s.last_name,a.address
FROM staff AS s,address AS a
where s.address_id = a.address_id ;
Query OK, 0 rows affected (0.00 sec)
```
MySQL 视图的定义有一些限制,例如,在 FROM 关键字后面不能包含子查询,这和其他数 据库是不同的,如果视图是从其他数据库迁移过来的,那么可能需要因此做一些改动,可以 将子查询的内容先定义成一个视图,然后对该视图再创建视图就可以实现类似的功能了。
视图的可更新性和视图中查询的定义有关系,以下类型的视图是不可更新的。
包含以下关键字的 SQL 语句:聚合函数(SUM、MIN、MAX、COUNT 等)、DISTINCT、GROUP BY、HAVING、UNION 或者 UNION ALL。
常量视图。
SELECT 中包含子查询。
JION。
FROM 一个不能更新的视图。
WHERE 字句的子查询引用了 FROM 字句中的表。
例如,以下的视图都是不可更新的:
包含聚合函数
```
mysql> create or replace view payment_sum as
-> select staff_id,sum(amount) from payment group by staff_id;
Query OK, 0 rows affected (0.00 sec)
```
常量视图
```
mysql> create or replace view pi as select 3.1415926 as pi;
Query OK, 0 rows affected (0.00 sec)
```
select 中包含子查询
```
mysql> create view city_view as
select (select city from city where city_id = 1) ;
Query OK, 0 rows affected (0.00 sec)
```
WITH [CASCADED | LOCAL] CHECK OPTION决定了是否允许更新数据使记录不再满足视图的条 件。这个选项与 Oracle 数据库中的选项是类似的,其中:
LOCAL 是只要满足本视图的条件就可以更新;
CASCADED 则是必须满足所有针对该视图的所有视图的条件才可以更新。
如果没有明确是 LOCAL 还是 CASCADED,则默认是 CASCADED。
例如,对 payment 表创建两层视图,并进行更新操作:
```
mysql> create or replace view payment_view as
select payment_id,amount from payment
where amount < 10 WITH CHECK OPTION;
Query OK, 0 rows affected (0.00 sec)
mysql> create or replace view payment_view1 as
select payment_id,amount from payment_view
where amount > 5 WITH LOCAL CHECK OPTION;
Query OK, 0 rows affected (0.00 sec)
mysql> create or replace view payment_view2 as
select payment_id,amount from payment_view
where amount > 5 WITH CASCADED CHECK OPTION;
Query OK, 0 rows affected (0.00 sec)
mysql> select * from payment_view1 limit 1;
+------------+--------+
?
| payment_id | amount |
+------------+--------+
| 3 | 5.99 |
+------------+--------+
1 row in set (0.00 sec)
mysql> update payment_view1 set amount=10
where payment_id = 3;
Query OK, 1 row affected (0.03 sec)
Rows matched: 1 Changed: 1 Warnings: 0
mysql> update payment_view2 set amount=10
where payment_id = 3;
ERROR 1369 (HY000): CHECK OPTION failed 'sakila.payment_view2'
```
从测试结果可以看出,payment_view1 是 WITH LOCAL CHECK OPTION 的,所以只要满足本视 图的条件就可以更新,但是 payment_view2 是 WITH CASCADED CHECK OPTION 的,必须满足针对该视图的所有视图才可以更新,因为更新后记录不再满足 payment_view 的条件,所以 更新操作提示错误退出。
#### 删除视图
用户可以一次删除一个或者多个视图,前提是必须有该视图的 DROP 权限。
```mysql
DROP VIEW [IF EXISTS] view_name [, view_name] ...[RESTRICT | CASCADE]
```
例如,删除 staff_list 视图:
```mysql
mysql> drop view staff_list;
Query OK, 0 rows affected (0.00 sec)
```
#### 查看视图
从 MySQL 5.1 版本开始,使用 SHOW TABLES 命令的时候不仅显示表的名字,同时也会显示视图的名字,而不存在单独显示视图的 SHOW VIEWS命令。
```
mysql> use sakila
Database changed
mysql> show tables;
+----------------------------+
| Tables_in_sakila |
+----------------------------+
……
| staff |
| staff_list |
| store |
+----------------------------+
26 rows in set (0.00 sec)
```
同样,在使用 SHOW TABLE STATUS 命令的时候,不但可以显示表的信息,同时也可以显示视图的信息。
所以,可以通过下面的命令显示视图的信息:
```
SHOW TABLE STATUS [FROM db_name] [LIKE 'pattern']
```
下面演示的是查看 staff_list 视图信息的操作:
```
mysql> show table status like 'staff_list' \G
*************************** 1. row ***************************
Name: staff_list
Engine: NULL
Version: NULL
Row_format: NULL
Rows: NULL
Avg_row_length: NULL
Data_length: NULL
Max_data_length: NULL
Index_length: NULL
Data_free: NULL
Auto_increment: NULL
Create_time: NULL
Update_time: NULL
Check_time: NULL
Collation: NULL
Checksum: NULL
Create_options: NULL
Comment: VIEW
1 row in set (0.01 sec)
```
如果需要查询某个视图的定义,可以使用 SHOW CREATE VIEW 命令进行查看:
```
mysql> show create view staff_list \G
*************************** 1. row ***************************
View: staff_list
Create View: CREATE ALGORITHM=UNDEFINED DEFINER=`root`@`localhost` SQL SECURITY DEFINER
VIEW `staff_list` AS select `s`.`staff_id` AS `ID`,concat(`s`.`first_name`,_utf8'
',`s`.`last_name`) AS `name`,`a`.`address` AS `address`,`a`.`postal_code` AS `zip
code`,`a`.`phone` AS `phone`,`city`.`city` AS `city`,`country`.`country` AS
`country`,`s`.`store_id` AS `SID` from (((`staff` `s` join `address` `a` on((`s`.`address_id`
= `a`.`address_id`))) join `city` on((`a`.`city_id` = `city`.`city_id`))) join `country`
on((`city`.`country_id` = `country`.`country_id`)))
1 row in set (0.00 sec)
```
最后,通过查看系统表 information_schema.views 也可以查看视图的相关信息:
```
mysql> select * from views where table_name = 'staff_list' \G
*************************** 1. row ***************************
TABLE_CATALOG: NULL
TABLE_SCHEMA: sakila
TABLE_NAME: staff_list
VIEW_DEFINITION: select `s`.`staff_id` AS `ID`,concat(`s`.`first_name`,_utf8'
',`s`.`last_name`) AS `name`,`a`.`address` AS `address`,`a`.`postal_code` AS `zip
code`,`a`.`phone` AS `phone`,`sakila`.`city`.`city` AS `city`,`sakila`.`country`.`country` AS
`country`,`s`.`store_id` AS `SID` from (((`sakila`.`staff` `s` join `sakila`.`address` `a`
on((`s`.`address_id` = `a`.`address_id`))) join `sakila`.`city` on((`a`.`city_id` =
`sakila`.`city`.`city_id`))) join `sakila`.`country` on((`sakila`.`city`.`country_id` =
`sakila`.`country`.`country_id`)))
CHECK_OPTION: NONE
IS_UPDATABLE: YES
DEFINER: root@localhost
SECURITY_TYPE: DEFINER
1 row in set (0.00 sec)
```
## MySQL存储过程和函数
MySQL 从 5.0 版本开始支持存储过程和函数。
### 什么是存储过程和函数
存储过程和函数是事先经过编译并存储在数据库中的一段 SQL 语句的集合,调用存储过程 和函数可以简化应用开发人员的很多工作,减少数据在数据库和应用服务器之间的传输,对于提高数据处理的效率是有好处的。
存储过程和函数的区别在于函数必须有返回值,而存储过程没有,存储过程的参数可以使用 IN、OUT、INOUT 类型,而函数的参数只能是 IN 类型的。如果有函数从其他类型的数据库迁 移到 MySQL,那么就可能因此需要将函数改造成存储过程。
存储过程和函数的相关操作
在对存储过程或函数进行操作时,需要首先确认用户是否具有相应的权限。例如,创建存储 过程或者函数需要 CREATE ROUTINE 权限,修改或者删除存储过程或者函数需要 ALTER ROUTINE 权限,执行存储过程或者函数需要 EXECUTE 权限。
### 创建、修改存储过程或者函数
创建、修改存储过程或者函数的语法:
```
CREATE PROCEDURE sp_name ([proc_parameter[,...]])
[characteristic ...] routine_body
CREATE FUNCTION sp_name ([func_parameter[,...]])
RETURNS type
[characteristic ...] routine_body
proc_parameter:
[ IN | OUT | INOUT ] param_name type
func_parameter:
param_name type
type:
Any valid MySQL data type
characteristic:
LANGUAGE SQL
| [NOT] DETERMINISTIC
| { CONTAINS SQL | NO SQL | READS SQL DATA | MODIFIES SQL DATA }
| SQL SECURITY { DEFINER | INVOKER }
| COMMENT 'string'
routine_body:
Valid SQL procedure statement or statements
ALTER {PROCEDURE | FUNCTION} sp_name [characteristic ...]
characteristic:
{ CONTAINS SQL | NO SQL | READS SQL DATA | MODIFIES SQL DATA }
| SQL SECURITY { DEFINER | INVOKER }
| COMMENT 'string'
```
调用过程的语法如下:
```
CALL sp_name([parameter[,...]])
```
MySQL 的存储过程和函数中允许包含 DDL 语句,也允许在存储过程中执行提交(Commit, 即确认之前的修改)或者回滚(Rollback,即放弃之前的修改),但是存储过程和函数中不允 许执行 LOAD DATA INFILE 语句。
此外,存储过程和函数中可以调用其他的过程或者函数。 下面创建了一个新的过程 film_in_stock:
```mysql
mysql> DELIMITER $$
mysql>
mysql> CREATE PROCEDURE film_in_stock(IN p_film_id INT, IN p_store_id INT,OUT p_film_count INT)
READS SQL DATA
BEGIN
SELECT inventory_id
FROM inventory
WHERE film_id = p_film_id
AND store_id = p_store_id
AND inventory_in_stock(inventory_id);
SELECT FOUND_ROWS() INTO p_film_count;
END $$
Query OK, 0 rows affected (0.00 sec)
mysql>
mysql> DELIMITER ;
```
上面是在使用的样例数据库中创建的一个过程,该过程用来检查 film_id 和 store_id 对应的 inventory 是否满足要求,并且返回满足要求的 inventory_id 以及满足要求的记录数。 通常我们在执行创建过程和函数之前,都会通过“DELIMITER $$”命令将语句的结束符从“;” 修改成其他符号,这里使用的是“$$”,这样在过程和函数中的“;”就不会被 MySQL 解释 成语句的结束而提示错误。在存储过程或者函数创建完毕,通过“DELIMITER ;”命令再将结 束符改回成“;”。
可以看到在这个过程中调用了函数 inventory_in_stock(),并且这个过程有两个输入参数和一 个输出参数。下面可以通过调用这个过程来看看返回的结果。
如果需要检查 film_id=2 store_id=2 对应的 inventory 的情况,则首先手工执行过程中的 SQL 语句,以查看执行的效果:
```
mysql> SELECT inventory_id
-> FROM inventory
-> WHERE film_id = 2
-> AND store_id = 2
-> AND inventory_in_stock(inventory_id);
+--------------+
| inventory_id |
+--------------+
| 10 |
| 11 |
+--------------+
2 rows in set (0.00 sec)
```
满足条件的记录应该是两条,inventory_id 分别是 10 和 11。如果将这个查询封装在存储过 程中调用,那么调用过程的执行情况如下:
```
mysql> CALL film_in_stock(2,2,@a);
+--------------+
| inventory_id |
+--------------+
| 10 |
| 11 |
+--------------+
2 rows in set (0.00 sec)
Query OK, 0 rows affected (0.00 sec)
mysql> select @a;
+------+
| @a |
+------+
| 2 |
+------+
1 row in set (0.00 sec)
```
可以看到调用存储过程与直接执行 SQL 的效果是相同的,但是存储过程的好处在于处理逻 辑都封装在数据库端,调用者不需要了解中间的处理逻辑,一旦处理逻辑发生变化,只需要 修改存储过程即可,而对调用者的程序完全没有影响。
另外,和视图的创建语法稍有不同,存储过程和函数的 CREATE 语法不支持使用 CREATE OR REPLACE 对存储过程和函数进行修改,如果需要对已有的存储过程或者函数进行修改,需要 执行 ALTER 语法。
下面对 characteristic 特征值的部分进行简单的说明。
LANGUAGE SQL:说明下面过程的 BODY 是使用 SQL 语言编写,这条是系统默认的, 为今后 MySQL 会支持的除 SQL 外的其他语言支持的存储过程而准备。
[NOT] DETERMINISTIC:DETERMINISTIC确定的,即每次输入一样输出也一样的程序, NOT DETERMINISTIC 非确定的,默认是非确定的。当前,这个特征值还没有被优化 程序使用。
{ CONTAINS SQL | NO SQL | READS SQL DATA | MODIFIES SQL DATA }:这些特征值提供 子程序使用数据的内在信息,这些特征值目前只是提供给服务器,并没有根据这些 特征值来约束过程实际使用数据的情况。CONTAINS SQL 表示子程序不包含读或写 数据的语句。NO SQL 表示子程序不包含 SQL 语句。READS SQL DATA 表示子程序包 含读数据的语句,但不包含写数据的语句。MODIFIES SQL DATA 表示子程序包含写 数据的语句。如果这些特征没有明确给定,默认使用的值是 CONTAINS SQL。
SQL SECURITY { DEFINER | INVOKER }:可以用来指定子程序该用创建子程序者的许 可来执行,还是使用调用者的许可来执行。默认值是 DEFINER。
COMMENT 'string':存储过程或者函数的注释信息。
下面的例子对比了SQL SECURITY特征值的不同,使用root用户创建了两个相似的存储过程,
分别指定使用创建者的权限执行和调用者的权限执行,然后使用一个普通用户调用这两个存 储过程,对比执行的效果: 首先用 root 用户创建以下两个存储过程 film_in_stock_definer 和 film_in_stock_invoker:
```mysql
mysql> DELIMITER $$
mysql>
mysql> CREATE PROCEDURE film_in_stock_definer(IN p_film_id INT, IN p_store_id INT, OUT
p_film_count INT)
-> SQL SECURITY DEFINER
-> BEGIN
-> SELECT inventory_id
-> FROM inventory
-> WHERE film_id = p_film_id
-> AND store_id = p_store_id
-> AND inventory_in_stock(inventory_id);
->
-> SELECT FOUND_ROWS() INTO p_film_count;
-> END $$
Query OK, 0 rows affected (0.00 sec)
mysql>
mysql> CREATE PROCEDURE film_in_stock_invoker(IN p_film_id INT, IN p_store_id INT, OUT
p_film_count INT)
-> SQL SECURITY INVOKER
-> BEGIN
-> SELECT inventory_id
-> FROM inventory
-> WHERE film_id = p_film_id
-> AND store_id = p_store_id
-> AND inventory_in_stock(inventory_id);
->
-> SELECT FOUND_ROWS() INTO p_film_count;
-> END $$
Query OK, 0 rows affected (0.00 sec)
mysql>
mysql> DELIMITER ;
```
给普通用户 lisa赋予可以执行存储过程的权限,但是不能查询 inventory 表:
```
mysql> GRANT EXECUTE ON sakila.* TO 'lisa'@'localhost';
Query OK, 0 rows affected (0.00 sec)
```
使用 lisa 登录后,直接查询 inventory 表会提示查询被拒绝:
```
mysql> select count(*) from inventory;
ERROR 1142 (42000): SELECT command denied to user 'lisa'@'localhost' for table 'inventory'
```
lisa 用户分别调用 film_in_stock_definer 和 film_in_stock_invoker:
```
mysql> CALL film_in_stock_definer(2,2,@a);
+--------------+
| inventory_id |
+--------------+
| 10 |
| 11 |
+--------------+
2 rows in set (0.03 sec)
Query OK, 0 rows affected (0.03 sec)
mysql> CALL film_in_stock_invoker(2,2,@a);
ERROR 1142 (42000): SELECT command denied to user 'lisa'@'localhost' for table 'inventory'
```
从上面的例子可以看出,film_in_stock_definer 是以创建者的权限执行的,因为是 root 用户 创建的,所以可以访问 inventory 表的内容,film_in_stock_invoker 是以调用者的权限执行的, lisa 用户没有访问 inventory 表的权限,所以会提示权限不足。
### 删除存储过程或者函数
一次只能删除一个存储过程或者函数,删除存储过程或者函数需要有该过程或者函数的 ALTER ROUTINE 权限,具体语法如下:
```
DROP {PROCEDURE | FUNCTION} [IF EXISTS] sp_name
```
例如,使用 DROP 语法删除 film_in_stock 过程:
```
mysql> DROP PROCEDURE film_in_stock;
Query OK, 0 rows affected (0.00 sec)
```
### 查看存储过程或者函数
存储过程或者函数创建后,用户可能需要查看存储过程或者函数的状态或者定义等信息,便 于了解存储过程或者函数的基本情况。下面将介绍如何查看存储过程或函数相关信息。
#### 查看存储过程或者函数的状态
```
SHOW {PROCEDURE | FUNCTION} STATUS [LIKE 'pattern']
```
下面演示的是查看过程 film_in_stock的信息:
```
mysql> show procedure status like 'film_in_stock'\G
*************************** 1. row ***************************
Db: sakila
Name: film_in_stock
Type: PROCEDURE
Definer: root@localhost
Modified: 2007-07-06 09:29:00
Created: 2007-07-06 09:29:00
Security_type: DEFINER
Comment:
1 row in set (0.00 sec)
```
#### 查看存储过程或者函数的定义
```
SHOW CREATE {PROCEDURE | FUNCTION} sp_name
```
下面演示的是查看过程 film_in_stock的定义:
```
mysql> show create procedure film_in_stock \G
*************************** 1. row ***************************
Procedure: film_in_stock
sql_mode:
Create Procedure: CREATE DEFINER=`root`@`localhost` PROCEDURE `film_in_stock`(IN p_film_id
INT, IN p_store_id INT, OUT p_film_count INT)
READS SQL DATA
BEGIN
SELECT inventory_id
FROM inventory
WHERE film_id = p_film_id
AND store_id = p_store_id
AND inventory_in_stock(inventory_id);
SELECT FOUND_ROWS() INTO p_film_count;
END
1 row in set (0.00 sec)
```
#### 通过查看 information_schema. Routines 了解存储过程和函数的信息
除了以上两种方法,我们还可以查看系统表来了解存储过程和函数的相关信息,通过查看 information_schema. Routines 就可以获得存储过程和函数的包括名称、类型、语法、创建人 等信息。
例如,通过查看 information_schema. Routines 得到过程 film_in_stock 的定义:
```
mysql> select * from routines where ROUTINE_NAME = 'film_in_stock' \G
*************************** 1. row ***************************
SPECIFIC_NAME: film_in_stock
ROUTINE_CATALOG: NULL
ROUTINE_SCHEMA: sakila
ROUTINE_NAME: film_in_stock
ROUTINE_TYPE: PROCEDURE
DTD_IDENTIFIER: NULL
ROUTINE_BODY: SQL
ROUTINE_DEFINITION: BEGIN
SELECT inventory_id
FROM inventory
WHERE film_id = p_film_id
AND store_id = p_store_id
AND inventory_in_stock(inventory_id);
SELECT FOUND_ROWS() INTO p_film_count;
END
EXTERNAL_NAME: NULL
EXTERNAL_LANGUAGE: NULL
PARAMETER_STYLE: SQL
IS_DETERMINISTIC: NO
SQL_DATA_ACCESS: READS SQL DATA
SQL_PATH: NULL
SECURITY_TYPE: DEFINER
CREATED: 2007-07-06 09:29:00
LAST_ALTERED: 2007-07-06 09:29:00
SQL_MODE:
ROUTINE_COMMENT:
DEFINER: root@localhost
1 row in set (0.00 sec)
```
### 变量的使用
存储过程和函数中可以使用变量,而且在 MySQL 5.1 版本中,变量是不区分大小写的。
#### 变量的定义
通过 DECLARE 可以定义一个局部变量,该变量的作用范围只能在 BEGIN…END 块中,可以用 在嵌套的块中。变量的定义必须写在复合语句的开头,并且在任何其他语句的前面。可以一 次声明多个相同类型的变量。如果需要,可以使用 DEFAULT 赋默认值。
定义一个变量的语法如下:
```
DECLARE var_name[,...] type [DEFAULT value]
```
例如,定义一个 DATE 类型的变量,名称是 last_month_start:
```
DECLARE last_month_start DATE;
```
#### 变量的赋值
变量可以直接赋值,或者通过查询赋值。 直接赋值使用 SET,可以赋常量或者赋表达式,具体语法如下:
```
SET var_name = expr [, var_name = expr] ...
```
给刚才定义的变量 last_month_start 赋值,具体语法如下:
```
SET last_month_start = DATE_SUB(CURRENT_DATE(), INTERVAL 1 MONTH);
```
也可以通过查询将结果赋给变量,这要求查询返回的结果必须只有一行,具体语法如下:
```
SELECT col_name[,...] INTO var_name[,...] table_expr
```
通过查询将结果赋值给变量 v_payments:
```
CREATE FUNCTION get_customer_balance(p_customer_id INT,
p_effective_date DATETIME)
RETURNS DECIMAL(5,2)
DETERMINISTIC
READS SQL DATA
BEGIN
…
DECLARE v_payments DECIMAL(5,2); #SUM OF PAYMENTS MADE PREVIOUSLY
…
SELECT IFNULL(SUM(payment.amount),0) INTO v_payments
FROM payment
WHERE payment.payment_date <= p_effective_date
AND payment.customer_id = p_customer_id;
…
RETURN v_rentfees + v_overfees - v_payments;
END $$
```
### 定义条件和处理
条件的定义和处理可以用来定义在处理过程中遇到问题时相应的处理步骤。
#### 条件的定义
```
DECLARE condition_name CONDITION FOR condition_value
condition_value:
SQLSTATE [VALUE] sqlstate_value
| mysql_error_code
```
#### 条件的处理
```
DECLARE handler_type HANDLER FOR condition_value[,...] sp_statement
handler_type:
CONTINUE
| EXIT
| UNDO
condition_value:
SQLSTATE [VALUE] sqlstate_value
| condition_name
| SQLWARNING
| NOT FOUND
| SQLEXCEPTION
| mysql_error_code
```
下面将通过两个例子来说明:在向 actor 表中插入记录时,如果没有进行条件的处理,那么 在主键重的时候会抛出异常并退出,如果对条件进行了处理,那么就不会再抛出异常。
当没有进行条件处理时,执行结果如下:
```
mysql> select max(actor_id) from actor;
+---------------+
| max(actor_id) |
+---------------+
| 200 |
+---------------+
1 row in set (0.00 sec)
mysql> delimiter $$
mysql>
mysql> CREATE PROCEDURE actor_insert ()
-> BEGIN
-> SET @x = 1;
-> INSERT INTO actor(actor_id,first_name,last_name) VALUES (201,'Test','201');
-> SET @x = 2;
-> INSERT INTO actor(actor_id,first_name,last_name) VALUES (1,'Test','1');
-> SET @x = 3;
-> END;
-> $$ Query OK, 0 rows affected (0.00 sec)
mysql> delimiter ;
mysql> call actor_insert();
ERROR 1062 (23000): Duplicate entry '1' for key 'PRIMARY'
mysql> select @x;
+------+
| @x |
+------+
| 2 |
+------+
1 row in set (0.00 sec)
```
从上面的例子可以看出,执行到插入 actor_id=1 的记录时,会主键重并退出,没有执行到下 面其他的语句。
## MySQL触发器
MySQL 从 5.0.2 版本开始支持触发器的功能。触发器是与表有关的数据库对象,在满足定义 条件时触发,并执行触发器中定义的语句集合。触发器的这种特性可以协助应用在数据库端 确保数据的完整性。本章将详细介绍 MySQL 中触发器的使用方法。
### 创建触发器
创建触发器的语法如下:
```
CREATE TRIGGER trigger_name trigger_time trigger_event
ON tbl_name FOR EACH ROW trigger_stmt
```
注意:触发器只能创建在永久表(Permanent Table)上,不能对临时表(Temporary Table)创建触发器。
其中 trigger_time 是触发器的触发时间,可以是 BEFORE 或者 AFTER,BEFORE 的含义指在检 查约束前触发,而 AFTER 是在检查约束后触发。
而 trigger_event 就是触发器的触发事件,可以是 INSERT、UPDATE 或者 DELETE。 对同一个表相同触发时间的相同触发事件,只能定义一个触发器。例如,对某个表的不同字 段的 AFTER 更新触发器,在使用 Oracle 数据库的时候,可以定义成两个不同的 UPDATE 触发 器,更新不同的字段时触发单独的触发器,但是在 MYSQL 数据库中,只能定义成一个触发 器,在触发器中通过判断更新的字段进行对应的处理。
## MySQL事务
### 事务(Transaction)及其 ACID 属性
事务是由一组 SQL 语句组成的逻辑处理单元,事务具有以下 4 个属性,通常简称为事务的 ACID 属性。
原子性(Atomicity):事务是一个原子操作单元,其对数据的修改,要么全都执行, 要么全都不执行。
一致性(Consistent):在事务开始和完成时,数据都必须保持一致状态。这意味着 所有相关的数据规则都必须应用于事务的修改,以保持数据的完整性;事务结束时, 所有的内部数据结构(如 B 树索引或双向链表)也都必须是正确的。
隔离性(Isolation):数据库系统提供一定的隔离机制,保证事务在不受外部并发操 作影响的“独立”环境执行。这意味着事务处理过程中的中间状态对外部是不可见 的,反之亦然。
持久性(Durable):事务完成之后,它对于数据的修改是永久性的,即使出现系统 故障也能够保持。
银行转帐就是事务的一个典型例子。
### 事务控制
MySQL 通过 SET AUTOCOMMIT、START TRANSACTION、COMMIT 和 ROLLBACK 等语句支 持本地事务,具体语法如下。
```
START TRANSACTION | BEGIN [WORK]
COMMIT [WORK] [AND [NO] CHAIN] [[NO] RELEASE]
ROLLBACK [WORK] [AND [NO] CHAIN] [[NO] RELEASE]
SET AUTOCOMMIT = {0 | 1}
```
默认情况下,MySQL 是自动提交(Autocommit)的,如果需要通过明确的 Commit 和 Rollback 来提交和回滚事务,那么需要通过明确的事务控制命令来开始事务,这是和 Oracle 的事务管理明显不同的地方。如果应用是从 Oracle 数据库迁移到 MySQL 数据库,则需要确 保应用中是否对事务进行了明确的管理。
保应用中是否对事务进行了明确的管理。
START TRANSACTION 或 BEGIN 语句可以开始一项新的事务。
COMMIT 和 ROLLBACK 用来提交或者回滚事务。 CHAIN 和 RELEASE 子句分别用来定义在事务提交或者回滚之后的操作,CHAIN 会立 即启动一个新事物,并且和刚才的事务具有相同的隔离级别,RELEASE 则会断开和客户端的 连接。
SET AUTOCOMMIT 可以修改当前连接的提交方式,如果设置了 SET AUTOCOMMIT=0, 则设置之后的所有事务都需要通过明确的命令进行提交或者回滚。 如果只是对某些语句需要进行事务控制,则使用 START TRANSACTION 语句开始一个事务 比较方便,这样事务结束之后可以自动回到自动提交的方式,如果希望所有的事务都不是自 动提交的,那么通过修改 AUTOCOMMIT 来控制事务比较方便,这样不用在每个事务开始的 时候再执行 START TRANSACTION 语句。
如表 14-2 所示的例子演示了使用 START TRANSACTION 开始的事务在提交后自动回到自 动提交的方式;如果在提交的时候使用 COMMIT AND CHAIN,那么会在提交后立即开始一个 新的事务。
```
```
因此,在同一个事务中,最好不使用不同存储引擎的表,否则 ROLLBACK 时需要对非事 务类型的表进行特别的处理,因为 COMMIT、ROLLBACK 只能对事务类型的表进行提交和回 滚。
### 分布式事务的使用
MySQL 从 5.0.3 开始支持分布式事务,当前分布式事务只支持 InnoDB 存储引擎。一个 分布式事务会涉及多个行动,这些行动本身是事务性的。所有行动都必须一起成功完成,或 者一起被回滚。
## MySQL锁
锁是计算机协调多个进程或线程并发访问某一资源的机制。在数据库中,除传统的计算资源 (如 CPU、RAM、I/O 等)的争用以外,数据也是一种供许多用户共享的资源。如何保证数 据并发访问的一致性、有效性是所有数据库必须解决的一个问题,锁冲突也是影响数据库并 发访问性能的一个重要因素。从这个角度来说,锁对数据库而言显得尤其重要,也更加复杂。 本章我们着重讨论 MySQL 锁机制的特点,常见的锁问题,以及解决 MySQL 锁问题的一些方 法或建议。
### MySQL锁概述
相对其他数据库而言,MySQL的锁机制比较简单,其最显著的特点是不同的存储引擎支持不 同的锁机制。
比如,MyISAM和MEMORY存储引擎采用的是表级锁(table-level locking);
BDB 存储引擎采用的是页面锁(page-level locking),但也支持表级锁;
InnoDB存储引擎既支持行 级锁(row-level locking),也支持表级锁,但默认情况下是采用行级锁。
MySQL这3种锁的特性可大致归纳如下。
表级锁:开销小,加锁快;不会出现死锁;锁定粒度大,发生锁冲突的概率最高,并发 度最低。
行级锁:开销大,加锁慢;会出现死锁;锁定粒度最小,发生锁冲突的概率最低,并发 度也最高。
页面锁:开销和加锁时间界于表锁和行锁之间;会出现死锁;锁定粒度界于表锁和行锁 之间,并发度一般。
从上述特点可见,很难笼统地说哪种锁更好,只能就具体应用的特点来说哪种锁更合适! 仅从锁的角度来说:表级锁更适合于以查询为主,只有少量按索引条件更新数据的应用,如 Web 应用;而行级锁则更适合于有大量按索引条件并发更新少量不同数据,同时又有并发 查询的应用,如一些在线事务处理(OLTP)系统。这一点在本书的“开发篇”介绍表类型 的选择时,也曾提到过。下面几节我们重点介绍 MySQL 表锁和 InnoDB 行锁的问题,由于 BDB 已经被 InnoDB 取代,即将成为历史,在此就不做进一步的讨论了。
### MyISAM 表锁
MyISAM 存储引擎只支持表锁,这也是 MySQL 开始几个版本中唯一支持的锁类型。随着应用对事务完整性和并发性要求的不断提高,MySQL 才开始开发基于事务的存储引擎,后来慢慢出现了支持页锁的 BDB 存储引擎和支持行锁的 InnoDB 存储引擎(实际 InnoDB 是单独 的一个公司,现在已经被 Oracle 公司收购)。但是 MyISAM 的表锁依然是使用最为广泛的锁 类型。本节将详细介绍 MyISAM 表锁的使用。
#### 查询表级锁争用情况
可以通过检查table_locks_waited和table_locks_immediate状态变量来分析系统上的表锁 定争夺:
```
mysql> show status like 'table%';
+-----------------------+-------+
| Variable_name | Value |
+-----------------------+-------+
| Table_locks_immediate | 2979 |
| Table_locks_waited | 0 |
+-----------------------+-------+
2 rows in set (0.00 sec))
```
如果 Table_locks_waited的值比较高,则说明存在着较严重的表级锁争用情况。
#### MySQL表级锁的锁模式
MySQL 的表级锁有两种模式:表共享读锁(Table Read Lock)和表独占写锁(Table Write Lock)。 锁模式的兼容性如表 20-1 所示。
### InnoDB 锁问题
## MySQL注入
### SQL注入简介
结构化查询语言(SQL)是一种用来和数据库交互的文本语言。
SQL Injection 就是利用某些数据库的外部接口将用户数据插入到实际的数据库操作语言(SQL)当中,从而达到入 侵数据库乃至操作系统的目的。
它的产生主要是由于程序对用户输入的数据没有进行严格的过滤,导致非法数据库查询语句的执行。
SQL 注入(SQL Injection)攻击具有很大的危害,攻击者可以利用它读取、修改或者 删除数据库内的数据,获取数据库中的用户名和密码等敏感信息,甚至可以获得数据库管理员的权限,而且,SQL Injection 也很难防范。网站管理员无法通过安装系统补丁或者进行简 单的安全配置进行自我保护,一般的防火墙也无法拦截 SQL Injection 攻击。
## SQL Mode
与其他数据库不同,MySQL 可以运行不同的 SQL Mode(SQL 模式)下。SQL Mode 定义了 MySQL 应支持的 SQL 语法、数据校验等,这样可以更容易地在不同的环境中使用 MySQL。 本章将详细介绍常用的 SQL Mode 及其在实际中的应用。
### MySQL SQL Mode 简介
在 MySQL 中,SQL Mode 常用来解决下面几类问题。
通过设置 SQL Mode,可以完成不同严格程度的数据校验,有效地保障数据准确性。
通过设置 SQL Mode 为 ANSI 模式,来保证大多数 SQL 符合标准的 SQL 语法,这样应用在 不同数据库之间进行迁移时,则不需要对业务 SQL 进行较大的修改。
在不同数据库之间进行数据迁移之前,通过设置 SQL Mode 可以使 MySQL 上的数据更方 便地迁移到目标数据库中。
下面通过一个简单的实例,让大家了解如何使用 SQL Mode 实现数据校验。
在 MySQL 5.0 上,查询默认的 SQL Mode(sql_mode 参数)为:REAL_AS_FLOAT、 PIPES_AS_CONCAT、ANSI_QUOTES、GNORE_SPACE 和 ANSI。
在这种模式下允许插入超过字段 长度的值,只是在插入后,MySQL 会返回一个 warning。通过修改 sql_mode 为 STRICT_TRANS_TABLES(严格模式)实现了数据的严格校验,使错误数据不能插入表中,从 而保证了数据的准确性,具体实现如下。
查看默认 SQL Mode 的命令如下:
```
mysql> select @@sql_mode;
+-------------------------------------------------------------+
| @@sql_mode |
+-------------------------------------------------------------+
| REAL_AS_FLOAT,PIPES_AS_CONCAT,ANSI_QUOTES,IGNORE_SPACE,ANSI |
+-------------------------------------------------------------+
1 row in set (0.00 sec)
```
查看测试表 t 的表结构的命令如下:
```
mysql> desc t;
+-------+-------------+------+-----+---------+-------+
| Field | Type | Null | Key | Default | Extra |
+-------+-------------+------+-----+---------+-------+
| name | varchar(20) | YES | | NULL | |
| email | varchar(40) | YES | | NULL | |
+-------+-------------+------+-----+---------+-------+
2 rows in set (0.00 sec)
```
在表 t 中插入一条记录,其中 name 故意超出了实际的定义值 varchar(20):
````
mysql> insert into t values('12340000000000000000999999','beijing@126.com');
Query OK, 1 row affected, 1 warning (0.00 sec)
````
可以发现,记录可以插入,但是显示了一个 warning,查看 warning 内容:
```
mysql> show warnings;
+---------+------+-------------------------------------------+
| Level | Code | Message |
+---------+------+-------------------------------------------+
| Warning | 1265 | Data truncated for column 'name' at row 1 |
+---------+------+-------------------------------------------+
1 row in set (0.00 sec)
```
warning 提示对插入的 name 值进行了截断,从表 t 中查看实际插入值:
````
mysql> select * from t;
+----------------------+-----------------+
| name | email |
+----------------------+-----------------+
| 12340000000000000000 | beijing@126.com |
+----------------------+-----------------+
1 row in set (0.00 sec)
````
果然,记录虽然插入进去,但是只截取了前 20 位字符。
接下来设置 SQL Mode 为 STRICT_TRANS_TABLES(严格模式):
```
mysql> set session sql_mode='STRICT_TRANS_TABLES';
Query OK, 0 rows affected (0.01 sec)
mysql> select @@sql_mode;
+---------------------+
| @@sql_mode |
+---------------------+
| STRICT_TRANS_TABLES |
+---------------------+
1 row in set (0.01 sec)
```
再次尝试插入上面的测试记录:
```
mysql> insert into t values('12340000000000000000999999','beijing@126.com');
ERROR 1406 (22001): Data too long for column 'name' at row 1
```
结果发现,这次记录没有插入成功,给出了一个 ERROR,而不仅仅是 warning。
上 面 的 例 子 中 , 给 出 了 sql_mode 的 一 种 修 改 方 法 ,
即 SET [SESSION|GLOBAL] sql_mode='modes',其中 SESSION 选项表示只在本次连接中生效;
而 GLOBAL 选项表示在本次连接中并不生效,而对于新的连接则生效,这种方法在 MySQL 4.1 开始有效。
另外,也可 以通过使用“--sql-mode="modes"”选项,在 MySQL 启动时设置 sql_mode。 下面介绍一下 SQL Mode 的常见功能。
效验日期数据合法性,这是 SQL Mode 的一项常见功能。
在下面的例子中,观察一下非法日期“2007-04-31” (因为 4 月份没有 31 日)在不同 SQL Mode 下能否正确插入。
```
mysql> set session sql_mode='ANSI';
Query OK, 0 rows affected (0.00 sec)
mysql> create table t (d datetime);
Query OK, 0 rows affected (0.03 sec)
mysql> insert into t values('2007-04-31');
Query OK, 1 row affected, 1 warning (0.00 sec)
mysql> select * from t;
+---------------------+
| d |
+---------------------+
| 0000-00-00 00:00:00 |
+---------------------+
1 row in set (0.00 sec)
mysql> set session sql_mode='TRADITIONAL';
Query OK, 0 rows affected (0.00 sec)
mysql> insert into t values('2007-04-31');
ERROR 1292 (22007): Incorrect datetime value: '2007-04-31' for column 'd' at row 1
```
很显然,在 ANSI 模式下,非法日期可以插入,但是插入值却变为“0000-00-00 00:00:00”, 并且系统给出了 warning;而在 TRADITIONAL 模式下,在直接提示日期非法,拒绝插入。
在INSERT或UPDATE过程中,如果SQL MODE处于TRADITIONAL模式,运行MOD(X, 0)会产生错误,因为 TRADITIONAL 也属于严格模式,在非严格模式下 MOD(X,0)返回的结 果是 NULL,所以在含有 MOD 的运算中要根据实际情况设定好 sql_mode。
下面的实例展示了不同 sql_mode 下,MOD(X,0)返回的结果。
```
mysql> set sql_mode='ANSI' ;
Query OK, 0 rows affected (0.00 sec)
mysql> create table t (i int);
Query OK, 0 rows affected (0.02 sec)
mysql> insert into t values(9%0);
Query OK, 1 row affected (0.00 sec)
mysql> select * from t;
+------+
| i |
+------+
| NULL |
+------+
1 row in set (0.00 sec)
mysql> set session sql_mode='TRADITIONAL';
Query OK, 0 rows affected (0.00 sec)
mysql> insert into t values(9%0);
ERROR 1365 (22012): Division by 0
```
启用 NO_BACKSLASH_ESCAPES 模式,使反斜线成为普通字符。在导入数据时,如 果数据中含有反斜线字符,启用 NO_BACKSLASH_ESCAPES 模式保证数据的正确性,是个不错 的选择。
以下实例说明了启用 NO_BACKSLASH_ESCAPES 模式前后对反斜线“\”插入的变化。
```
mysql> set sql_mode='ansi';
Query OK, 0 rows affected (0.00 sec)
mysql> select @@sql_mode;
+-------------------------------------------------------------+
| @@sql_mode |
+-------------------------------------------------------------+
| REAL_AS_FLOAT,PIPES_AS_CONCAT,ANSI_QUOTES,IGNORE_SPACE,ANSI |
+-------------------------------------------------------------+
1 row in set (0.00 sec)
mysql> create table t (context varchar(20));
Query OK, 0 rows affected (0.04 sec)
mysql> insert into t values('\beijing');
Query OK, 1 row affected (0.00 sec)
mysql> select * from t;
+---------+
| context |
+---------+
|eijing |
+---------+
1 row in set (0.00 sec)
mysql> insert into t values('\\beijing');
Query OK, 1 row affected (0.00 sec)
mysql> select * from t;
+----------+
| context |
+----------+
|eijing |
| \beijing |
+----------+
2 rows in set (0.00 sec)
mysql>set
sql_mode='REAL_AS_FLOAT,PIPES_AS_CONCAT,ANSI_QUOTES,IGNORE_SPACE,ANSI,NO_BACKSLASH_ESCAPES';
Query OK, 0 rows affected (0.00 sec)
mysql> select @@sql_mode;
+----------------------------------------------------------------------------------+
| @@sql_mode |
+----------------------------------------------------------------------------------+
| REAL_AS_FLOAT,PIPES_AS_CONCAT,ANSI_QUOTES,IGNORE_SPACE,ANSI,NO_BACKSLASH_ESCAPES |
+----------------------------------------------------------------------------------+
1 row in set (0.00 sec)
mysql> insert into t values('\\beijing');
Query OK, 1 row affected (0.00 sec)
mysql> select * from t;
+-----------+
| context |
+-----------+
|eijing |
| \beijing |
| \\beijing |
+-----------+
3 rows in set (0.00 sec)
```
通过上面的实例可以看到,当在 ANSI 模式中增加了 NO_BACKSLASH_ESCAPES 模式后,反斜 线变为了普通字符。如果导入的数据存在反斜线,可以设置此模式,保证导入数据的正确性。
## MySQL正则表达式
### 正则表达式的使用
正则表达式(Regular Expression),是指一个用来描述或者匹配一系列符合某个句法规则的 字符串的单个字符串。在很多文本编辑器或其他工具裡,正则表达式通常被用来检索和/或 替换那些符合某个模式的文本内容。
许多程序设计语言都支持利用正则表达式进行字符串操作。
例如,在 Perl 中就内建了一个功能强大的正则表达式引擎。正则表达式这个概念最初 是由 UNIX 中的工具软件(例如 SED 和 GREP)普及开的,通常缩写成“REGEX”或者“REGEXP” 。 MySQL 利用 REGEXP 命令提供给用户扩展的正则表达式功能,REGEXP 实现的功能,类似 UNIX 上GREP和SED的功能,并且REGEXP在进行模式匹配时是区分大小写的。熟悉并掌握REGEXP 的功能可以使模式匹配工作事半功倍。
## 数据库名、表名大小写问题
在 MySQL 中,数据库对应操作系统下的数据目录。数据库中的每个表至少对应数据库目录 中的一个文件(也可能是多个,这取决于存储引擎) 。因此,所使用操作系统的大小写敏感 性决定了数据库名和表名的大小写敏感性。在大多数 UNIX 环境中,由于操作系统对大小写 的敏感性导致了数据库名和表名对大小写敏感性,而在 Windows 中由于操作系统本身对大小写不敏感,因此在 Windows 下 MySQL 数据库名和表名对大小写也不敏感。 列、索引、存储子程序和触发器名在任何平台上对大小写不敏感。默认情况下,表别名在 UNIX 中对大小写敏感,但在 Windows 或 Mac OS X 中对大小写不敏感。下面的查询在 UNIX 中会报错,因为它同时引用了别名 a 和 A:
```
mysql> select id from order_rab a where A.id = 1;
ERROR 1054 (42S22): Unknown column 'A.id' in 'where clause'
```
然而,该查询在 Windows 中是可以的。要想避免出现差别,最好采用一致的转换,例如, 总是用小写创建并引用数据库名和表名。
在 MySQL 中如何在硬盘上保存、使用表名和数据库名由 lower_case_tables_name 系统变量 决定,可以在启动 mysqld时设置这个系统变量。lower_case_tables_name 可以采用如表 17-2 所示的任一值。
## MySQL优化
## MySQL Server
## 磁盘I/O问题
作为应用系统的持久化层,不管数据库采取了什么样的 Cache 机制,但数据库最终总是要将数据储存到可以长久保存的I/O设备──磁盘上,但磁盘的存取速度显然要比CPU、 RAM 的速度慢很多,因此,对于比较大的数据库,磁盘 I/O 一般总会成为数据库的一个 性能瓶颈!
实际上,我们前面提到的 SQL优化、数据库对象优化、数据库参数优化,以及应用 程序优化等,大部分都是想通过减少或延缓磁盘读写来减轻磁盘 I/O 的压力及其对性能的 影响。解决磁盘 I/O 问题,减少或延缓磁盘操作肯定是一个重要方面,但磁盘 I/O 是不可 避免的,因此,增强磁盘 I/O 本身的性能和吞吐量也是一个重要方面。本章将从磁盘阵列、 符号链接、裸设备等更底层的方面来介绍提高磁盘 I/O 能力的一些技术和方法。
### 使用磁盘阵列
RAID 是 Redundant Array of Inexpensive Disks 的缩写,翻译成中文就是“廉价磁盘冗 余阵列”,通常就叫做磁盘阵列。RAID 就是按照一定策略将数据分布到若干物理磁盘上, 这样不仅增强了数据存储的可靠性,而且可以提高数据读写的整体性能,因为通过分布实 现了数据的“并行”读写。
RAID最早是用来取代大型计算机上高档存储设备的,相对于那些高档存储设备而言, RAID 的价格很便宜,这也是其名称中带有“廉价”一词的原因。但其实很长时间,对于 PC 机而言,其价格远远谈不上“廉价”!近几年,随着存储技术的发展,RAID开始变得真 正物美价廉了。
### 常见 RAID 级别及其特性
根据数据分布和冗余方式,RAID 分为许多级别,不同存储厂商提供的 RAID 卡或设备 支持的 RAID 级别也不尽相同,这里只介绍最常见也是最基本的几种,其他 RAID 级别基本 上都是在这几种基础上的改进。
### 如何选择 RAID 级别
### 虚拟文件卷或软 RAID
### 使用 Symbolic Links 分布 I/O
### 禁止操作系统更新文件的 atime 属性
### 用裸设备(Raw Device)存放 InnoDB 的共享表空间
## 应用优化
### 使用连接池
### 减少对 MySQL的访问
应用中需要理清对数据库的访问逻辑。能够一次连接就能够提取出所有结果的,就不用 两次连接,这样可以大大减少对数据库无谓的重复访问。
例如,在某应用中需要检索某人的年龄和性别,那么就可以执行以下查询:
```
Select old,gender from users where userid = 231;
```
之后又需要这个人的家庭住址,可以又执行:
```
Select address from users where userid = 231;
```
这样的话,就需要向数据库提交两次请求,数据库就要做两次查询操作,其实完全可以 用一句 SQL 语句得到想要的结果,然后把得到的结果放到变量中已备后用,比如:
```
Select old,gender,address from users where userid = 231;
```
不管读者是否相信,由于上面原因导致的性能问题,在很多应用系统中都存在,因此在 理清应用逻辑并向数据库提交请求前进行深思熟虑是很有必要的。
### 使用查询缓存
MySQL 的查询缓存(MySQL Query Cache)是在 4.1 版本以后新增的功能,它的作用是存 储 SELECT 查询的文本以及相应结果。如果随后收到一个相同的查询,服务器会从查询缓存 中重新得到查询结果,而不再需要解析和执行查询。
查询缓存的适用对象是更新不频繁的表,当表更改(包括表结构和表数据)后,查询缓 存值的相关条目被清空。
查询缓存相关的参数主要有以下几个:
```
mysql> show variables like '%query_cache%';
+------------------------------+---------+
| Variable_name | Value |
+------------------------------+---------+
| have_query_cache | YES |
| query_cache_limit | 1048576 |
| query_cache_min_res_unit | 4096 |
| query_cache_size | 0 |
| query_cache_type | OFF |
| query_cache_wlock_invalidate | OFF |
+------------------------------+---------+
6 rows in set (0.00 sec)
```
对于以上几个参数,具体解释如下。
have_query_cache 表明服务器在安装是否已经配置了高速缓存
query_cache_size 表明缓存区大小,单位为 M。
query_cache_type 的变量值从 0到 2,含义分别为:
0 或者 off(缓存关闭)
1 或者 on(缓存打开,使用 SQL_NO_CACHE 提示的 SELECT 除外)
2 或者 demand(只有带 SQL_CACHE 的 SELECT 语句提供高速缓存)
### 增加 CACHE 层
在应用中,我们可以在应用端加 CACHE 层来达到减轻数据库的负担的目的。CACHE 层有很 多种,也有很多种实现的方式,只要能达到降低数据库的负担,又能满足应用就可以,这就 需要根据应用的实际情况进行特殊处理。
### 负载均衡
## MySQL高级安装和升级
## MySQL中常用的工具
在 MySQL 的日常工作和管理中,用户经常会用到 MySQL 提供的各种管理工具,比如对象查 看、数据备份、日志分析等,熟练使用这些工具将会大大提高工作效率。
本章将给大家介绍 这些常用工具的使用,因为这些工具一般都有很多的选项参数,限于篇幅限制,不可能一一 详细介绍,只选择最常用的选项。
如果读者希望了解更多的选项,可以参考相应工具的帮助文档。
### mysql(客户端连接工具)
在 MySQL 提供的工具中,DBA(数据库管理员)使用最频繁的莫过于 mysql。
这里的“mysql” 不是指 MySQL 服务,也不是指 mysql 数据库,而是连接数据库的客户端工具。类似于 Oracle 数据库里的 sqlplus,是操作者和数据库之间的纽带和桥梁。
在前面章节的例子中,曾多次使用过 mysql 进行数据库的连接,大多数情况下,它的使用都非常简单,语法如下:
```
mysql [OPTIONS] [database]
```
这里的 OPTIONS 表示 mysql 的可用选项,可以一次写一个或者多个,甚至可以不写;
database 表示连接的数据库,一次只能写一个或者不写,如果不写,连接成功后需要用“use dbname” 命令来进入要操作的数据库。
下面介绍 mysql 的一些常用选项,这些选项通常有两种表达方式,
一种是“-”+选项单词的 缩写字符+选项值;
另外一种是“--”+选项的完整单词+“=”+选项的实际值。
例如,下面两种写法是完全等价的:
```
mysql --uroot
mysql --user=root
```
在下面的介绍中,如果有两种表达方式,都会用逗号隔开进行列出;否则将只显示一种表达方式。要了解更多的选项,读者可以用 mysql --help 命令进行查看。
#### 连接选项
```
-u, --user=name 指定用户名
-p, --password[=name] 指定密码
-h, --host=name 指定服务器 IP 或者域名
-P, --port=# 指定连接端口
```
这 4 个选项经常一起配合使用。
默认情况下,如果这些选项都不写,mysql 将会使用'用户 '@'localhost'和空密码连接本机(localhost)上的 3306端口。
空用户在 MySQL 刚刚安装完毕 后会自动生成,这也就是我们只使用一个“mysql”命令就可以连接到数据库的原因。如下 例中,使用“mysql”命令就可以直接到数据库。
```
[root@localhost mysql]# mysql
Welcome to the MySQL monitor. Commands end with ; or \g.
Your MySQL connection id is 71
Server version: 5.0.41-community-log MySQL Community Edition (GPL)
Type 'help;' or '\h' for help. Type '\c' to clear the buffer.
mysql>
```
可以查看一下当前的连接用户:
```
mysql> select current_user();
+----------------+
| current_user() |
+----------------+
| @localhost |
+----------------+
1 row in set (0.04 sec)
```
果然,系统使用了空用户进行了连接。大家可能会想,如果删除了空用户,那么用单纯的 “mysql”命令是不是就永远不能登录了呢?不是的,如果空用户被删除,mysql 会接着去 my.cnf 里面去找[client]组内的用户名和密码,如果有则按照此用户名和密码进行登录;如果 没有记录此选项,则系统会使用'root'@'localhost'用户进行登录。来看下面的例子,my.cnf 中有用户 z1,密码为空:
## myisampack(MyISAM 表压缩工具)
## MySQL日志
在任何一种数据库中,都会有各种各样的日志,记录着数据库工作的方方面面,以帮助数据 库管理员追踪数据库曾经发生过的各种事件。MySQL 也不例外,在 MySQL 中,有 4 种不同 的日志,分别是错误日志、二进制日志(BINLOG 日志)、查询日志和慢查询日志,这些日志 记录着数据库在不同方面的踪迹。本章将详细介绍这几种日志的作用和使用方法,希望读者 能充分利用这些日志对数据库进行各种维护和调优。
### 错误日志
错误日志是 MySQL 中最重要的日志之一,它记录了当 mysqld 启动和停止时,以及服务器在 运行过程中发生任何严重错误时的相关信息。当数据库出现任何故障导致无法正常使用时, 可以首先查看此日志。
可以用--log-error[=file_name]选项来指定mysqld (MySQL服务器)保存错误日志文件的位置。
如果没有给定 file_name 值,mysqld 使用错误日志名 host_name.err(host_name 为主机名) 并默认在参数 DATADIR(数据目录)指定的目录中写入日志文件。
以下是 MySQL 正常启动和关闭的一段日志,不同的版本可能略有不同:
````
[root@localhost mysql]# more localhost.localdomain.err
070727 04:24:46 mysqld started
InnoDB: The first specified data file ./ibdata1 did not exist:
InnoDB: a new database to be created!
070727 4:24:46 InnoDB: Setting file ./ibdata1 size to 10 MB
InnoDB: Database physically writes the file full: wait...
070727 4:24:46 InnoDB: Log file ./ib_logfile0 did not exist: new to be created
InnoDB: Setting log file ./ib_logfile0 size to 5 MB
InnoDB: Database physically writes the file full: wait...
070727 4:24:46 InnoDB: Log file ./ib_logfile1 did not exist: new to be created
InnoDB: Setting log file ./ib_logfile1 size to 5 MB
InnoDB: Database physically writes the file full: wait...
InnoDB: Doublewrite buffer not found: creating new
InnoDB: Doublewrite buffer created
InnoDB: Creating foreign key constraint system tables
InnoDB: Foreign key constraint system tables created
070727 4:24:47 InnoDB: Started; log sequence number 0 0
070727 4:24:47 [Note] /usr/sbin/mysqld: ready for connections.
Version: '5.0.41-community' socket: '/var/lib/mysql/mysql.sock' port: 3306 MySQL
Community Edition (GPL)
070727 6:20:27 [Note] /usr/sbin/mysqld: Normal shutdown
070727 6:20:27 InnoDB: Starting shutdown...
070727 6:20:28 InnoDB: Shutdown completed; log sequence number 0 43655
070727 6:20:28 [Note] /usr/sbin/mysqld: Shutdown complete
070727 06:20:28 mysqld ended
````
### 二进制日志
二进制日志(BINLOG)记录了所有的 DDL(数据定义语言)语句和 DML(数据操纵语言) 语句,但是不包括数据查询语句。语句以“事件”的形式保存,它描述了数据的更改过程。 此日志对于灾难时的数据恢复起着极其重要的作用。
#### 日志的位置和格式
当用--log-bin[=file_name]选项启动时,mysqld将包含所有更新数据的SQL命令写入日志文件。 如果没有给出 file_name 值,默认名为主机名后面跟“-bin”。如果给出了文件名,但没有包 含路径,则文件默认被写入参数 DATADIR(数据目录)指定的目录。
#### 日志的读取
由于日志以二进制方式存储,不能直接读取,需要用 mysqlbinlog 工具来查看,语法如下:
```
shell> mysqlbinlog log-file;
```
mysqlbinlog 的用法在上一章中已经详细介绍过,因此这里不再赘述。下面的例子演示了二进制日志的读取过程。
往测试表 emp 中插入两条测试记录。
```
[root@localhost mysql]# mysql -uroot
Welcome to the MySQL monitor. Commands end with ; or \g.
Your MySQL connection id is 8
Server version: 5.0.41-community-log MySQL Community Edition (GPL)
Type 'help;' or '\h' for help. Type '\c' to clear the buffer.
mysql> use test
Reading table information for completion of table and column names
You can turn off this feature to get a quicker startup with -A
Database changed
mysql> insert into emp values(1,'z1');
Query OK, 1 row affected (0.00 sec)
mysql> insert into emp values(1,'z2');
Query OK, 1 row affected (0.00 sec)
mysql> exit
Bye
```
使用 mysqlbinlog 工具进行日志查看,粗体字显示了步骤(1)中所做的操作。
```
[root@localhost mysql]# mysqlbinlog localhost-bin.000007
……
use test/*!*/;
SET TIMESTAMP=1186691584/*!*/;
SET @@session.foreign_key_checks=1, @@session.sql_auto_is_null=1,
@@session.unique_checks=1/*!*/;
SET @@session.sql_mode=0/*!*/;
/*!\C gbk *//*!*/;
SET
@@session.character_set_client=28,@@session.collation_connection=28,@@session.collation_serv
er=28/*!*/;
insert into emp values(1,'z1')/*!*/;
# at 191
#070810 4:33:07 server id 1 end_log_pos 284 Query thread_id=8 exec_time=0
error_code=0
SET TIMESTAMP=1186691587/*!*/;
insert into emp values(1,'z2')/*!*/;
DELIMITER ;
# End of log file
ROLLBACK /* added by mysqlbinlog */;
/*!50003 SET COMPLETION_TYPE=@OLD_COMPLETION_TYPE*/;
……
```
#### 日志的删除
## MySQL备份与恢复
备份和恢复在任何数据库里面都是非常重要的内容,好的备份方法和备份策略将会使得数据 库中的数据更加高效和安全。和很多数据库类似,MySQL 的备份也主要分为逻辑备份和物 理备份。本章将重点来介绍这两种方式的备份和恢复方法(本章例子全部在Linux AS4、MySQL 5.0.41 平台下测试通过)。
## MySQL权限与安全
## MySQL复制
## MySQL Cluster
MySQL实战
## MySQL常见问题
在 MySQL 日常开发或者维护工作中,用户经常会遇到各种各样的故障或者问题,比如密码 丢失、表损坏等。本章总结了一些常见的问题,希望对读者在遇到类似问题时有所帮助。
### 忘记 MySQL的 root 密码
经常会有朋友或者同事问起,MySQL 的 root 密码忘了,不知道改怎么办。其实解决方法很 简单,这在前面的章节中也曾提及,下面是详细的操作步骤。
登录到数据库所在服务器,手工 kill 掉MySQL 进程:
```
kill `cat /mysql-data-directory/hostname.pid`
```
其中,/mysql-data-directory/hostname.pid 指的是 MySQL 数据目录下的.pid 文件,它记录了 MySQL 服务的进程号。
使用--skip-grant-tables 选项重启 MySQL 服务:
```
[root@localhost mysql]# ./bin/mysqld_safe --skip-grant-tables --user=zzx &
[1] 20881
[root@localhost mysql]# Starting mysqld daemon with databases from /home/zzx/mysql/data
```
其中--skip-grant-tables 选项前面曾经介绍过,意思是启动 MySQL 服务的时候跳过权限表认证。 启动后,连接到MySQL 的 root 将不需要口令。
用空密码的 root 用户连接到 MySQL,并 且更改 root 口令:
```
[root@localhost mysql]# mysql -uroot
Welcome to the MySQL monitor. Commands end with ; or \g.
Your MySQL connection id is 53
Server version: 5.0.41-community-log MySQL Community Edition (GPL)
Type 'help;' or '\h' for help. Type '\c' to clear the buffer.
mysql>
mysql> set password = password('123');
ERROR 1290 (HY000): The MySQL server is running with the --skip-grant-tables option so it
cannot execute this statement
mysql> update user set password=password('123') where user='root' and host='localhost';
Query OK, 1 row affected (0.00 sec)
Rows matched: 1 Changed: 1 Warnings: 0
```
此时,由于使用了--skip-grant-tables 选项启动,使用“set password”命令更改密码失败,直 接更新 user 表的 password 字段后更改密码成功。
刷新权限表,使得权限认证重新生效:
```
mysql> flush privileges;
Query OK, 0 rows affected (0.00 sec)
```
重新用 root 登录时,必须输入新口令:
```
[root@localhost mysql]# mysql -uroot
ERROR 1045 (28000): Access denied for user 'root'@'localhost' (using password: NO)
[root@localhost mysql]# mysql -uroot -p123
Welcome to the MySQL monitor. Commands end with ; or \g.
Your MySQL connection id is 6 to server version: 5.1.11-beta-log
Type 'help;' or '\h' for help. Type '\c' to clear the buffer.
mysql>
```
注意:在 MySQL中,密码丢失后无法找回,只能通过上述方式修改密码。
### 如何处理 MyISAM 存储引擎的表损坏
# NULL 值处理
我们已经知道 MySQL 使用 SQL SELECT 命令及 WHERE 子句来读取数据表中的数据,但是当提供的查询条件字段为 NULL 时,该命令可能就无法正常工作。
为了处理这种情况,MySQL提供了三大运算符:
- **IS NULL:** 当列的值是 NULL,此运算符返回 true。
- **IS NOT NULL:** 当列的值不为 NULL, 运算符返回 true。
- **<=>:** 比较操作符(不同于=运算符),当比较的的两个值为 NULL 时返回 true。
关于 NULL 的条件比较运算是比较特殊的。你不能使用 = NULL 或 != NULL 在列中查找 NULL 值 。
在 MySQL 中,NULL 值与任何其它值的比较(即使是 NULL)永远返回 false,即 NULL = NULL 返回false 。
MySQL 中处理 NULL 使用 IS NULL 和 IS NOT NULL 运算符。
> **注意:**
>
> ```
> select * , columnName1+ifnull(columnName2,0) from tableName;
> ```
>
> columnName1,columnName2 为 int 型,当 columnName2 中,有值为 null 时,columnName1+columnName2=null, ifnull(columnName2,0) 把 columnName2 中 null 值转为 0。
------
## 在命令提示符中使用 NULL 值
以下实例中假设数据库 RUNOOB 中的表 runoob_test_tbl 含有两列 runoob_author 和 runoob_count, runoob_count 中设置插入NULL值。
### 实例
尝试以下实例:
## 创建数据表 runoob_test_tbl
root@host# mysql -u root -p password;
Enter password:*******
mysql> **USE** RUNOOB;
**DATABASE** changed
mysql> **CREATE** **TABLE** runoob_test_tbl
-> (
-> runoob_author **VARCHAR**(40) **NOT** **NULL**,
-> runoob_count **INT**
-> );
Query OK, 0 **ROWS** affected (0.05 sec)
mysql> **INSERT** **INTO** runoob_test_tbl (runoob_author, runoob_count) **VALUES** ('RUNOOB', 20);
mysql> **INSERT** **INTO** runoob_test_tbl (runoob_author, runoob_count) **VALUES** ('菜鸟教程', **NULL**);
mysql> **INSERT** **INTO** runoob_test_tbl (runoob_author, runoob_count) **VALUES** ('Google', **NULL**);
mysql> **INSERT** **INTO** runoob_test_tbl (runoob_author, runoob_count) **VALUES** ('FK', 20);
mysql> **SELECT** * **FROM** runoob_test_tbl;
+*---------------+--------------+*
| runoob_author | runoob_count |
+*---------------+--------------+*
| RUNOOB | 20 |
| 菜鸟教程 | **NULL** |
| Google | **NULL** |
| FK | 20 |
+*---------------+--------------+*
4 **ROWS** **IN** **SET** (0.01 sec)
以下实例中你可以看到 = 和 != 运算符是不起作用的:
mysql> **SELECT** * **FROM** runoob_test_tbl **WHERE** runoob_count = **NULL**;
Empty **SET** (0.00 sec)
mysql> **SELECT** * **FROM** runoob_test_tbl **WHERE** runoob_count != **NULL**;
Empty **SET** (0.01 sec)
查找数据表中 runoob_test_tbl 列是否为 NULL,必须使用 **IS NULL** 和 **IS NOT NULL**,如下实例:
mysql> **SELECT** * **FROM** runoob_test_tbl **WHERE** runoob_count **IS** **NULL**;
+*---------------+--------------+*
| runoob_author | runoob_count |
+*---------------+--------------+*
| 菜鸟教程 | **NULL** |
| Google | **NULL** |
+*---------------+--------------+*
2 **ROWS** **IN** **SET** (0.01 sec)
mysql> **SELECT** * **FROM** runoob_test_tbl **WHERE** runoob_count **IS** **NOT** **NULL**;
+*---------------+--------------+*
| runoob_author | runoob_count |
+*---------------+--------------+*
| RUNOOB | 20 |
| FK | 20 |
+*---------------+--------------+*
2 **ROWS** **IN** **SET** (0.01 sec)
# MySQL 正则表达式
在前面的章节我们已经了解到MySQL可以通过 **LIKE ...%** 来进行模糊匹配。
MySQL 同样也支持其他正则表达式的匹配, MySQL中使用 REGEXP 操作符来进行正则表达式匹配。
如果您了解PHP或Perl,那么操作起来就非常简单,因为MySQL的正则表达式匹配与这些脚本的类似。
下表中的正则模式可应用于 REGEXP 操作符中。
| 模式 | 描述 |
| :--------- | :----------------------------------------------------------- |
| ^ | 匹配输入字符串的开始位置。如果设置了 RegExp 对象的 Multiline 属性,^ 也匹配 '\n' 或 '\r' 之后的位置。 |
| $ | 匹配输入字符串的结束位置。如果设置了RegExp 对象的 Multiline 属性,$ 也匹配 '\n' 或 '\r' 之前的位置。 |
| . | 匹配除 "\n" 之外的任何单个字符。要匹配包括 '\n' 在内的任何字符,请使用象 '[.\n]' 的模式。 |
| [...] | 字符集合。匹配所包含的任意一个字符。例如, '[abc]' 可以匹配 "plain" 中的 'a'。 |
| [^...] | 负值字符集合。匹配未包含的任意字符。例如, '[^abc]' 可以匹配 "plain" 中的'p'。 |
| p1\|p2\|p3 | 匹配 p1 或 p2 或 p3。例如,'z\|food' 能匹配 "z" 或 "food"。'(z\|f)ood' 则匹配 "zood" 或 "food"。 |
| * | 匹配前面的子表达式零次或多次。例如,zo* 能匹配 "z" 以及 "zoo"。* 等价于{0,}。 |
| + | 匹配前面的子表达式一次或多次。例如,'zo+' 能匹配 "zo" 以及 "zoo",但不能匹配 "z"。+ 等价于 {1,}。 |
| {n} | n 是一个非负整数。匹配确定的 n 次。例如,'o{2}' 不能匹配 "Bob" 中的 'o',但是能匹配 "food" 中的两个 o。 |
| {n,m} | m 和 n 均为非负整数,其中n <= m。最少匹配 n 次且最多匹配 m 次。 |
### 实例
了解以上的正则需求后,我们就可以根据自己的需求来编写带有正则表达式的SQL语句。以下我们将列出几个小实例(表名:person_tbl )来加深我们的理解:
查找name字段中以'st'为开头的所有数据:
```
mysql> SELECT name FROM person_tbl WHERE name REGEXP '^st';
```
查找name字段中以'ok'为结尾的所有数据:
```
mysql> SELECT name FROM person_tbl WHERE name REGEXP 'ok$';
```
查找name字段中包含'mar'字符串的所有数据:
```
mysql> SELECT name FROM person_tbl WHERE name REGEXP 'mar';
```
查找name字段中以元音字符开头或以'ok'字符串结尾的所有数据:
```
mysql> SELECT name FROM person_tbl WHERE name REGEXP '^[aeiou]|ok$';
```
# MySQL 事务
MySQL 事务主要用于处理操作量大,复杂度高的数据。比如说,在人员管理系统中,你删除一个人员,你即需要删除人员的基本资料,也要删除和该人员相关的信息,如信箱,文章等等,这样,这些数据库操作语句就构成一个事务!
- 在 MySQL 中只有使用了 Innodb 数据库引擎的数据库或表才支持事务。
- 事务处理可以用来维护数据库的完整性,保证成批的 SQL 语句要么全部执行,要么全部不执行。
- 事务用来管理 insert,update,delete 语句
一般来说,事务是必须满足4个条件(ACID)::原子性(**A**tomicity,或称不可分割性)、一致性(**C**onsistency)、隔离性(**I**solation,又称独立性)、持久性(**D**urability)。
- **原子性:**一个事务(transaction)中的所有操作,要么全部完成,要么全部不完成,不会结束在中间某个环节。事务在执行过程中发生错误,会被回滚(Rollback)到事务开始前的状态,就像这个事务从来没有执行过一样。
- **一致性:**在事务开始之前和事务结束以后,数据库的完整性没有被破坏。这表示写入的资料必须完全符合所有的预设规则,这包含资料的精确度、串联性以及后续数据库可以自发性地完成预定的工作。
- **隔离性:**数据库允许多个并发事务同时对其数据进行读写和修改的能力,隔离性可以防止多个事务并发执行时由于交叉执行而导致数据的不一致。事务隔离分为不同级别,包括读未提交(Read uncommitted)、读提交(read committed)、可重复读(repeatable read)和串行化(Serializable)。
- **持久性:**事务处理结束后,对数据的修改就是永久的,即便系统故障也不会丢失。
> 在 MySQL 命令行的默认设置下,事务都是自动提交的,即执行 SQL 语句后就会马上执行 COMMIT 操作。因此要显式地开启一个事务务须使用命令 BEGIN 或 START TRANSACTION,或者执行命令 SET AUTOCOMMIT=0,用来禁止使用当前会话的自动提交。
### 事务控制语句:
- BEGIN 或 START TRANSACTION 显式地开启一个事务;
- COMMIT 也可以使用 COMMIT WORK,不过二者是等价的。COMMIT 会提交事务,并使已对数据库进行的所有修改成为永久性的;
- ROLLBACK 也可以使用 ROLLBACK WORK,不过二者是等价的。回滚会结束用户的事务,并撤销正在进行的所有未提交的修改;
- SAVEPOINT identifier,SAVEPOINT 允许在事务中创建一个保存点,一个事务中可以有多个 SAVEPOINT;
- RELEASE SAVEPOINT identifier 删除一个事务的保存点,当没有指定的保存点时,执行该语句会抛出一个异常;
- ROLLBACK TO identifier 把事务回滚到标记点;
- SET TRANSACTION 用来设置事务的隔离级别。InnoDB 存储引擎提供事务的隔离级别有READ UNCOMMITTED、READ COMMITTED、REPEATABLE READ 和 SERIALIZABLE。
### MYSQL 事务处理主要有两种方法:
1、用 BEGIN, ROLLBACK, COMMIT来实现
- **BEGIN** 开始一个事务
- **ROLLBACK** 事务回滚
- **COMMIT** 事务确认
2、直接用 SET 来改变 MySQL 的自动提交模式:
- **SET AUTOCOMMIT=0** 禁止自动提交
- **SET AUTOCOMMIT=1** 开启自动提交
## 事务测试
mysql> **USE** RUNOOB;
**DATABASE** changed
mysql> **CREATE** **TABLE** runoob_transaction_test( id **INT**(5)) engine=innodb; # 创建数据表
Query OK, 0 **ROWS** affected (0.04 sec)
mysql> **SELECT** * **FROM** runoob_transaction_test;
Empty **SET** (0.01 sec)
mysql> **BEGIN**; # 开始事务
Query OK, 0 **ROWS** affected (0.00 sec)
mysql> **INSERT** **INTO** runoob_transaction_test **VALUE**(5);
Query OK, 1 **ROWS** affected (0.01 sec)
mysql> **INSERT** **INTO** runoob_transaction_test **VALUE**(6);
Query OK, 1 **ROWS** affected (0.00 sec)
mysql> commit; # 提交事务
Query OK, 0 **ROWS** affected (0.01 sec)
mysql> **SELECT** * **FROM** runoob_transaction_test;
+*------+*
| id |
+*------+*
| 5 |
| 6 |
+*------+*
2 **ROWS** **IN** **SET** (0.01 sec)
mysql> **BEGIN**; # 开始事务
Query OK, 0 **ROWS** affected (0.00 sec)
mysql> **INSERT** **INTO** runoob_transaction_test **VALUES**(7);
Query OK, 1 **ROWS** affected (0.00 sec)
mysql> **ROLLBACK**; # 回滚
Query OK, 0 **ROWS** affected (0.00 sec)
mysql> **SELECT** * **FROM** runoob_transaction_test; # 因为回滚所以数据没有插入
+*------+*
| id |
+*------+*
| 5 |
| 6 |
+*------+*
2 **ROWS** **IN** **SET** (0.01 sec)
mysql>
# MySQL ALTER命令
当我们需要修改数据表名或者修改数据表字段时,就需要使用到MySQL ALTER命令。
开始本章教程前让我们先创建一张表,表名为:testalter_tbl。
```
root@host# mysql -u root -p password;
Enter password:*******
mysql> use RUNOOB;
Database changed
mysql> create table testalter_tbl
-> (
-> i INT,
-> c CHAR(1)
-> );
Query OK, 0 rows affected (0.05 sec)
mysql> SHOW COLUMNS FROM testalter_tbl;
+-------+---------+------+-----+---------+-------+
| Field | Type | Null | Key | Default | Extra |
+-------+---------+------+-----+---------+-------+
| i | int(11) | YES | | NULL | |
| c | char(1) | YES | | NULL | |
+-------+---------+------+-----+---------+-------+
2 rows in set (0.00 sec)
```
------
## 删除,添加或修改表字段
如下命令使用了 ALTER 命令及 DROP 子句来删除以上创建表的 i 字段:
```
mysql> ALTER TABLE testalter_tbl DROP i;
```
如果数据表中只剩余一个字段则无法使用DROP来删除字段。
MySQL 中使用 ADD 子句来向数据表中添加列,如下实例在表 testalter_tbl 中添加 i 字段,并定义数据类型:
```
mysql> ALTER TABLE testalter_tbl ADD i INT;
```
执行以上命令后,i 字段会自动添加到数据表字段的末尾。
```
mysql> SHOW COLUMNS FROM testalter_tbl;
+-------+---------+------+-----+---------+-------+
| Field | Type | Null | Key | Default | Extra |
+-------+---------+------+-----+---------+-------+
| c | char(1) | YES | | NULL | |
| i | int(11) | YES | | NULL | |
+-------+---------+------+-----+---------+-------+
2 rows in set (0.00 sec)
```
如果你需要指定新增字段的位置,可以使用MySQL提供的关键字 FIRST (设定位第一列), AFTER 字段名(设定位于某个字段之后)。
尝试以下 ALTER TABLE 语句, 在执行成功后,使用 SHOW COLUMNS 查看表结构的变化:
```
ALTER TABLE testalter_tbl DROP i;
ALTER TABLE testalter_tbl ADD i INT FIRST;
ALTER TABLE testalter_tbl DROP i;
ALTER TABLE testalter_tbl ADD i INT AFTER c;
```
FIRST 和 AFTER 关键字可用于 ADD 与 MODIFY 子句,所以如果你想重置数据表字段的位置就需要先使用 DROP 删除字段然后使用 ADD 来添加字段并设置位置。
------
## 修改字段类型及名称
如果需要修改字段类型及名称, 你可以在ALTER命令中使用 MODIFY 或 CHANGE 子句 。
例如,把字段 c 的类型从 CHAR(1) 改为 CHAR(10),可以执行以下命令:
```
mysql> ALTER TABLE testalter_tbl MODIFY c CHAR(10);
```
使用 CHANGE 子句, 语法有很大的不同。 在 CHANGE 关键字之后,紧跟着的是你要修改的字段名,然后指定新字段名及类型。尝试如下实例:
```
mysql> ALTER TABLE testalter_tbl CHANGE i j BIGINT;
mysql> ALTER TABLE testalter_tbl CHANGE j j INT;
```
------
## ALTER TABLE 对 Null 值和默认值的影响
当你修改字段时,你可以指定是否包含值或者是否设置默认值。
以下实例,指定字段 j 为 NOT NULL 且默认值为100 。
```
mysql> ALTER TABLE testalter_tbl
-> MODIFY j BIGINT NOT NULL DEFAULT 100;
```
如果你不设置默认值,MySQL会自动设置该字段默认为 NULL。
------
## 修改字段默认值
你可以使用 ALTER 来修改字段的默认值,尝试以下实例:
```
mysql> ALTER TABLE testalter_tbl ALTER i SET DEFAULT 1000;
mysql> SHOW COLUMNS FROM testalter_tbl;
+-------+---------+------+-----+---------+-------+
| Field | Type | Null | Key | Default | Extra |
+-------+---------+------+-----+---------+-------+
| c | char(1) | YES | | NULL | |
| i | int(11) | YES | | 1000 | |
+-------+---------+------+-----+---------+-------+
2 rows in set (0.00 sec)
```
你也可以使用 ALTER 命令及 DROP子句来删除字段的默认值,如下实例:
```
mysql> ALTER TABLE testalter_tbl ALTER i DROP DEFAULT;
mysql> SHOW COLUMNS FROM testalter_tbl;
+-------+---------+------+-----+---------+-------+
| Field | Type | Null | Key | Default | Extra |
+-------+---------+------+-----+---------+-------+
| c | char(1) | YES | | NULL | |
| i | int(11) | YES | | NULL | |
+-------+---------+------+-----+---------+-------+
2 rows in set (0.00 sec)
Changing a Table Type:
```
修改数据表类型,可以使用 ALTER 命令及 TYPE 子句来完成。尝试以下实例,我们将表 testalter_tbl 的类型修改为 MYISAM :
**注意:**查看数据表类型可以使用 SHOW TABLE STATUS 语句。
```
mysql> ALTER TABLE testalter_tbl ENGINE = MYISAM;
mysql> SHOW TABLE STATUS LIKE 'testalter_tbl'\G
*************************** 1. row ****************
Name: testalter_tbl
Type: MyISAM
Row_format: Fixed
Rows: 0
Avg_row_length: 0
Data_length: 0
Max_data_length: 25769803775
Index_length: 1024
Data_free: 0
Auto_increment: NULL
Create_time: 2007-06-03 08:04:36
Update_time: 2007-06-03 08:04:36
Check_time: NULL
Create_options:
Comment:
1 row in set (0.00 sec)
```
------
## 修改表名
如果需要修改数据表的名称,可以在 ALTER TABLE 语句中使用 RENAME 子句来实现。
尝试以下实例将数据表 testalter_tbl 重命名为 alter_tbl:
```
mysql> ALTER TABLE testalter_tbl RENAME TO alter_tbl;
```
ALTER 命令还可以用来创建及删除MySQL数据表的索引,该功能我们会在接下来的章节中介绍。
alter其他用途:
修改存储引擎:修改为myisam
```
alter table tableName engine=myisam;
```
删除外键约束:keyName是外键别名
```
alter table tableName drop foreign key keyName;
```
修改字段的相对位置:这里name1为想要修改的字段,type1为该字段原来类型,first和after二选一,这应该显而易见,first放在第一位,after放在name2字段后面
```
alter table tableName modify name1 type1 first|after name2;
```
# MySQL 索引
MySQL索引的建立对于MySQL的高效运行是很重要的,索引可以大大提高MySQL的检索速度。
打个比方,如果合理的设计且使用索引的MySQL是一辆兰博基尼的话,那么没有设计和使用索引的MySQL就是一个人力三轮车。
拿汉语字典的目录页(索引)打比方,我们可以按拼音、笔画、偏旁部首等排序的目录(索引)快速查找到需要的字。
索引分单列索引和组合索引。单列索引,即一个索引只包含单个列,一个表可以有多个单列索引,但这不是组合索引。组合索引,即一个索引包含多个列。
创建索引时,你需要确保该索引是应用在 SQL 查询语句的条件(一般作为 WHERE 子句的条件)。
实际上,索引也是一张表,该表保存了主键与索引字段,并指向实体表的记录。
上面都在说使用索引的好处,但过多的使用索引将会造成滥用。因此索引也会有它的缺点:虽然索引大大提高了查询速度,同时却会降低更新表的速度,如对表进行INSERT、UPDATE和DELETE。因为更新表时,MySQL不仅要保存数据,还要保存一下索引文件。
建立索引会占用磁盘空间的索引文件。
------
## 普通索引
### 创建索引
这是最基本的索引,它没有任何限制。它有以下几种创建方式:
```
CREATE INDEX indexName ON mytable(username(length));
```
如果是CHAR,VARCHAR类型,length可以小于字段实际长度;如果是BLOB和TEXT类型,必须指定 length。
### 修改表结构(添加索引)
```
ALTER table tableName ADD INDEX indexName(columnName)
```
### 创建表的时候直接指定
```
CREATE TABLE mytable(
ID INT NOT NULL,
username VARCHAR(16) NOT NULL,
INDEX [indexName] (username(length))
);
```
### 删除索引的语法
```
DROP INDEX [indexName] ON mytable;
```
------
## 唯一索引
它与前面的普通索引类似,不同的就是:索引列的值必须唯一,但允许有空值。如果是组合索引,则列值的组合必须唯一。它有以下几种创建方式:
### 创建索引
```
CREATE UNIQUE INDEX indexName ON mytable(username(length))
```
### 修改表结构
```
ALTER table mytable ADD UNIQUE [indexName] (username(length))
```
### 创建表的时候直接指定
```
CREATE TABLE mytable(
ID INT NOT NULL,
username VARCHAR(16) NOT NULL,
UNIQUE [indexName] (username(length))
);
```
------
## 使用ALTER 命令添加和删除索引
有四种方式来添加数据表的索引:
- ALTER TABLE tbl_name ADD PRIMARY KEY (column_list):
该语句添加一个主键,这意味着索引值必须是唯一的,且不能为NULL。
- **ALTER TABLE tbl_name ADD UNIQUE index_name (column_list):** 这条语句创建索引的值必须是唯一的(除了NULL外,NULL可能会出现多次)。
- **ALTER TABLE tbl_name ADD INDEX index_name (column_list):** 添加普通索引,索引值可出现多次。
- **ALTER TABLE tbl_name ADD FULLTEXT index_name (column_list):**该语句指定了索引为 FULLTEXT ,用于全文索引。
以下实例为在表中添加索引。
```
mysql> ALTER TABLE testalter_tbl ADD INDEX (c);
```
你还可以在 ALTER 命令中使用 DROP 子句来删除索引。尝试以下实例删除索引:
```
mysql> ALTER TABLE testalter_tbl DROP INDEX c;
```
------
## 使用 ALTER 命令添加和删除主键
主键只能作用于一个列上,添加主键索引时,你需要确保该主键默认不为空(NOT NULL)。实例如下:
```
mysql> ALTER TABLE testalter_tbl MODIFY i INT NOT NULL;
mysql> ALTER TABLE testalter_tbl ADD PRIMARY KEY (i);
```
你也可以使用 ALTER 命令删除主键:
```
mysql> ALTER TABLE testalter_tbl DROP PRIMARY KEY;
```
删除主键时只需指定PRIMARY KEY,但在删除索引时,你必须知道索引名。
------
## 显示索引信息
你可以使用 SHOW INDEX 命令来列出表中的相关的索引信息。可以通过添加 \G 来格式化输出信息。
尝试以下实例:
```
mysql> SHOW INDEX FROM table_name; \G
........
```
# MySQL 临时表
MySQL 临时表在我们需要保存一些临时数据时是非常有用的。临时表只在当前连接可见,当关闭连接时,Mysql会自动删除表并释放所有空间。
临时表在MySQL 3.23版本中添加,如果你的MySQL版本低于 3.23版本就无法使用MySQL的临时表。不过现在一般很少有再使用这么低版本的MySQL数据库服务了。
MySQL临时表只在当前连接可见,如果你使用PHP脚本来创建MySQL临时表,那每当PHP脚本执行完成后,该临时表也会自动销毁。
如果你使用了其他MySQL客户端程序连接MySQL数据库服务器来创建临时表,那么只有在关闭客户端程序时才会销毁临时表,当然你也可以手动销毁。
### 实例
以下展示了使用MySQL 临时表的简单实例,以下的SQL代码可以适用于PHP脚本的mysql_query()函数。
```
mysql> CREATE TEMPORARY TABLE SalesSummary (
-> product_name VARCHAR(50) NOT NULL
-> , total_sales DECIMAL(12,2) NOT NULL DEFAULT 0.00
-> , avg_unit_price DECIMAL(7,2) NOT NULL DEFAULT 0.00
-> , total_units_sold INT UNSIGNED NOT NULL DEFAULT 0
);
Query OK, 0 rows affected (0.00 sec)
mysql> INSERT INTO SalesSummary
-> (product_name, total_sales, avg_unit_price, total_units_sold)
-> VALUES
-> ('cucumber', 100.25, 90, 2);
mysql> SELECT * FROM SalesSummary;
+--------------+-------------+----------------+------------------+
| product_name | total_sales | avg_unit_price | total_units_sold |
+--------------+-------------+----------------+------------------+
| cucumber | 100.25 | 90.00 | 2 |
+--------------+-------------+----------------+------------------+
1 row in set (0.00 sec)
```
当你使用 **SHOW TABLES**命令显示数据表列表时,你将无法看到 SalesSummary表。
如果你退出当前MySQL会话,再使用 **SELECT**命令来读取原先创建的临时表数据,那你会发现数据库中没有该表的存在,因为在你退出时该临时表已经被销毁了。
------
## 删除MySQL 临时表
默认情况下,当你断开与数据库的连接后,临时表就会自动被销毁。当然你也可以在当前MySQL会话使用 **DROP TABLE** 命令来手动删除临时表。
以下是手动删除临时表的实例:
```
mysql> CREATE TEMPORARY TABLE SalesSummary (
-> product_name VARCHAR(50) NOT NULL
-> , total_sales DECIMAL(12,2) NOT NULL DEFAULT 0.00
-> , avg_unit_price DECIMAL(7,2) NOT NULL DEFAULT 0.00
-> , total_units_sold INT UNSIGNED NOT NULL DEFAULT 0
);
Query OK, 0 rows affected (0.00 sec)
mysql> INSERT INTO SalesSummary
-> (product_name, total_sales, avg_unit_price, total_units_sold)
-> VALUES
-> ('cucumber', 100.25, 90, 2);
mysql> SELECT * FROM SalesSummary;
+--------------+-------------+----------------+------------------+
| product_name | total_sales | avg_unit_price | total_units_sold |
+--------------+-------------+----------------+------------------+
| cucumber | 100.25 | 90.00 | 2 |
+--------------+-------------+----------------+------------------+
1 row in set (0.00 sec)
mysql> DROP TABLE SalesSummary;
mysql> SELECT * FROM SalesSummary;
ERROR 1146: Table 'RUNOOB.SalesSummary' doesn't exist
```
# MySQL 复制表
如果我们需要完全的复制MySQL的数据表,包括表的结构,索引,默认值等。 如果仅仅使用**CREATE TABLE ... SELECT** 命令,是无法实现的。
本章节将为大家介绍如何完整的复制MySQL数据表,步骤如下:
- 使用 **SHOW CREATE TABLE** 命令获取创建数据表(**CREATE TABLE**) 语句,该语句包含了原数据表的结构,索引等。
-
- 复制以下命令显示的SQL语句,修改数据表名,并执行SQL语句,通过以上命令 将完全的复制数据表结构。
- 如果你想复制表的内容,你就可以使用 **INSERT INTO ... SELECT** 语句来实现。
### 实例
尝试以下实例来复制表 runoob_tbl 。
**步骤一:**
获取数据表的完整结构。
```
mysql> SHOW CREATE TABLE runoob_tbl \G;
*************************** 1. row ***************************
Table: runoob_tbl
Create Table: CREATE TABLE `runoob_tbl` (
`runoob_id` int(11) NOT NULL auto_increment,
`runoob_title` varchar(100) NOT NULL default '',
`runoob_author` varchar(40) NOT NULL default '',
`submission_date` date default NULL,
PRIMARY KEY (`runoob_id`),
UNIQUE KEY `AUTHOR_INDEX` (`runoob_author`)
) ENGINE=InnoDB
1 row in set (0.00 sec)
ERROR:
No query specified
```
**步骤二:**
修改SQL语句的数据表名,并执行SQL语句。
```
mysql> CREATE TABLE `clone_tbl` (
-> `runoob_id` int(11) NOT NULL auto_increment,
-> `runoob_title` varchar(100) NOT NULL default '',
-> `runoob_author` varchar(40) NOT NULL default '',
-> `submission_date` date default NULL,
-> PRIMARY KEY (`runoob_id`),
-> UNIQUE KEY `AUTHOR_INDEX` (`runoob_author`)
-> ) ENGINE=InnoDB;
Query OK, 0 rows affected (1.80 sec)
```
**步骤三:**
执行完第二步骤后,你将在数据库中创建新的克隆表 clone_tbl。 如果你想拷贝数据表的数据你可以使用 **INSERT INTO... SELECT** 语句来实现。
```
mysql> INSERT INTO clone_tbl (runoob_id,
-> runoob_title,
-> runoob_author,
-> submission_date)
-> SELECT runoob_id,runoob_title,
-> runoob_author,submission_date
-> FROM runoob_tbl;
Query OK, 3 rows affected (0.07 sec)
Records: 3 Duplicates: 0 Warnings: 0
```
执行以上步骤后,你将完整的复制表,包括表结构及表数据。
另一种完整复制表的方法:
```
CREATE TABLE targetTable LIKE sourceTable;
INSERT INTO targetTable SELECT * FROM sourceTable;
```
其他:
可以拷贝一个表中其中的一些字段:
```
CREATE TABLE newadmin AS
(
SELECT username, password FROM admin
)
```
可以将新建的表的字段改名:
```
CREATE TABLE newadmin AS
(
SELECT id, username AS uname, password AS pass FROM admin
)
```
可以拷贝一部分数据:
```
CREATE TABLE newadmin AS
(
SELECT * FROM admin WHERE LEFT(username,1) = 's'
)
```
可以在创建表的同时定义表中的字段信息:
```
CREATE TABLE newadmin
(
id INTEGER NOT NULL AUTO_INCREMENT PRIMARY KEY
)
AS
(
SELECT * FROM admin
)
```
**来给大家区分下mysql复制表的两种方式。**
**第一、只复制表结构到新表**
create table 新表 select * from 旧表 where 1=2
或者
create table 新表 like 旧表
**第二、复制表结构及数据到新表**
create table新表 select * from 旧表
# MySQL 元数据
你可能想知道MySQL以下三种信息:
- **查询结果信息:** SELECT, UPDATE 或 DELETE语句影响的记录数。
- **数据库和数据表的信息:** 包含了数据库及数据表的结构信息。
- **MySQL服务器信息:** 包含了数据库服务器的当前状态,版本号等。
# MySQL 序列使用
MySQL 序列是一组整数:1, 2, 3, ...,由于一张数据表只能有一个字段自增主键, 如果你想实现其他字段也实现自动增加,就可以使用MySQL序列来实现。
本章我们将介绍如何使用MySQL的序列。
------
## 使用 AUTO_INCREMENT
MySQL 中最简单使用序列的方法就是使用 MySQL AUTO_INCREMENT 来定义列。
### 实例
以下实例中创建了数据表 insect, insect 表中 id 无需指定值可实现自动增长。
```
mysql> CREATE TABLE insect
-> (
-> id INT UNSIGNED NOT NULL AUTO_INCREMENT,
-> PRIMARY KEY (id),
-> name VARCHAR(30) NOT NULL, # type of insect
-> date DATE NOT NULL, # date collected
-> origin VARCHAR(30) NOT NULL # where collected
);
Query OK, 0 rows affected (0.02 sec)
mysql> INSERT INTO insect (id,name,date,origin) VALUES
-> (NULL,'housefly','2001-09-10','kitchen'),
-> (NULL,'millipede','2001-09-10','driveway'),
-> (NULL,'grasshopper','2001-09-10','front yard');
Query OK, 3 rows affected (0.02 sec)
Records: 3 Duplicates: 0 Warnings: 0
mysql> SELECT * FROM insect ORDER BY id;
+----+-------------+------------+------------+
| id | name | date | origin |
+----+-------------+------------+------------+
| 1 | housefly | 2001-09-10 | kitchen |
| 2 | millipede | 2001-09-10 | driveway |
| 3 | grasshopper | 2001-09-10 | front yard |
+----+-------------+------------+------------+
3 rows in set (0.00 sec)
```
------
## 获取AUTO_INCREMENT值
在MySQL的客户端中你可以使用 SQL中的LAST_INSERT_ID( ) 函数来获取最后的插入表中的自增列的值。
在PHP或PERL脚本中也提供了相应的函数来获取最后的插入表中的自增列的值。
### PERL实例
使用 mysql_insertid 属性来获取 AUTO_INCREMENT 的值。 实例如下:
```
$dbh->do ("INSERT INTO insect (name,date,origin)
VALUES('moth','2001-09-14','windowsill')");
my $seq = $dbh->{mysql_insertid};
```
### PHP实例
PHP 通过 mysql_insert_id ()函数来获取执行的插入SQL语句中 AUTO_INCREMENT列的值。
```
mysql_query ("INSERT INTO insect (name,date,origin)
VALUES('moth','2001-09-14','windowsill')", $conn_id);
$seq = mysql_insert_id ($conn_id);
```
------
## 重置序列
如果你删除了数据表中的多条记录,并希望对剩下数据的AUTO_INCREMENT列进行重新排列,那么你可以通过删除自增的列,然后重新添加来实现。 不过该操作要非常小心,如果在删除的同时又有新记录添加,有可能会出现数据混乱。操作如下所示:
```
mysql> ALTER TABLE insect DROP id;
mysql> ALTER TABLE insect
-> ADD id INT UNSIGNED NOT NULL AUTO_INCREMENT FIRST,
-> ADD PRIMARY KEY (id);
```
------
## 设置序列的开始值
一般情况下序列的开始值为1,但如果你需要指定一个开始值100,那我们可以通过以下语句来实现:
```
mysql> CREATE TABLE insect
-> (
-> id INT UNSIGNED NOT NULL AUTO_INCREMENT,
-> PRIMARY KEY (id),
-> name VARCHAR(30) NOT NULL,
-> date DATE NOT NULL,
-> origin VARCHAR(30) NOT NULL
)engine=innodb auto_increment=100 charset=utf8;
```
或者你也可以在表创建成功后,通过以下语句来实现:
```
mysql> ALTER TABLE t AUTO_INCREMENT = 100;
```
使用函数创建自增序列管理表(批量使用自增表,设置初始值,自增幅度)
第一步:创建Sequence管理表 sequence
```
DROP TABLE IF EXISTS sequence;
CREATE TABLE sequence (
name VARCHAR(50) NOT NULL,
current_value INT NOT NULL,
increment INT NOT NULL DEFAULT 1,
PRIMARY KEY (name)
) ENGINE=InnoDB;
```
第二步:创建取当前值的函数 currval
```
DROP FUNCTION IF EXISTS currval;
DELIMITER $
CREATE FUNCTION currval (seq_name VARCHAR(50))
RETURNS INTEGER
LANGUAGE SQL
DETERMINISTIC
CONTAINS SQL
SQL SECURITY DEFINER
COMMENT ''
BEGIN
DECLARE value INTEGER;
SET value = 0;
SELECT current_value INTO value
FROM sequence
WHERE name = seq_name;
RETURN value;
END
$
DELIMITER ;
```
第三步:创建取下一个值的函数 nextval
```
DROP FUNCTION IF EXISTS nextval;
DELIMITER $
CREATE FUNCTION nextval (seq_name VARCHAR(50))
RETURNS INTEGER
LANGUAGE SQL
DETERMINISTIC
CONTAINS SQL
SQL SECURITY DEFINER
COMMENT ''
BEGIN
UPDATE sequence
SET current_value = current_value + increment
WHERE name = seq_name;
RETURN currval(seq_name);
END
$
DELIMITER;
```
第四步:创建更新当前值的函数 setval
```
DROP FUNCTION IF EXISTS setval;
DELIMITER $
CREATE FUNCTION setval (seq_name VARCHAR(50), value INTEGER)
RETURNS INTEGER
LANGUAGE SQL
DETERMINISTIC
CONTAINS SQL
SQL SECURITY DEFINER
COMMENT ''
BEGIN
UPDATE sequence
SET current_value = value
WHERE name = seq_name;
RETURN currval(seq_name);
END
$
DELIMITER ;
```
**测试函数功能**
当上述四步完成后,可以用以下数据设置需要创建的sequence名称以及设置初始值和获取当前值和下一个值。
```
INSERT INTO sequence VALUES ('TestSeq', 0, 1);
----添加一个sequence名称和初始值,以及自增幅度 添加一个名为TestSeq 的自增序列
SELECT SETVAL('TestSeq', 10);
---设置指定sequence的初始值 这里设置TestSeq 的初始值为10
SELECT CURRVAL('TestSeq');
--查询指定sequence的当前值 这里是获取TestSeq当前值
SELECT NEXTVAL('TestSeq');
--查询指定sequence的下一个值 这里是获取TestSeq下一个值
```
# MySQL 处理重复数据
有些 MySQL 数据表中可能存在重复的记录,有些情况我们允许重复数据的存在,但有时候我们也需要删除这些重复的数据。
本章节我们将为大家介绍如何防止数据表出现重复数据及如何删除数据表中的重复数据。
------
## 防止表中出现重复数据
你可以在 MySQL 数据表中设置指定的字段为 **PRIMARY KEY(主键)** **UNIQUE(唯一)**
让我们尝试一个实例:下表中无索引及主键,所以该表允许出现多条重复记录。
```
CREATE TABLE person_tbl
(
first_name CHAR(20),
last_name CHAR(20),
sex CHAR(10)
);
```
如果你想设置表中字段 first_name,last_name 数据不能重复,你可以设置双主键模式来设置数据的唯一性, 如果你设置了双主键,那么那个键的默认值不能为 NULL,可设置为 NOT NULL。如下所示:
```
CREATE TABLE person_tbl
(
first_name CHAR(20) NOT NULL,
last_name CHAR(20) NOT NULL,
sex CHAR(10),
PRIMARY KEY (last_name, first_name)
);
```
如果我们设置了唯一索引,那么在插入重复数据时,SQL 语句将无法执行成功,并抛出错。
INSERT IGNORE INTO 与 INSERT INTO 的区别就是 INSERT IGNORE 会忽略数据库中已经存在的数据,如果数据库没有数据,就插入新的数据,如果有数据的话就跳过这条数据。这样就可以保留数据库中已经存在数据,达到在间隙中插入数据的目的。
以下实例使用了 INSERT IGNORE INTO,执行后不会出错,也不会向数据表中插入重复数据:
```
mysql> INSERT IGNORE INTO person_tbl (last_name, first_name)
-> VALUES( 'Jay', 'Thomas');
Query OK, 1 row affected (0.00 sec)
mysql> INSERT IGNORE INTO person_tbl (last_name, first_name)
-> VALUES( 'Jay', 'Thomas');
Query OK, 0 rows affected (0.00 sec)
```
INSERT IGNORE INTO 当插入数据时,在设置了记录的唯一性后,如果插入重复数据,将不返回错误,只以警告形式返回。 而 REPLACE INTO 如果存在 primary 或 unique 相同的记录,则先删除掉。再插入新记录。
另一种设置数据的唯一性方法是添加一个 UNIQUE 索引,如下所示:
```
CREATE TABLE person_tbl
(
first_name CHAR(20) NOT NULL,
last_name CHAR(20) NOT NULL,
sex CHAR(10),
UNIQUE (last_name, first_name)
);
```
------
## 统计重复数据
以下我们将统计表中 first_name 和 last_name的重复记录数:
```
mysql> SELECT COUNT(*) as repetitions, last_name, first_name
-> FROM person_tbl
-> GROUP BY last_name, first_name
-> HAVING repetitions > 1;
```
以上查询语句将返回 person_tbl 表中重复的记录数。 一般情况下,查询重复的值,请执行以下操作:
- 确定哪一列包含的值可能会重复。
- 在列选择列表使用COUNT(*)列出的那些列。
- 在GROUP BY子句中列出的列。
- HAVING子句设置重复数大于1。
------
## 过滤重复数据
如果你需要读取不重复的数据可以在 SELECT 语句中使用 DISTINCT 关键字来过滤重复数据。
```
mysql> SELECT DISTINCT last_name, first_name
-> FROM person_tbl;
```
你也可以使用 GROUP BY 来读取数据表中不重复的数据:
```
mysql> SELECT last_name, first_name
-> FROM person_tbl
-> GROUP BY (last_name, first_name);
```
------
## 删除重复数据
如果你想删除数据表中的重复数据,你可以使用以下的SQL语句:
```
mysql> CREATE TABLE tmp SELECT last_name, first_name, sex FROM person_tbl GROUP BY (last_name, first_name, sex);
mysql> DROP TABLE person_tbl;
mysql> ALTER TABLE tmp RENAME TO person_tbl;
```
当然你也可以在数据表中添加 INDEX(索引) 和 PRIMAY KEY(主键)这种简单的方法来删除表中的重复记录。方法如下:
```
mysql> ALTER IGNORE TABLE person_tbl
-> ADD PRIMARY KEY (last_name, first_name);
```
```
select 列名1,count(1) as count
from 表名
group by 列名1
having count>1 and 其他条件
select 列名1,列名2,count(1) as count
from 表名
group by 列名1,列名2
having count>1 and 其他条件
```
原理:先按照要查询出现重复数据的列,进行分组查询。count > 1 代表出现 2 次或 2 次以上。
示例:
```
/*查询重复数据*/
select serialnum,cdate,count(*) as count
from m_8_customer_temp_20180820bak
group by serialnum,cdate having count>1 and cdate>='2018-08-20 00:00:00';
```
# MySQL 及 SQL 注入
如果您通过网页获取用户输入的数据并将其插入一个MySQL数据库,那么就有可能发生SQL注入安全的问题。
本章节将为大家介绍如何防止SQL注入,并通过脚本来过滤SQL中注入的字符。
所谓SQL注入,就是通过把SQL命令插入到Web表单递交或输入域名或页面请求的查询字符串,最终达到欺骗服务器执行恶意的SQL命令。
我们永远不要信任用户的输入,我们必须认定用户输入的数据都是不安全的,我们都需要对用户输入的数据进行过滤处理。
以下实例中,输入的用户名必须为字母、数字及下划线的组合,且用户名长度为 8 到 20 个字符之间:
```
if (preg_match("/^\w{8,20}$/", $_GET['username'], $matches))
{
$result = mysqli_query($conn, "SELECT * FROM users
WHERE username=$matches[0]");
}
else
{
echo "username 输入异常";
}
```
让我们看下在没有过滤特殊字符时,出现的SQL情况:
```
// 设定$name 中插入了我们不需要的SQL语句
$name = "Qadir'; DELETE FROM users;";
mysqli_query($conn, "SELECT * FROM users WHERE name='{$name}'");
```
以上的注入语句中,我们没有对 $name 的变量进行过滤,$name 中插入了我们不需要的SQL语句,将删除 users 表中的所有数据。
在PHP中的 mysqli_query() 是不允许执行多个 SQL 语句的,但是在 SQLite 和 PostgreSQL 是可以同时执行多条SQL语句的,所以我们对这些用户的数据需要进行严格的验证。
防止SQL注入,我们需要注意以下几个要点:
- 1.永远不要信任用户的输入。对用户的输入进行校验,可以通过正则表达式,或限制长度;对单引号和 双"-"进行转换等。
- 2.永远不要使用动态拼装sql,可以使用参数化的sql或者直接使用存储过程进行数据查询存取。
- 3.永远不要使用管理员权限的数据库连接,为每个应用使用单独的权限有限的数据库连接。
- 4.不要把机密信息直接存放,加密或者hash掉密码和敏感的信息。
- 5.应用的异常信息应该给出尽可能少的提示,最好使用自定义的错误信息对原始错误信息进行包装
- 6.sql注入的检测方法一般采取辅助软件或网站平台来检测,软件一般采用sql注入检测工具jsky,网站平台就有亿思网站安全平台检测工具。MDCSOFT SCAN等。采用MDCSOFT-IPS可以有效的防御SQL注入,XSS攻击等。
------
## 防止SQL注入
在脚本语言,如Perl和PHP你可以对用户输入的数据进行转义从而来防止SQL注入。
PHP的MySQL扩展提供了mysqli_real_escape_string()函数来转义特殊的输入字符。
```
if (get_magic_quotes_gpc())
{
$name = stripslashes($name);
}
$name = mysqli_real_escape_string($conn, $name);
mysqli_query($conn, "SELECT * FROM users WHERE name='{$name}'");
```
------
## Like语句中的注入
like查询时,如果用户输入的值有"_"和"%",则会出现这种情况:用户本来只是想查询"abcd_",查询结果中却有"abcd_"、"abcde"、"abcdf"等等;用户要查询"30%"(注:百分之三十)时也会出现问题。
在PHP脚本中我们可以使用addcslashes()函数来处理以上情况,如下实例:
```
$sub = addcslashes(mysqli_real_escape_string($conn, "%something_"), "%_");
// $sub == \%something\_
mysqli_query($conn, "SELECT * FROM messages WHERE subject LIKE '{$sub}%'");
```
addcslashes() 函数在指定的字符前添加反斜杠。
语法格式:
```
addcslashes(string,characters)
```
| 参数 | 描述 |
| :--------- | :------------------------------------------------ |
| string | 必需。规定要检查的字符串。 |
| characters | 可选。规定受 addcslashes() 影响的字符或字符范围。 |
# MySQL 导出数据
MySQL中你可以使用**SELECT...INTO OUTFILE**语句来简单的导出数据到文本文件上。
------
## 使用 SELECT ... INTO OUTFILE 语句导出数据
以下实例中我们将数据表 runoob_tbl 数据导出到 /tmp/runoob.txt 文件中:
```
mysql> SELECT * FROM runoob_tbl
-> INTO OUTFILE '/tmp/runoob.txt';
```
你可以通过命令选项来设置数据输出的指定格式,以下实例为导出 CSV 格式:
```
mysql> SELECT * FROM passwd INTO OUTFILE '/tmp/runoob.txt'
-> FIELDS TERMINATED BY ',' ENCLOSED BY '"'
-> LINES TERMINATED BY '\r\n';
```
在下面的例子中,生成一个文件,各值用逗号隔开。这种格式可以被许多程序使用。
```
SELECT a,b,a+b INTO OUTFILE '/tmp/result.text'
FIELDS TERMINATED BY ',' OPTIONALLY ENCLOSED BY '"'
LINES TERMINATED BY '\n'
FROM test_table;
```
### SELECT ... INTO OUTFILE 语句有以下属性:
- LOAD DATA INFILE是SELECT ... INTO OUTFILE的逆操作,SELECT句法。为了将一个数据库的数据写入一个文件,使用SELECT ... INTO OUTFILE,为了将文件读回数据库,使用LOAD DATA INFILE。
- SELECT...INTO OUTFILE 'file_name'形式的SELECT可以把被选择的行写入一个文件中。该文件被创建到服务器主机上,因此您必须拥有FILE权限,才能使用此语法。
- 输出不能是一个已存在的文件。防止文件数据被篡改。
- 你需要有一个登陆服务器的账号来检索文件。否则 SELECT ... INTO OUTFILE 不会起任何作用。
- 在UNIX中,该文件被创建后是可读的,权限由MySQL服务器所拥有。这意味着,虽然你就可以读取该文件,但可能无法将其删除。
------
## 导出表作为原始数据
**mysqldump** 是 mysql 用于转存储数据库的实用程序。它主要产生一个 SQL 脚本,其中包含从头重新创建数据库所必需的命令 CREATE TABLE INSERT 等。
使用 **mysqldump** 导出数据需要使用 **--tab** 选项来指定导出文件指定的目录,该目标必须是可写的。
以下实例将数据表 runoob_tbl 导出到 /tmp 目录中:
```
$ mysqldump -u root -p --no-create-info \
--tab=/tmp RUNOOB runoob_tbl
password ******
```
------
## 导出 SQL 格式的数据
导出 SQL 格式的数据到指定文件,如下所示:
```
$ mysqldump -u root -p RUNOOB runoob_tbl > dump.txt
password ******
```
以上命令创建的文件内容如下:
```
-- MySQL dump 8.23
--
-- Host: localhost Database: RUNOOB
---------------------------------------------------------
-- Server version 3.23.58
--
-- Table structure for table `runoob_tbl`
--
CREATE TABLE runoob_tbl (
runoob_id int(11) NOT NULL auto_increment,
runoob_title varchar(100) NOT NULL default '',
runoob_author varchar(40) NOT NULL default '',
submission_date date default NULL,
PRIMARY KEY (runoob_id),
UNIQUE KEY AUTHOR_INDEX (runoob_author)
) TYPE=MyISAM;
--
-- Dumping data for table `runoob_tbl`
--
INSERT INTO runoob_tbl
VALUES (1,'Learn PHP','John Poul','2007-05-24');
INSERT INTO runoob_tbl
VALUES (2,'Learn MySQL','Abdul S','2007-05-24');
INSERT INTO runoob_tbl
VALUES (3,'JAVA Tutorial','Sanjay','2007-05-06');
```
如果你需要导出整个数据库的数据,可以使用以下命令:
```
$ mysqldump -u root -p RUNOOB > database_dump.txt
password ******
```
如果需要备份所有数据库,可以使用以下命令:
```
$ mysqldump -u root -p --all-databases > database_dump.txt
password ******
```
--all-databases 选项在 MySQL 3.23.12 及以后版本加入。
该方法可用于实现数据库的备份策略。
------
## 将数据表及数据库拷贝至其他主机
如果你需要将数据拷贝至其他的 MySQL 服务器上, 你可以在 mysqldump 命令中指定数据库名及数据表。
在源主机上执行以下命令,将数据备份至 dump.txt 文件中:
```
$ mysqldump -u root -p database_name table_name > dump.txt
password *****
```
如果完整备份数据库,则无需使用特定的表名称。
如果你需要将备份的数据库导入到MySQL服务器中,可以使用以下命令,使用以下命令你需要确认数据库已经创建:
```
$ mysql -u root -p database_name < dump.txt
password *****
```
你也可以使用以下命令将导出的数据直接导入到远程的服务器上,但请确保两台服务器是相通的,是可以相互访问的:
```
$ mysqldump -u root -p database_name \
| mysql -h other-host.com database_name
```
以上命令中使用了管道来将导出的数据导入到指定的远程主机上。
**将指定主机的数据库拷贝到本地**
如果你需要将远程服务器的数据拷贝到本地,你也可以在 mysqldump 命令中指定远程服务器的IP、端口及数据库名。
在源主机上执行以下命令,将数据备份到 dump.txt 文件中:
请确保两台服务器是相通的:
```
mysqldump -h other-host.com -P port -u root -p database_name > dump.txt
password ****
```
在写出的时候会出现The MySQL server is running with the --secure-file-priv option so it cannot execute this statement的错误解决方法:
出现这个错误是因为没有给数据库指定写出文件的路径或者写出的路径有问题。
首先使用下面的命令 **show variables like '%secure%';** 查看数据库的存储路径。如果查出的 secure_file_priv 是 null 的时候就证明在 my.ini 文件里面没有配置写出路径。
这时候就可以在 mysql.ini 文件的 [mysqld] 代码下增加 secure_file_priv=E:/TEST 再重启 mysql 就可以了。然后在导出的地址下面写上刚才配置的这个地址 eg: **select \* from tb_test into outfile "E:/TEST/test.txt";**就可以了。
# MySQL 导入数据
本章节我们为大家介绍几种简单的 MySQL 导入数据命令。
------
## 1、mysql 命令导入
使用 mysql 命令导入语法格式为:
```
mysql -u用户名 -p密码 < 要导入的数据库数据(runoob.sql)
```
**实例:**
```
# mysql -uroot -p123456 < runoob.sql
```
以上命令将将备份的整个数据库 runoob.sql 导入。
------
## 2、source 命令导入
source 命令导入数据库需要先登录到数库终端:
```
mysql> create database abc; # 创建数据库
mysql> use abc; # 使用已创建的数据库
mysql> set names utf8; # 设置编码
mysql> source /home/abc/abc.sql # 导入备份数据库
```
------
## 3、使用 LOAD DATA 导入数据
MySQL 中提供了LOAD DATA INFILE语句来插入数据。 以下实例中将从当前目录中读取文件 dump.txt ,将该文件中的数据插入到当前数据库的 mytbl 表中。
```
mysql> LOAD DATA LOCAL INFILE 'dump.txt' INTO TABLE mytbl;
```
如果指定LOCAL关键词,则表明从客户主机上按路径读取文件。如果没有指定,则文件在服务器上按路径读取文件。
你能明确地在LOAD DATA语句中指出列值的分隔符和行尾标记,但是默认标记是定位符和换行符。
两个命令的 FIELDS 和 LINES 子句的语法是一样的。两个子句都是可选的,但是如果两个同时被指定,FIELDS 子句必须出现在 LINES 子句之前。
如果用户指定一个 FIELDS 子句,它的子句 (TERMINATED BY、[OPTIONALLY] ENCLOSED BY 和 ESCAPED BY) 也是可选的,不过,用户必须至少指定它们中的一个。
```
mysql> LOAD DATA LOCAL INFILE 'dump.txt' INTO TABLE mytbl
-> FIELDS TERMINATED BY ':'
-> LINES TERMINATED BY '\r\n';
```
LOAD DATA 默认情况下是按照数据文件中列的顺序插入数据的,如果数据文件中的列与插入表中的列不一致,则需要指定列的顺序。
如,在数据文件中的列顺序是 a,b,c,但在插入表的列顺序为b,c,a,则数据导入语法如下:
```
mysql> LOAD DATA LOCAL INFILE 'dump.txt'
-> INTO TABLE mytbl (b, c, a);
```
------
## 4、使用 mysqlimport 导入数据
mysqlimport 客户端提供了 LOAD DATA INFILEQL 语句的一个命令行接口。mysqlimport 的大多数选项直接对应 LOAD DATA INFILE 子句。
从文件 dump.txt 中将数据导入到 mytbl 数据表中, 可以使用以下命令:
```
$ mysqlimport -u root -p --local mytbl dump.txt
password *****
```
mysqlimport 命令可以指定选项来设置指定格式,命令语句格式如下:
```
$ mysqlimport -u root -p --local --fields-terminated-by=":" \
--lines-terminated-by="\r\n" mytbl dump.txt
password *****
```
mysqlimport 语句中使用 --columns 选项来设置列的顺序:
```
$ mysqlimport -u root -p --local --columns=b,c,a \
mytbl dump.txt
password *****
```
------
## mysqlimport的常用选项介绍
| 选项 | 功能 |
| :--------------------------- | :----------------------------------------------------------- |
| -d or --delete | 新数据导入数据表中之前删除数据数据表中的所有信息 |
| -f or --force | 不管是否遇到错误,mysqlimport将强制继续插入数据 |
| -i or --ignore | mysqlimport跳过或者忽略那些有相同唯一 关键字的行, 导入文件中的数据将被忽略。 |
| -l or -lock-tables | 数据被插入之前锁住表,这样就防止了, 你在更新数据库时,用户的查询和更新受到影响。 |
| -r or -replace | 这个选项与-i选项的作用相反;此选项将替代 表中有相同唯一关键字的记录。 |
| --fields-enclosed- by= char | 指定文本文件中数据的记录时以什么括起的, 很多情况下 数据以双引号括起。 默认的情况下数据是没有被字符括起的。 |
| --fields-terminated- by=char | 指定各个数据的值之间的分隔符,在句号分隔的文件中, 分隔符是句号。您可以用此选项指定数据之间的分隔符。 默认的分隔符是跳格符(Tab) |
| --lines-terminated- by=str | 此选项指定文本文件中行与行之间数据的分隔字符串 或者字符。 默认的情况下mysqlimport以newline为行分隔符。 您可以选择用一个字符串来替代一个单个的字符: 一个新行或者一个回车。 |
mysqlimport 命令常用的选项还有 -v 显示版本(version), -p 提示输入密码(password)等。
# MySQL 函数
MySQL 有很多内置的函数,以下列出了这些函数的说明。
------
## MySQL 字符串函数
| 函数 | 描述 | 实例 |
| :------------------------------------ | :----------------------------------------------------------- | :----------------------------------------------------------- |
| ASCII(s) | 返回字符串 s 的第一个字符的 ASCII 码。 | 返回 CustomerName 字段第一个字母的 ASCII 码:`SELECT ASCII(CustomerName) AS NumCodeOfFirstChar FROM Customers;` |
| CHAR_LENGTH(s) | 返回字符串 s 的字符数 | 返回字符串 RUNOOB 的字符数`SELECT CHAR_LENGTH("RUNOOB") AS LengthOfString;` |
| CHARACTER_LENGTH(s) | 返回字符串 s 的字符数 | 返回字符串 RUNOOB 的字符数`SELECT CHARACTER_LENGTH("RUNOOB") AS LengthOfString;` |
| CONCAT(s1,s2...sn) | 字符串 s1,s2 等多个字符串合并为一个字符串 | 合并多个字符串`SELECT CONCAT("SQL ", "Runoob ", "Gooogle ", "Facebook") AS ConcatenatedString;` |
| CONCAT_WS(x, s1,s2...sn) | 同 CONCAT(s1,s2,...) 函数,但是每个字符串之间要加上 x,x 可以是分隔符 | 合并多个字符串,并添加分隔符:`SELECT CONCAT_WS("-", "SQL", "Tutorial", "is", "fun!")AS ConcatenatedString;` |
| FIELD(s,s1,s2...) | 返回第一个字符串 s 在字符串列表(s1,s2...)中的位置 | 返回字符串 c 在列表值中的位置:`SELECT FIELD("c", "a", "b", "c", "d", "e");` |
| FIND_IN_SET(s1,s2) | 返回在字符串s2中与s1匹配的字符串的位置 | 返回字符串 c 在指定字符串中的位置:`SELECT FIND_IN_SET("c", "a,b,c,d,e");` |
| FORMAT(x,n) | 函数可以将数字 x 进行格式化 "#,###.##", 将 x 保留到小数点后 n 位,最后一位四舍五入。 | 格式化数字 "#,###.##" 形式:`SELECT FORMAT(250500.5634, 2); -- 输出 250,500.56` |
| INSERT(s1,x,len,s2) | 字符串 s2 替换 s1 的 x 位置开始长度为 len 的字符串 | 从字符串第一个位置开始的 6 个字符替换为 runoob:`SELECT INSERT("google.com", 1, 6, "runnob"); -- 输出:runoob.com` |
| LOCATE(s1,s) | 从字符串 s 中获取 s1 的开始位置 | 获取 b 在字符串 abc 中的位置:`SELECT LOCATE('st','myteststring'); -- 5`返回字符串 abc 中 b 的位置:`SELECT LOCATE('b', 'abc') -- 2` |
| LCASE(s) | 将字符串 s 的所有字母变成小写字母 | 字符串 RUNOOB 转换为小写:`SELECT LCASE('RUNOOB') -- runoob` |
| LEFT(s,n) | 返回字符串 s 的前 n 个字符 | 返回字符串 runoob 中的前两个字符:`SELECT LEFT('runoob',2) -- ru` |
| LOWER(s) | 将字符串 s 的所有字母变成小写字母 | 字符串 RUNOOB 转换为小写:`SELECT LOWER('RUNOOB') -- runoob` |
| LPAD(s1,len,s2) | 在字符串 s1 的开始处填充字符串 s2,使字符串长度达到 len | 将字符串 xx 填充到 abc 字符串的开始处:`SELECT LPAD('abc',5,'xx') -- xxabc` |
| LTRIM(s) | 去掉字符串 s 开始处的空格 | 去掉字符串 RUNOOB开始处的空格:`SELECT LTRIM(" RUNOOB") AS LeftTrimmedString;-- RUNOOB` |
| MID(s,n,len) | 从字符串 s 的 n 位置截取长度为 len 的子字符串,同 SUBSTRING(s,n,len) | 从字符串 RUNOOB 中的第 2 个位置截取 3个 字符:`SELECT MID("RUNOOB", 2, 3) AS ExtractString; -- UNO` |
| POSITION(s1 IN s) | 从字符串 s 中获取 s1 的开始位置 | 返回字符串 abc 中 b 的位置:`SELECT POSITION('b' in 'abc') -- 2` |
| REPEAT(s,n) | 将字符串 s 重复 n 次 | 将字符串 runoob 重复三次:`SELECT REPEAT('runoob',3) -- runoobrunoobrunoob` |
| REPLACE(s,s1,s2) | 将字符串 s2 替代字符串 s 中的字符串 s1 | 将字符串 abc 中的字符 a 替换为字符 x:`SELECT REPLACE('abc','a','x') --xbc` |
| REVERSE(s) | 将字符串s的顺序反过来 | 将字符串 abc 的顺序反过来:`SELECT REVERSE('abc') -- cba` |
| RIGHT(s,n) | 返回字符串 s 的后 n 个字符 | 返回字符串 runoob 的后两个字符:`SELECT RIGHT('runoob',2) -- ob` |
| RPAD(s1,len,s2) | 在字符串 s1 的结尾处添加字符串 s2,使字符串的长度达到 len | 将字符串 xx 填充到 abc 字符串的结尾处:`SELECT RPAD('abc',5,'xx') -- abcxx` |
| RTRIM(s) | 去掉字符串 s 结尾处的空格 | 去掉字符串 RUNOOB 的末尾空格:`SELECT RTRIM("RUNOOB ") AS RightTrimmedString; -- RUNOOB` |
| SPACE(n) | 返回 n 个空格 | 返回 10 个空格:`SELECT SPACE(10);` |
| STRCMP(s1,s2) | 比较字符串 s1 和 s2,如果 s1 与 s2 相等返回 0 ,如果 s1>s2 返回 1,如果 s12017-06-25` |
| ADDTIME(t,n) | 时间 t 加上 n 秒的时间 | `SELECT ADDTIME('2011-11-11 11:11:11', 5) ->2011-11-11 11:11:16 (秒)` |
| CURDATE() | 返回当前日期 | `SELECT CURDATE(); -> 2018-09-19` |
| CURRENT_DATE() | 返回当前日期 | `SELECT CURRENT_DATE(); -> 2018-09-19` |
| CURRENT_TIME | 返回当前时间 | `SELECT CURRENT_TIME(); -> 19:59:02` |
| CURRENT_TIMESTAMP() | 返回当前日期和时间 | `SELECT CURRENT_TIMESTAMP() -> 2018-09-19 20:57:43` |
| CURTIME() | 返回当前时间 | `SELECT CURTIME(); -> 19:59:02` |
| DATE() | 从日期或日期时间表达式中提取日期值 | `SELECT DATE("2017-06-15"); -> 2017-06-15` |
| DATEDIFF(d1,d2) | 计算日期 d1->d2 之间相隔的天数 | `SELECT DATEDIFF('2001-01-01','2001-02-02') -> -32` |
| DATE_ADD(d,INTERVAL expr type) | 计算起始日期 d 加上一个时间段后的日期 | `SELECT ADDDATE('2011-11-11 11:11:11',1) -> 2011-11-12 11:11:11 (默认是天) SELECT ADDDATE('2011-11-11 11:11:11', INTERVAL 5 MINUTE) -> 2011-11-11 11:16:11 (TYPE的取值与上面那个列出来的函数类似)` |
| DATE_FORMAT(d,f) | 按表达式 f的要求显示日期 d | `SELECT DATE_FORMAT('2011-11-11 11:11:11','%Y-%m-%d %r') -> 2011-11-11 11:11:11 AM` |
| DATE_SUB(date,INTERVAL expr type) | 函数从日期减去指定的时间间隔。 | Orders 表中 OrderDate 字段减去 2 天:`SELECT OrderId,DATE_SUB(OrderDate,INTERVAL 2 DAY) AS OrderPayDate FROM Orders` |
| DAY(d) | 返回日期值 d 的日期部分 | `SELECT DAY("2017-06-15"); -> 15` |
| DAYNAME(d) | 返回日期 d 是星期几,如 Monday,Tuesday | `SELECT DAYNAME('2011-11-11 11:11:11') ->Friday` |
| DAYOFMONTH(d) | 计算日期 d 是本月的第几天 | `SELECT DAYOFMONTH('2011-11-11 11:11:11') ->11` |
| DAYOFWEEK(d) | 日期 d 今天是星期几,1 星期日,2 星期一,以此类推 | `SELECT DAYOFWEEK('2011-11-11 11:11:11') ->6` |
| DAYOFYEAR(d) | 计算日期 d 是本年的第几天 | `SELECT DAYOFYEAR('2011-11-11 11:11:11') ->315` |
| EXTRACT(type FROM d) | 从日期 d 中获取指定的值,type 指定返回的值。 type可取值为: MICROSECONDSECONDMINUTEHOURDAYWEEKMONTHQUARTERYEARSECOND_MICROSECONDMINUTE_MICROSECONDMINUTE_SECONDHOUR_MICROSECONDHOUR_SECONDHOUR_MINUTEDAY_MICROSECONDDAY_SECONDDAY_MINUTEDAY_HOURYEAR_MONTH | `SELECT EXTRACT(MINUTE FROM '2011-11-11 11:11:11') -> 11` |
| FROM_DAYS(n) | 计算从 0000 年 1 月 1 日开始 n 天后的日期 | `SELECT FROM_DAYS(1111) -> 0003-01-16` |
| HOUR(t) | 返回 t 中的小时值 | `SELECT HOUR('1:2:3') -> 1` |
| LAST_DAY(d) | 返回给给定日期的那一月份的最后一天 | `SELECT LAST_DAY("2017-06-20"); -> 2017-06-30` |
| LOCALTIME() | 返回当前日期和时间 | `SELECT LOCALTIME() -> 2018-09-19 20:57:43` |
| LOCALTIMESTAMP() | 返回当前日期和时间 | `SELECT LOCALTIMESTAMP() -> 2018-09-19 20:57:43` |
| MAKEDATE(year, day-of-year) | 基于给定参数年份 year 和所在年中的天数序号 day-of-year 返回一个日期 | `SELECT MAKEDATE(2017, 3); -> 2017-01-03` |
| MAKETIME(hour, minute, second) | 组合时间,参数分别为小时、分钟、秒 | `SELECT MAKETIME(11, 35, 4); -> 11:35:04` |
| MICROSECOND(date) | 返回日期参数所对应的微秒数 | `SELECT MICROSECOND("2017-06-20 09:34:00.000023"); -> 23` |
| MINUTE(t) | 返回 t 中的分钟值 | `SELECT MINUTE('1:2:3') -> 2` |
| MONTHNAME(d) | 返回日期当中的月份名称,如 November | `SELECT MONTHNAME('2011-11-11 11:11:11') -> November` |
| MONTH(d) | 返回日期d中的月份值,1 到 12 | `SELECT MONTH('2011-11-11 11:11:11') ->11` |
| NOW() | 返回当前日期和时间 | `SELECT NOW() -> 2018-09-19 20:57:43` |
| PERIOD_ADD(period, number) | 为 年-月 组合日期添加一个时段 | `SELECT PERIOD_ADD(201703, 5); -> 201708` |
| PERIOD_DIFF(period1, period2) | 返回两个时段之间的月份差值 | `SELECT PERIOD_DIFF(201710, 201703); -> 7` |
| QUARTER(d) | 返回日期d是第几季节,返回 1 到 4 | `SELECT QUARTER('2011-11-11 11:11:11') -> 4` |
| SECOND(t) | 返回 t 中的秒钟值 | `SELECT SECOND('1:2:3') -> 3` |
| SEC_TO_TIME(s) | 将以秒为单位的时间 s 转换为时分秒的格式 | `SELECT SEC_TO_TIME(4320) -> 01:12:00` |
| STR_TO_DATE(string, format_mask) | 将字符串转变为日期 | `SELECT STR_TO_DATE("August 10 2017", "%M %d %Y"); -> 2017-08-10` |
| SUBDATE(d,n) | 日期 d 减去 n 天后的日期 | `SELECT SUBDATE('2011-11-11 11:11:11', 1) ->2011-11-10 11:11:11 (默认是天)` |
| SUBTIME(t,n) | 时间 t 减去 n 秒的时间 | `SELECT SUBTIME('2011-11-11 11:11:11', 5) ->2011-11-11 11:11:06 (秒)` |
| SYSDATE() | 返回当前日期和时间 | `SELECT SYSDATE() -> 2018-09-19 20:57:43` |
| TIME(expression) | 提取传入表达式的时间部分 | `SELECT TIME("19:30:10"); -> 19:30:10` |
| TIME_FORMAT(t,f) | 按表达式 f 的要求显示时间 t | `SELECT TIME_FORMAT('11:11:11','%r') 11:11:11 AM` |
| TIME_TO_SEC(t) | 将时间 t 转换为秒 | `SELECT TIME_TO_SEC('1:12:00') -> 4320` |
| TIMEDIFF(time1, time2) | 计算时间差值 | `SELECT TIMEDIFF("13:10:11", "13:10:10"); -> 00:00:01` |
| TIMESTAMP(expression, interval) | 单个参数时,函数返回日期或日期时间表达式;有2个参数时,将参数加和 | `SELECT TIMESTAMP("2017-07-23", "13:10:11"); -> 2017-07-23 13:10:11` |
| TO_DAYS(d) | 计算日期 d 距离 0000 年 1 月 1 日的天数 | `SELECT TO_DAYS('0001-01-01 01:01:01') -> 366` |
| WEEK(d) | 计算日期 d 是本年的第几个星期,范围是 0 到 53 | `SELECT WEEK('2011-11-11 11:11:11') -> 45` |
| WEEKDAY(d) | 日期 d 是星期几,0 表示星期一,1 表示星期二 | `SELECT WEEKDAY("2017-06-15"); -> 3` |
| WEEKOFYEAR(d) | 计算日期 d 是本年的第几个星期,范围是 0 到 53 | `SELECT WEEKOFYEAR('2011-11-11 11:11:11') -> 45` |
| YEAR(d) | 返回年份 | `SELECT YEAR("2017-06-15"); -> 2017` |
| YEARWEEK(date, mode) | 返回年份及第几周(0到53),mode 中 0 表示周天,1表示周一,以此类推 | `SELECT YEARWEEK("2017-06-15"); -> 201724` |
------
## MySQL 高级函数
| 函数名 | 描述 | 实例 |
| :----------------------------------------------------------- | :----------------------------------------------------------- | :----------------------------------------------------------- |
| BIN(x) | 返回 x 的二进制编码 | 15 的 2 进制编码:`SELECT BIN(15); -- 1111` |
| BINARY(s) | 将字符串 s 转换为二进制字符串 | `SELECT BINARY "RUNOOB"; -> RUNOOB` |
| `CASE expression WHEN condition1 THEN result1 WHEN condition2 THEN result2 ... WHEN conditionN THEN resultN ELSE result END` | CASE 表示函数开始,END 表示函数结束。如果 condition1 成立,则返回 result1, 如果 condition2 成立,则返回 result2,当全部不成立则返回 result,而当有一个成立之后,后面的就不执行了。 | `SELECT CASE WHEN 1 > 0 THEN '1 > 0' WHEN 2 > 0 THEN '2 > 0' ELSE '3 > 0' END ->1 > 0` |
| CAST(x AS type) | 转换数据类型 | 字符串日期转换为日期:`SELECT CAST("2017-08-29" AS DATE); -> 2017-08-29` |
| COALESCE(expr1, expr2, ...., expr_n) | 返回参数中的第一个非空表达式(从左向右) | `SELECT COALESCE(NULL, NULL, NULL, 'runoob.com', NULL, 'google.com'); -> runoob.com` |
| CONNECTION_ID() | 返回服务器的连接数 | `SELECT CONNECTION_ID(); -> 4292835` |
| CONV(x,f1,f2) | 返回 f1 进制数变成 f2 进制数 | `SELECT CONV(15, 10, 2); -> 1111` |
| CONVERT(s USING cs) | 函数将字符串 s 的字符集变成 cs | `SELECT CHARSET('ABC') ->utf-8 SELECT CHARSET(CONVERT('ABC' USING gbk)) ->gbk` |
| CURRENT_USER() | 返回当前用户 | `SELECT CURRENT_USER(); -> guest@%` |
| DATABASE() | 返回当前数据库名 | `SELECT DATABASE(); -> runoob` |
| IF(expr,v1,v2) | 如果表达式 expr 成立,返回结果 v1;否则,返回结果 v2。 | `SELECT IF(1 > 0,'正确','错误') ->正确` |
| [IFNULL(v1,v2)](https://www.runoob.com/mysql/mysql-func-ifnull.html) | 如果 v1 的值不为 NULL,则返回 v1,否则返回 v2。 | `SELECT IFNULL(null,'Hello Word') ->Hello Word` |
| ISNULL(expression) | 判断表达式是否为 NULL | `SELECT ISNULL(NULL); ->1` |
| LAST_INSERT_ID() | 返回最近生成的 AUTO_INCREMENT 值 | `SELECT LAST_INSERT_ID(); ->6` |
| NULLIF(expr1, expr2) | 比较两个字符串,如果字符串 expr1 与 expr2 相等 返回 NULL,否则返回 expr1 | `SELECT NULLIF(25, 25); ->` |
| SESSION_USER() | 返回当前用户 | `SELECT SESSION_USER(); -> guest@%` |
| SYSTEM_USER() | 返回当前用户 | `SELECT SYSTEM_USER(); -> guest@%` |
| USER() | 返回当前用户 | `SELECT USER(); -> guest@%` |
| VERSION() | 返回数据库的版本号 | `SELECT VERSION() -> 5.6.34` |
**需求:**将数据库中每分钟一条的数据表,从 9:30 取到 22:00 ,以半小时为单位汇总,并输出 Excel。
数据表字段:id(序号)、incount(计数)、cdate(数据时间)
表名:m_temp
难点:时间处理
解决办法:使用 DATE_FORMAT、CONCAT、Date、Hour、Minute、Floor 函数将时间处理成半小时,在将这段时间的数据查询时 输出 cdate 统一变为 09:30,然后在 group by cdate ,用 sum(incount)求和。
1.处理时间:
示例:2018-08-21 09:30:00 至 2018-08-21 22:00:00
第一个半小时 09:30 至 10:00
将这段时间的数据查询时 输出 cdate 统一变为 09:30,然后在 group by cdate ,sum(incount)
将分钟取出 /30 , 0-29 分结果为 0 ,30-59分结果为 1 再乘以 30 分钟即变为 00 或者 30
date(cdate),取出年月日;
hour(cdate),取出小时;
minute(cdate),取出分钟;
计算(minute(cdate))/30 )*30,结果为 0 或30;
floor( (minute(cdate))/30 )*30), 处理成整数;
concat(date(cdate),' ',hour(cdate),':',floor( (minute(cdate))/30 )*30) ,按照日期格式进行拼接
DATE_FORMAT( concat(date(cdate),' ',hour(cdate),':',floor( minute(cdate)/30 )*30+12) ,'%Y-%m-%d %H:%i') ,转换成date类型
完整 SQL:
```
select sum(incount),dataStartTime from (
select incount, DATE_FORMAT( concat(date(cdate),' ',hour(cdate),':',floor( minute(cdate)/30 )*30+12) ,'%Y-%m-%d %H:%i') as dataStartTime
from m_temp WHERE cdate>='2018-08-21 09:30' and cdate<='2018-08-21 22:00' ORDER BY dataStartTime
) a
group by DATE_FORMAT( dataStartTime ,'%Y-%m-%d %H:%i')
into outfile('c:/2018-08-21Data.xls');
```
# MySQL 运算符
本章节我们主要介绍 MySQL 的运算符及运算符的优先级。 MySQL 主要有以下几种运算符:
- 算术运算符
- 比较运算符
- 逻辑运算符
- 位运算符
------
## 算术运算符
MySQL 支持的算术运算符包括:
| 运算符 | 作用 |
| :------- | :--- |
| + | 加法 |
| - | 减法 |
| * | 乘法 |
| / 或 DIV | 除法 |
| % 或 MOD | 取余 |
在除法运算和模运算中,如果除数为0,将是非法除数,返回结果为NULL。
1、加
```
mysql> select 1+2;
+-----+
| 1+2 |
+-----+
| 3 |
+-----+
```
2、减
```
mysql> select 1-2;
+-----+
| 1-2 |
+-----+
| -1 |
+-----+
```
3、乘
```
mysql> select 2*3;
+-----+
| 2*3 |
+-----+
| 6 |
+-----+
```
4、除
```
mysql> select 2/3;
+--------+
| 2/3 |
+--------+
| 0.6667 |
+--------+
```
5、商
```
mysql> select 10 DIV 4;
+----------+
| 10 DIV 4 |
+----------+
| 2 |
+----------+
```
6、取余
```
mysql> select 10 MOD 4;
+----------+
| 10 MOD 4 |
+----------+
| 2 |
+----------+
```
------
## 比较运算符
SELECT 语句中的条件语句经常要使用比较运算符。通过这些比较运算符,可以判断表中的哪些记录是符合条件的。比较结果为真,则返回 1,为假则返回 0,比较结果不确定则返回 NULL。
| 符号 | 描述 | 备注 |
| :-------------- | :------------------------- | :----------------------------------------------------------- |
| = | 等于 | |
| <>, != | 不等于 | |
| > | 大于 | |
| < | 小于 | |
| <= | 小于等于 | |
| >= | 大于等于 | |
| BETWEEN | 在两值之间 | >=min&&<=max |
| NOT BETWEEN | 不在两值之间 | |
| IN | 在集合中 | |
| NOT IN | 不在集合中 | |
| <=> | 严格比较两个NULL值是否相等 | 两个操作码均为NULL时,其所得值为1;而当一个操作码为NULL时,其所得值为0 |
| LIKE | 模糊匹配 | |
| REGEXP 或 RLIKE | 正则式匹配 | |
| IS NULL | 为空 | |
| IS NOT NULL | 不为空 | |
1、等于
```
mysql> select 2=3;
+-----+
| 2=3 |
+-----+
| 0 |
+-----+
mysql> select NULL = NULL;
+-------------+
| NULL = NULL |
+-------------+
| NULL |
+-------------+
```
2、不等于
```
mysql> select 2<>3;
+------+
| 2<>3 |
+------+
| 1 |
+------+
```
3、安全等于
与 **=** 的区别在于当两个操作码均为 NULL 时,其所得值为 1 而不为 NULL,而当一个操作码为 NULL 时,其所得值为 0而不为 NULL。
```
mysql> select 2<=>3;
+-------+
| 2<=>3 |
+-------+
| 0 |
+-------+
mysql> select null=null;
+-----------+
| null=null |
+-----------+
| NULL |
+-----------+
mysql> select null<=>null;
+-------------+
| null<=>null |
+-------------+
| 1 |
+-------------+
```
4、小于
```
mysql> select 2<3;
+-----+
| 2<3 |
+-----+
| 1 |
+-----+
```
5、小于等于
```
mysql> select 2<=3;
+------+
| 2<=3 |
+------+
| 1 |
+------+
```
6、大于
```
mysql> select 2>3;
+-----+
| 2>3 |
+-----+
| 0 |
+-----+
```
7、大于等于
```
mysql> select 2>=3;
+------+
| 2>=3 |
+------+
| 0 |
+------+
```
8、BETWEEN
```
mysql> select 5 between 1 and 10;
+--------------------+
| 5 between 1 and 10 |
+--------------------+
| 1 |
+--------------------+
```
9、IN
```
mysql> select 5 in (1,2,3,4,5);
+------------------+
| 5 in (1,2,3,4,5) |
+------------------+
| 1 |
+------------------+
```
10、NOT IN
```
mysql> select 5 not in (1,2,3,4,5);
+----------------------+
| 5 not in (1,2,3,4,5) |
+----------------------+
| 0 |
+----------------------+
```
11、IS NULL
```
mysql> select null is NULL;
+--------------+
| null is NULL |
+--------------+
| 1 |
+--------------+
mysql> select 'a' is NULL;
+-------------+
| 'a' is NULL |
+-------------+
| 0 |
+-------------+
```
12、IS NOT NULL
```
mysql> select null IS NOT NULL;
+------------------+
| null IS NOT NULL |
+------------------+
| 0 |
+------------------+
mysql> select 'a' IS NOT NULL;
+-----------------+
| 'a' IS NOT NULL |
+-----------------+
| 1 |
+-----------------+
```
13、LIKE
```
mysql> select '12345' like '12%';
+--------------------+
| '12345' like '12%' |
+--------------------+
| 1 |
+--------------------+
mysql> select '12345' like '12_';
+--------------------+
| '12345' like '12_' |
+--------------------+
| 0 |
+--------------------+
```
14、REGEXP
```
mysql> select 'beijing' REGEXP 'jing';
+-------------------------+
| 'beijing' REGEXP 'jing' |
+-------------------------+
| 1 |
+-------------------------+
mysql> select 'beijing' REGEXP 'xi';
+-----------------------+
| 'beijing' REGEXP 'xi' |
+-----------------------+
| 0 |
+-----------------------+
```
------
## 逻辑运算符
逻辑运算符用来判断表达式的真假。如果表达式是真,结果返回 1。如果表达式是假,结果返回 0。
| 运算符号 | 作用 |
| :------- | :------- |
| NOT 或 ! | 逻辑非 |
| AND | 逻辑与 |
| OR | 逻辑或 |
| XOR | 逻辑异或 |
1、与
```
mysql> select 2 and 0;
+---------+
| 2 and 0 |
+---------+
| 0 |
+---------+
mysql> select 2 and 1;
+---------+
| 2 and 1 |
+---------+
| 1 |
+---------+
```
2、或
```
mysql> select 2 or 0;
+--------+
| 2 or 0 |
+--------+
| 1 |
+--------+
mysql> select 2 or 1;
+--------+
| 2 or 1 |
+--------+
| 1 |
+--------+
mysql> select 0 or 0;
+--------+
| 0 or 0 |
+--------+
| 0 |
+--------+
mysql> select 1 || 0;
+--------+
| 1 || 0 |
+--------+
| 1 |
+--------+
```
3、非
```
mysql> select not 1;
+-------+
| not 1 |
+-------+
| 0 |
+-------+
mysql> select !0;
+----+
| !0 |
+----+
| 1 |
+----+
```
4、异或
```
mysql> select 1 xor 1;
+---------+
| 1 xor 1 |
+---------+
| 0 |
+---------+
mysql> select 0 xor 0;
+---------+
| 0 xor 0 |
+---------+
| 0 |
+---------+
mysql> select 1 xor 0;
+---------+
| 1 xor 0 |
+---------+
| 1 |
+---------+
mysql> select null or 1;
+-----------+
| null or 1 |
+-----------+
| 1 |
+-----------+
mysql> select 1 ^ 0;
+-------+
| 1 ^ 0 |
+-------+
| 1 |
+-------+
```
------
## 位运算符
位运算符是在二进制数上进行计算的运算符。位运算会先将操作数变成二进制数,进行位运算。然后再将计算结果从二进制数变回十进制数。
| 运算符号 | 作用 |
| :------- | :------- |
| & | 按位与 |
| \| | 按位或 |
| ^ | 按位异或 |
| ! | 取反 |
| << | 左移 |
| >> | 右移 |
1、按位与
```
mysql> select 3&5;
+-----+
| 3&5 |
+-----+
| 1 |
+-----+
```
2、按位或
```
mysql> select 3|5;
+-----+
| 3|5 |
+-----+
| 7 |
+-----+
```
3、按位异或
```
mysql> select 3^5;
+-----+
| 3^5 |
+-----+
| 6 |
+-----+
```
4、按位取反
```
mysql> select ~18446744073709551612;
+-----------------------+
| ~18446744073709551612 |
+-----------------------+
| 3 |
+-----------------------+
```
5、按位右移
```
mysql> select 3>>1;
+------+
| 3>>1 |
+------+
| 1 |
+------+
```
6、按位左移
```
mysql> select 3<<1;
+------+
| 3<<1 |
+------+
| 6 |
+------+
```
------
## 运算符优先级
最低优先级为: **:=**。
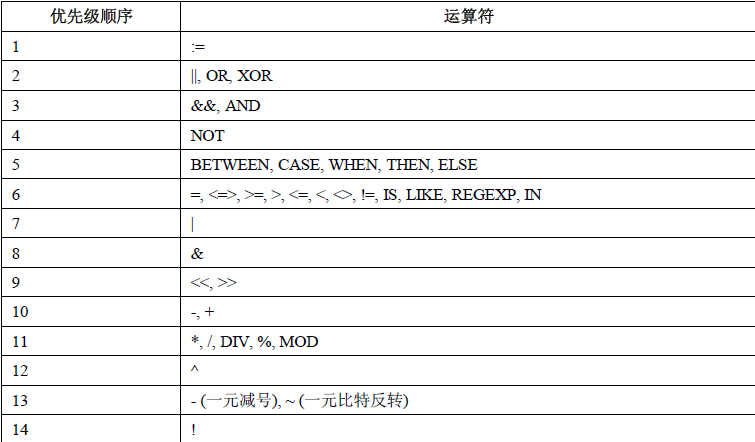
最高优先级为: **!**、**BINARY**、 **COLLATE**。
## MySQL实战
Student(S#,Sname,Sage,Ssex) 学生表
Course(C#,Cname,T#) 课程表
SC(S#,C#,score) 成绩表
Teacher(T#,Tname) 教师表
问题:
1、查询“001”课程比“002”课程成绩高的所有学生的学号;
select a.S# from (select s#,score from SC where C#='001') a,(select s#,score
from SC where C#='002') b
where a.score>b.score and a.s#=b.s#;
2、查询平均成绩大于60分的同学的学号和平均成绩;
select S#,avg(score)
from sc
group by S# having avg(score) >60;
3、查询所有同学的学号、姓名、选课数、总成绩;
select Student.S#,Student.Sname,count(SC.C#),sum(score)
from Student left Outer join SC on Student.S#=SC.S#
group by Student.S#,Sname
4、查询姓“李”的老师的个数;
select count(distinct(Tname))
from Teacher
where Tname like '李%';
5、查询没学过“叶平”老师课的同学的学号、姓名;
select Student.S#,Student.Sname
from Student
where S# not in (select distinct( SC.S#) from SC,Course,Teacher where SC.C#=Course.C# and Teacher.T#=Course.T# and Teacher.Tname='叶平');
6、查询学过“001”并且也学过编号“002”课程的同学的学号、姓名;
select Student.S#,Student.Sname from Student,SC where Student.S#=SC.S# and SC.C#='001'and exists( Select * from SC as SC_2 where SC_2.S#=SC.S# and SC_2.C#='002');
7、查询学过“叶平”老师所教的所有课的同学的学号、姓名;
select S#,Sname
from Student
where S# in (select S# from SC ,Course ,Teacher where SC.C#=Course.C# and Teacher.T#=Course.T# and Teacher.Tname='叶平' group by S# having count(SC.C#)=(select count(C#) from Course,Teacher where Teacher.T#=Course.T# and Tname='叶平'));
8、查询课程编号“002”的成绩比课程编号“001”课程低的所有同学的学号、姓名;
Select S#,Sname from (select Student.S#,Student.Sname,score ,(select score from SC SC_2 where SC_2.S#=Student.S# and SC_2.C#='002') score2
from Student,SC where Student.S#=SC.S# and C#='001') S_2 where score2 60);
10、查询没有学全所有课的同学的学号、姓名;
select Student.S#,Student.Sname
from Student,SC
where Student.S#=SC.S# group by Student.S#,Student.Sname having count(C#) <(select count(C#) from Course);
11、查询至少有一门课与学号为“1001”的同学所学相同的同学的学号和姓名;
select S#,Sname from Student,SC where Student.S#=SC.S# and C# in select C# from SC where S#='1001';
12、查询至少学过学号为“001”同学所有一门课的其他同学学号和姓名;
select distinct SC.S#,Sname
from Student,SC
where Student.S#=SC.S# and C# in (select C# from SC where S#='001');
13、把“SC”表中“叶平”老师教的课的成绩都更改为此课程的平均成绩;
update SC set score=(select avg(SC_2.score)
from SC SC_2
where SC_2.C#=SC.C# ) from Course,Teacher where Course.C#=SC.C# and Course.T#=Teacher.T# and Teacher.Tname='叶平');
14、查询和“1002”号的同学学习的课程完全相同的其他同学学号和姓名;
select S# from SC where C# in (select C# from SC where S#='1002')
group by S# having count(*)=(select count(*) from SC where S#='1002');
15、删除学习“叶平”老师课的SC表记录;
Delect SC
from course ,Teacher
where Course.C#=SC.C# and Course.T#= Teacher.T# and Tname='叶平';
16、向SC表中插入一些记录,这些记录要求符合以下条件:没有上过编号“003”课程的同学学号、2、
号课的平均成绩;
Insert SC select S#,'002',(Select avg(score)
from SC where C#='002') from Student where S# not in (Select S# from SC where C#='002');
17、按平均成绩从高到低显示所有学生的“数据库”、“企业管理”、“英语”三门的课程成绩,按如下形式显示: 学生ID,,数据库,企业管理,英语,有效课程数,有效平均分
SELECT S# as 学生ID
,(SELECT score FROM SC WHERE SC.S#=t.S# AND C#='004') AS 数据库
,(SELECT score FROM SC WHERE SC.S#=t.S# AND C#='001') AS 企业管理
,(SELECT score FROM SC WHERE SC.S#=t.S# AND C#='006') AS 英语
,COUNT(*) AS 有效课程数, AVG(t.score) AS 平均成绩
FROM SC AS t
GROUP BY S#
ORDER BY avg(t.score)
18、查询各科成绩最高和最低的分:以如下形式显示:课程ID,最高分,最低分
SELECT L.C# As 课程ID,L.score AS 最高分,R.score AS 最低分
FROM SC L ,SC AS R
WHERE L.C# = R.C# and
L.score = (SELECT MAX(IL.score)
FROM SC AS IL,Student AS IM
WHERE L.C# = IL.C# and IM.S#=IL.S#
GROUP BY IL.C#)
AND
R.Score = (SELECT MIN(IR.score)
FROM SC AS IR
WHERE R.C# = IR.C#
GROUP BY IR.C#
);
19、按各科平均成绩从低到高和及格率的百分数从高到低顺序
SELECT t.C# AS 课程号,max(course.Cname)AS 课程名,isnull(AVG(score),0) AS 平均成绩
,100 * SUM(CASE WHEN isnull(score,0)>=60 THEN 1 ELSE 0 END)/COUNT(*) AS 及格百分数
FROM SC T,Course
where t.C#=course.C#
GROUP BY t.C#
ORDER BY 100 * SUM(CASE WHEN isnull(score,0)>=60 THEN 1 ELSE 0 END)/COUNT(*) DESC
20、查询如下课程平均成绩和及格率的百分数(用"1行"显示): 企业管理(001),马克思(002),OO&UML (003),数据库(004)
SELECT SUM(CASE WHEN C# ='001' THEN score ELSE 0 END)/SUM(CASE C# WHEN '001' THEN 1 ELSE 0 END) AS 企业管理平均分
,100 * SUM(CASE WHEN C# = '001' AND score >= 60 THEN 1 ELSE 0 END)/SUM(CASE WHEN C# = '001' THEN 1 ELSE 0 END) AS 企业管理及格百分数
,SUM(CASE WHEN C# = '002' THEN score ELSE 0 END)/SUM(CASE C# WHEN '002' THEN 1 ELSE 0 END) AS 马克思平均分
,100 * SUM(CASE WHEN C# = '002' AND score >= 60 THEN 1 ELSE 0 END)/SUM(CASE WHEN C# = '002' THEN 1 ELSE 0 END) AS 马克思及格百分数
,SUM(CASE WHEN C# = '003' THEN score ELSE 0 END)/SUM(CASE C# WHEN '003' THEN 1 ELSE 0 END) AS UML平均分
,100 * SUM(CASE WHEN C# = '003' AND score >= 60 THEN 1 ELSE 0 END)/SUM(CASE WHEN C# = '003' THEN 1 ELSE 0 END) AS UML及格百分数
,SUM(CASE WHEN C# = '004' THEN score ELSE 0 END)/SUM(CASE C# WHEN '004' THEN 1 ELSE 0 END) AS 数据库平均分
,100 * SUM(CASE WHEN C# = '004' AND score >= 60 THEN 1 ELSE 0 END)/SUM(CASE WHEN C# = '004' THEN 1 ELSE 0 END) AS 数据库及格百分数
FROM SC
21、查询不同老师所教不同课程平均分从高到低显示
SELECT max(Z.T#) AS 教师ID,MAX(Z.Tname) AS 教师姓名,C.C# AS 课程ID,MAX(C.Cname) AS 课程名称,AVG(Score) AS 平均成绩
FROM SC AS T,Course AS C ,Teacher AS Z
where T.C#=C.C# and C.T#=Z.T#
GROUP BY C.C#
ORDER BY AVG(Score) DESC
22、查询如下课程成绩第 3 名到第 6 名的学生成绩单:企业管理(001),马克思(002),UML (003),数据库(004)
[学生ID],[学生姓名],企业管理,马克思,UML,数据库,平均成绩
SELECT DISTINCT top 3
SC.S# As 学生学号,
Student.Sname AS 学生姓名 ,
T1.score AS 企业管理,
T2.score AS 马克思,
T3.score AS UML,
T4.score AS 数据库,
ISNULL(T1.score,0) + ISNULL(T2.score,0) + ISNULL(T3.score,0) + ISNULL(T4.score,0) as 总分
FROM Student,SC LEFT JOIN SC AS T1
ON SC.S# = T1.S# AND T1.C# = '001'
LEFT JOIN SC AS T2
ON SC.S# = T2.S# AND T2.C# = '002'
LEFT JOIN SC AS T3
ON SC.S# = T3.S# AND T3.C# = '003'
LEFT JOIN SC AS T4
ON SC.S# = T4.S# AND T4.C# = '004'
WHERE student.S#=SC.S# and
ISNULL(T1.score,0) + ISNULL(T2.score,0) + ISNULL(T3.score,0) + ISNULL(T4.score,0)
NOT IN
(SELECT
DISTINCT
TOP 15 WITH TIES
ISNULL(T1.score,0) + ISNULL(T2.score,0) + ISNULL(T3.score,0) + ISNULL(T4.score,0)
FROM sc
LEFT JOIN sc AS T1
ON sc.S# = T1.S# AND T1.C# = 'k1'
LEFT JOIN sc AS T2
ON sc.S# = T2.S# AND T2.C# = 'k2'
LEFT JOIN sc AS T3
ON sc.S# = T3.S# AND T3.C# = 'k3'
LEFT JOIN sc AS T4
ON sc.S# = T4.S# AND T4.C# = 'k4'
ORDER BY ISNULL(T1.score,0) + ISNULL(T2.score,0) + ISNULL(T3.score,0) + ISNULL(T4.score,0) DESC);
23、统计列印各科成绩,各分数段人数:课程ID,课程名称,[100-85],[85-70],[70-60],[ <60]
SELECT SC.C# as 课程ID, Cname as 课程名称
,SUM(CASE WHEN score BETWEEN 85 AND 100 THEN 1 ELSE 0 END) AS [100 - 85]
,SUM(CASE WHEN score BETWEEN 70 AND 85 THEN 1 ELSE 0 END) AS [85 - 70]
,SUM(CASE WHEN score BETWEEN 60 AND 70 THEN 1 ELSE 0 END) AS [70 - 60]
,SUM(CASE WHEN score < 60 THEN 1 ELSE 0 END) AS [60 -]
FROM SC,Course
where SC.C#=Course.C#
GROUP BY SC.C#,Cname;
24、查询学生平均成绩及其名次
SELECT 1+(SELECT COUNT( distinct 平均成绩)
FROM (SELECT S#,AVG(score) AS 平均成绩
FROM SC
GROUP BY S#
) AS T1
WHERE 平均成绩 > T2.平均成绩) as 名次,
S# as 学生学号,平均成绩
FROM (SELECT S#,AVG(score) 平均成绩
FROM SC
GROUP BY S#
) AS T2
ORDER BY 平均成绩 desc;
25、查询各科成绩前三名的记录:(不考虑成绩并列情况)
SELECT t1.S# as 学生ID,t1.C# as 课程ID,Score as 分数
FROM SC t1
WHERE score IN (SELECT TOP 3 score
FROM SC
WHERE t1.C#= C#
ORDER BY score DESC
)
ORDER BY t1.C#;
26、查询每门课程被选修的学生数
select c#,count(S#) from sc group by C#;
27、查询出只选修了一门课程的全部学生的学号和姓名
select SC.S#,Student.Sname,count(C#) AS 选课数
from SC ,Student
where SC.S#=Student.S# group by SC.S# ,Student.Sname having count(C#)=1;
28、查询男生、女生人数
Select count(Ssex) as 男生人数 from Student group by Ssex having Ssex='男';
Select count(Ssex) as 女生人数 from Student group by Ssex having Ssex='女';
29、查询姓“张”的学生名单
SELECT Sname FROM Student WHERE Sname like '张%';
30、查询同名同性学生名单,并统计同名人数
select Sname,count(*) from Student group by Sname having count(*)>1;
31、1981年出生的学生名单(注:Student表中Sage列的类型是datetime)
select Sname, CONVERT(char (11),DATEPART(year,Sage)) as age
from student
where CONVERT(char(11),DATEPART(year,Sage))='1981';
32、查询每门课程的平均成绩,结果按平均成绩升序排列,平均成绩相同时,按课程号降序排列
Select C#,Avg(score) from SC group by C# order by Avg(score),C# DESC ;
33、查询平均成绩大于85的所有学生的学号、姓名和平均成绩
select Sname,SC.S# ,avg(score)
from Student,SC
where Student.S#=SC.S# group by SC.S#,Sname having avg(score)>85;
34、查询课程名称为“数据库”,且分数低于60的学生姓名和分数
Select Sname,isnull(score,0)
from Student,SC,Course
where SC.S#=Student.S# and SC.C#=Course.C# and Course.Cname='数据库'and score <60;
35、查询所有学生的选课情况;
SELECT SC.S#,SC.C#,Sname,Cname
FROM SC,Student,Course
where SC.S#=Student.S# and SC.C#=Course.C# ;
36、查询任何一门课程成绩在70分以上的姓名、课程名称和分数;
SELECT distinct student.S#,student.Sname,SC.C#,SC.score
FROM student,Sc
WHERE SC.score>=70 AND SC.S#=student.S#;
37、查询不及格的课程,并按课程号从大到小排列
select c# from sc where scor e <60 order by C# ;
38、查询课程编号为003且课程成绩在80分以上的学生的学号和姓名;
select SC.S#,Student.Sname from SC,Student where SC.S#=Student.S# and Score>80 and C#='003';
39、求选了课程的学生人数
select count(*) from sc;
40、查询选修“叶平”老师所授课程的学生中,成绩最高的学生姓名及其成绩
select Student.Sname,score
from Student,SC,Course C,Teacher
where Student.S#=SC.S# and SC.C#=C.C# and C.T#=Teacher.T# and Teacher.Tname='叶平' and SC.score=(select max(score)from SC where C#=C.C# );
41、查询各个课程及相应的选修人数
select count(*) from sc group by C#;
42、查询不同课程成绩相同的学生的学号、课程号、学生成绩
select distinct A.S#,B.score from SC A ,SC B where A.Score=B.Score and A.C# <>B.C# ;
43、查询每门功成绩最好的前两名
SELECT t1.S# as 学生ID,t1.C# as 课程ID,Score as 分数
FROM SC t1
WHERE score IN (SELECT TOP 2 score
FROM SC
WHERE t1.C#= C#
ORDER BY score DESC
)
ORDER BY t1.C#;
44、统计每门课程的学生选修人数(超过10人的课程才统计)。要求输出课程号和选修人数,查询结果按人数降序排列,查询结果按人数降序排列,若人数相同,按课程号升序排列
select C# as 课程号,count(*) as 人数
from sc
group by C#
order by count(*) desc,c#
45、检索至少选修两门课程的学生学号
select S#
from sc
group by s#
having count(*) > = 2
46、查询全部学生都选修的课程的课程号和课程名
select C#,Cname
from Course
where C# in (select c# from sc group by c#)
47、查询没学过“叶平”老师讲授的任一门课程的学生姓名
select Sname from Student where S# not in (select S# from Course,Teacher,SC where Course.T#=Teacher.T# and SC.C#=course.C# and Tname='叶平');
48、查询两门以上不及格课程的同学的学号及其平均成绩
select S#,avg(isnull(score,0)) from SC where S# in (select S# from SC where score <60 group by S# having count(*)>2)group by S#;
49、检索“004”课程分数小于60,按分数降序排列的同学学号
select S# from SC where C#='004'and score <60 order by score desc;
50、删除“002”同学的“001”课程的成绩
delete from Sc where S#='001'and C#='001';
## MySQL安装和升级
### Linux上安装
### Window上安装
### FreeBSD上安装
### MacOS上安装
### 安装后设置和测试
### 升级或降级MySQL
## MySQL服务器
连接服务器
介绍连接服务器的命令和修改密码等
输入查询
不适用数据库进行查询
例如 select version(),current_date;
## MySQL服务器配置
配置服务器
mysqld -verbose --help
查看系统变量
show variables;
show status;
服务器默认配置
## MySQL数据目录
## MySQL服务器日志
常规查询和慢查询日志输出目的地
错误日志
常规查询日志
二进制日志
慢查询日志
DDL日志
服务器维护日志
## MySQL服务器插件
安装插件
卸载插件
企业线程池
重写器查询重写插件
版本标记
## MySQL单机多实例
## MySQL安全性
密码安全
MySQL访问权限
## MySQL用户账户管理
MySQL备份和恢复
## MySQL数据库的创建和使用
查找服务器所有数据库
show databases;
查看当前数据库
select database();
访问某个数据库
use test;
创建数据库
create databases xxx;
使用某个数据库
use xxx;
## MySQL存储引擎
## MySQL表的创建和使用
展示所有的表
show tables;
查看表的结构
describe xxx;
创建表
create table xxx();
查看表的结构
describe xxx;
如何加载数据
load data
如何添加一条记录
insert into
## MySQL语言结构
**目录**
9.1字面值
9.1.1字符串文字9.1.2数字文字9。1日期和时间文字9.1.4十六进制文字9.1.5比特值文字9.1.6布尔文字9.1.7 NULL值
[9.2模式对象名称](file:///D:/pdf/documents/refman-8.0-en.html-chapter/language-structure.html#identifiers)
[9.2.1标识符限定符](file:///D:/pdf/documents/refman-8.0-en.html-chapter/language-structure.html#identifier-qualifiers)[9.2.2标识符区分大小写](file:///D:/pdf/documents/refman-8.0-en.html-chapter/language-structure.html#identifier-case-sensitivity)[9.2.3标识符到文件名的映射](file:///D:/pdf/documents/refman-8.0-en.html-chapter/language-structure.html#identifier-mapping)[9.2.4函数名称解析和解析](file:///D:/pdf/documents/refman-8.0-en.html-chapter/language-structure.html#function-resolution)
[9.3关键字和保留字](file:///D:/pdf/documents/refman-8.0-en.html-chapter/language-structure.html#keywords)
[9.4用户定义的变量](file:///D:/pdf/documents/refman-8.0-en.html-chapter/language-structure.html#user-variables)
[9.5表达式语法](file:///D:/pdf/documents/refman-8.0-en.html-chapter/language-structure.html#expressions)
9.6注释语法
9.6注释语法
9.6注释语法
## MySQL数据类型
## MySQL字符集
## MySQL排序规则
## MySQL函数
## MySQL操作符
## MySQL语句和语法
## MySQL检索信息
```
SELECT what_to_select
FROM which_table
WHERE conditions_to_satisfy;
```
查询所有数据
select * from xxx;
选择特定行
select * from where name ='xxx';
选择特定列
select name from xxx;
排序行
select * from xx order by name;
升序
asc
降序
desc
使用 NULL值
select 1 is null ,1 is not null;
你不能使用算术比较操作符,如 [`=`](file:///D:/pdf/documents/refman-8.0-en.html-chapter/functions.html#operator_equal), [`<`](file:///D:/pdf/documents/refman-8.0-en.html-chapter/functions.html#operator_less-than)或 [`<>`](file:///D:/pdf/documents/refman-8.0-en.html-chapter/functions.html#operator_not-equal)以测试`NULL`。要自己演示,请尝试以下查询:
```
MySQL的> SELECT 1 = NULL, 1 <> NULL, 1 < NULL, 1 > NULL;
```
模式匹配
查询行数
select count(*) from xxx;
分组
group by
使用多张表
常见查询示例
3.6.1列的最大值
3.6.2保持某列最大值的行
3.6.3每组最大列数
3.6.4保持某一列的分组最大值的行
3.6.5使用用户定义的变量
3.6.6使用外键
3.6.7搜索两个密钥
3.6.8计算每日访问量
3.6.9使用AUTO_INCREMENT
## MySQL优化
[8.1优化概述](file:///D:/pdf/documents/refman-8.0-en.html-chapter/optimization.html#optimize-overview)
[8.2优化SQL语句](file:///D:/pdf/documents/refman-8.0-en.html-chapter/optimization.html#statement-optimization)
- [8.2.1优化SELECT语句](file:///D:/pdf/documents/refman-8.0-en.html-chapter/optimization.html#select-optimization)
- [8.2.2优化子查询,派生表,查看引用和公用表表达式](file:///D:/pdf/documents/refman-8.0-en.html-chapter/optimization.html#subquery-optimization)
- [8.2.3优化INFORMATION_SCHEMA查询](file:///D:/pdf/documents/refman-8.0-en.html-chapter/optimization.html#information-schema-optimization)
- [8.2.4优化性能模式查询](file:///D:/pdf/documents/refman-8.0-en.html-chapter/optimization.html#performance-schema-optimization)
- [8.2.5优化数据变更声明](file:///D:/pdf/documents/refman-8.0-en.html-chapter/optimization.html#data-change-optimization)
- [8.2.6优化数据库权限](file:///D:/pdf/documents/refman-8.0-en.html-chapter/optimization.html#permission-optimization)
- [8.2.7其他优化技巧](file:///D:/pdf/documents/refman-8.0-en.html-chapter/optimization.html#miscellaneous-optimization-tips)
[8.3优化和索引](file:///D:/pdf/documents/refman-8.0-en.html-chapter/optimization.html#optimization-indexes)
- [8.3.1 MySQL如何使用索引](file:///D:/pdf/documents/refman-8.0-en.html-chapter/optimization.html#mysql-indexes)
- [8.3.2主键优化](file:///D:/pdf/documents/refman-8.0-en.html-chapter/optimization.html#primary-key-optimization)
- [8.3.3空间索引优化](file:///D:/pdf/documents/refman-8.0-en.html-chapter/optimization.html#spatial-index-optimization)
- [8.3.4外键优化](file:///D:/pdf/documents/refman-8.0-en.html-chapter/optimization.html#foreign-key-optimization)
- [8.3.5列索引](file:///D:/pdf/documents/refman-8.0-en.html-chapter/optimization.html#column-indexes)
- [8.3.6多列索引](file:///D:/pdf/documents/refman-8.0-en.html-chapter/optimization.html#multiple-column-indexes)
- [8.3.7验证索引使用情况](file:///D:/pdf/documents/refman-8.0-en.html-chapter/optimization.html#verifying-index-usage)
- [8.3.8 InnoDB和MyISAM索引统计信息收集](file:///D:/pdf/documents/refman-8.0-en.html-chapter/optimization.html#index-statistics)
- [8.3.9 B树和哈希索引的比较](file:///D:/pdf/documents/refman-8.0-en.html-chapter/optimization.html#index-btree-hash)
- [8.3.10索引扩展的使用](file:///D:/pdf/documents/refman-8.0-en.html-chapter/optimization.html#index-extensions)
- [8.3.11生成列索引的优化程序使用](file:///D:/pdf/documents/refman-8.0-en.html-chapter/optimization.html#generated-column-index-optimizations)
- [8.3.12隐形指数](file:///D:/pdf/documents/refman-8.0-en.html-chapter/optimization.html#invisible-indexes)
- [8.3.13降序索引](file:///D:/pdf/documents/refman-8.0-en.html-chapter/optimization.html#descending-indexes)
[8.4优化数据库结构](file:///D:/pdf/documents/refman-8.0-en.html-chapter/optimization.html#optimizing-database-structure)
- [8.4.1优化数据大小](file:///D:/pdf/documents/refman-8.0-en.html-chapter/optimization.html#data-size)
- [8.4.2优化MySQL数据类型](file:///D:/pdf/documents/refman-8.0-en.html-chapter/optimization.html#optimize-data-types)
- [8.4.3优化许多表格](file:///D:/pdf/documents/refman-8.0-en.html-chapter/optimization.html#optimize-multi-tables)
- [8.4.4 MySQL中的内部临时表使用](file:///D:/pdf/documents/refman-8.0-en.html-chapter/optimization.html#internal-temporary-tables)
[8.5优化InnoDB表](file:///D:/pdf/documents/refman-8.0-en.html-chapter/optimization.html#optimizing-innodb)
- [8.5.1优化InnoDB表的存储布局](file:///D:/pdf/documents/refman-8.0-en.html-chapter/optimization.html#optimizing-innodb-storage-layout)
- [8.5.2优化InnoDB事务管理](file:///D:/pdf/documents/refman-8.0-en.html-chapter/optimization.html#optimizing-innodb-transaction-management)
- [8.5.3优化InnoDB只读事务](file:///D:/pdf/documents/refman-8.0-en.html-chapter/optimization.html#innodb-performance-ro-txn)
- [8.5.4优化InnoDB重做日志](file:///D:/pdf/documents/refman-8.0-en.html-chapter/optimization.html#optimizing-innodb-logging)
- [8.5.5 InnoDB表的批量数据加载](file:///D:/pdf/documents/refman-8.0-en.html-chapter/optimization.html#optimizing-innodb-bulk-data-loading)
- [8.5.6优化InnoDB查询](file:///D:/pdf/documents/refman-8.0-en.html-chapter/optimization.html#optimizing-innodb-queries)
- [8.5.7优化InnoDB DDL操作](file:///D:/pdf/documents/refman-8.0-en.html-chapter/optimization.html#optimizing-innodb-ddl-operations)
- [8.5.8优化InnoDB磁盘I / O.](file:///D:/pdf/documents/refman-8.0-en.html-chapter/optimization.html#optimizing-innodb-diskio)
- [8.5.9优化InnoDB配置变量](file:///D:/pdf/documents/refman-8.0-en.html-chapter/optimization.html#optimizing-innodb-configuration-variables)
- [8.5.10为具有多个表的系统优化InnoDB](file:///D:/pdf/documents/refman-8.0-en.html-chapter/optimization.html#optimizing-innodb-many-tables)
[8.6优化MyISAM表](file:///D:/pdf/documents/refman-8.0-en.html-chapter/optimization.html#optimizing-myisam)
- [8.6.1优化MyISAM查询](file:///D:/pdf/documents/refman-8.0-en.html-chapter/optimization.html#optimizing-queries-myisam)
- [8.6.2 MyISAM表的批量数据加载](file:///D:/pdf/documents/refman-8.0-en.html-chapter/optimization.html#optimizing-myisam-bulk-data-loading)
- [8.6.3优化REPAIR TABLE语句](file:///D:/pdf/documents/refman-8.0-en.html-chapter/optimization.html#repair-table-optimization)
[8.7优化MEMORY表](file:///D:/pdf/documents/refman-8.0-en.html-chapter/optimization.html#optimizing-memory-tables)
[8.8了解查询执行计划](file:///D:/pdf/documents/refman-8.0-en.html-chapter/optimization.html#execution-plan-information)
- [8.8.1使用EXPLAIN优化查询](file:///D:/pdf/documents/refman-8.0-en.html-chapter/optimization.html#using-explain)
- [8.8.2 EXPLAIN输出格式](file:///D:/pdf/documents/refman-8.0-en.html-chapter/optimization.html#explain-output)
- [8.8.3扩展EXPLAIN输出格式](file:///D:/pdf/documents/refman-8.0-en.html-chapter/optimization.html#explain-extended)
- [8.8.4获取命名连接的执行计划信息](file:///D:/pdf/documents/refman-8.0-en.html-chapter/optimization.html#explain-for-connection)
- [8.8.5估计查询性能](file:///D:/pdf/documents/refman-8.0-en.html-chapter/optimization.html#estimating-performance)
[8.9控制查询优化器](file:///D:/pdf/documents/refman-8.0-en.html-chapter/optimization.html#controlling-optimizer)
- [8.9.1控制查询计划评估](file:///D:/pdf/documents/refman-8.0-en.html-chapter/optimization.html#controlling-query-plan-evaluation)
- [8.9.2优化器提示](file:///D:/pdf/documents/refman-8.0-en.html-chapter/optimization.html#optimizer-hints)
- [8.9.3可切换的优化](file:///D:/pdf/documents/refman-8.0-en.html-chapter/optimization.html#switchable-optimizations)
- [8.9.4索引提示](file:///D:/pdf/documents/refman-8.0-en.html-chapter/optimization.html#index-hints)
- [8.9.5优化器成本模型](file:///D:/pdf/documents/refman-8.0-en.html-chapter/optimization.html#cost-model)
- [8.9.6优化器统计](file:///D:/pdf/documents/refman-8.0-en.html-chapter/optimization.html#optimizer-statistics)
[8.10缓冲和缓存](file:///D:/pdf/documents/refman-8.0-en.html-chapter/optimization.html#buffering-caching)
- [8.10.1 InnoDB缓冲池优化](file:///D:/pdf/documents/refman-8.0-en.html-chapter/optimization.html#innodb-buffer-pool-optimization)
- [8.10.2 MyISAM密钥缓存](file:///D:/pdf/documents/refman-8.0-en.html-chapter/optimization.html#myisam-key-cache)
- [8.10.3准备好的语句和存储程序的缓存](file:///D:/pdf/documents/refman-8.0-en.html-chapter/optimization.html#statement-caching)
[8.11优化锁定操作](file:///D:/pdf/documents/refman-8.0-en.html-chapter/optimization.html#locking-issues)
- [8.11.1内部锁定方法](file:///D:/pdf/documents/refman-8.0-en.html-chapter/optimization.html#internal-locking)
- [8.11.2表锁定问题](file:///D:/pdf/documents/refman-8.0-en.html-chapter/optimization.html#table-locking)
- [8.11.3并发插入](file:///D:/pdf/documents/refman-8.0-en.html-chapter/optimization.html#concurrent-inserts)
- [8.11.4元数据锁定](file:///D:/pdf/documents/refman-8.0-en.html-chapter/optimization.html#metadata-locking)
- [8.11.5外部锁定](file:///D:/pdf/documents/refman-8.0-en.html-chapter/optimization.html#external-locking)
[8.12优化MySQL服务器](file:///D:/pdf/documents/refman-8.0-en.html-chapter/optimization.html#optimizing-server)
- [8.12.1优化磁盘I / O.](file:///D:/pdf/documents/refman-8.0-en.html-chapter/optimization.html#disk-issues)
- [8.12.2使用符号链接](file:///D:/pdf/documents/refman-8.0-en.html-chapter/optimization.html#symbolic-links)
- [8.12.3优化内存使用](file:///D:/pdf/documents/refman-8.0-en.html-chapter/optimization.html#optimizing-memory)
- [8.12.4优化网络使用](file:///D:/pdf/documents/refman-8.0-en.html-chapter/optimization.html#optimizing-network)
- [8.12.5资源组](file:///D:/pdf/documents/refman-8.0-en.html-chapter/optimization.html#resource-groups)
[8.13衡量绩效(基准)](file:///D:/pdf/documents/refman-8.0-en.html-chapter/optimization.html#optimize-benchmarking)
- [8.13.1测量表达式和函数的速度](file:///D:/pdf/documents/refman-8.0-en.html-chapter/optimization.html#select-benchmarking)
- [8.13.2使用您自己的基准](file:///D:/pdf/documents/refman-8.0-en.html-chapter/optimization.html#custom-benchmarks)
- [8.13.3使用performance_schema测量性能](file:///D:/pdf/documents/refman-8.0-en.html-chapter/optimization.html#monitoring-performance-schema)
[8.14检查线程信息](file:///D:/pdf/documents/refman-8.0-en.html-chapter/optimization.html#thread-information)
- [8.14.1线程命令值](file:///D:/pdf/documents/refman-8.0-en.html-chapter/optimization.html#thread-commands)
- [8.14.2一般线程状态](file:///D:/pdf/documents/refman-8.0-en.html-chapter/optimization.html#general-thread-states)
- [8.14.3复制主线程状态](file:///D:/pdf/documents/refman-8.0-en.html-chapter/optimization.html#master-thread-states)
- [8.14.4复制从站I / O线程状态](file:///D:/pdf/documents/refman-8.0-en.html-chapter/optimization.html#slave-io-thread-states)
- [8.14.5复制从属SQL线程状态](file:///D:/pdf/documents/refman-8.0-en.html-chapter/optimization.html#slave-sql-thread-states)
- [8.14.6复制从站连接线程状态](file:///D:/pdf/documents/refman-8.0-en.html-chapter/optimization.html#slave-connection-thread-states)
- [8.14.7事件调度程序线程状态](file:///D:/pdf/documents/refman-8.0-en.html-chapter/optimization.html#event-scheduler-thread-states)
MySQL索引
MySQL之innoDB存储引擎
MySQL复制
MySQL组复制
MySQL shell
MySQL存储文档
InnoDB集群
MySQL分区
MySQL存储过程
MySQL视图
MySQL之INFORMATION_SCHEMA表
MySQL性能架构
MySQL连接器
MySQL API
MySQL查看问题
MySQL查询语句实战
MySQL调优之实战