# CyberVerse
**Repository Path**: EwenWan/CyberVerse
## Basic Information
- **Project Name**: CyberVerse
- **Description**: https://github.com/dsd2077/CyberVerse 实时数字人 智能体框架
- **Primary Language**: Unknown
- **License**: GPL-3.0
- **Default Branch**: main
- **Homepage**: None
- **GVP Project**: No
## Statistics
- **Stars**: 1
- **Forks**: 0
- **Created**: 2026-06-01
- **Last Updated**: 2026-09-21
## Categories & Tags
**Categories**: Uncategorized
**Tags**: None
## README
CyberVerse
CyberVerse 是一个开源的实时数字人 Agent 框架。它基于 WebRTC、人设记忆、工具、RAG 和可选的数字人视频能力,帮助你构建以语音交互为核心的 AI Agent。
English · 简体中文 · 日本語 · 한국어


---
### 一张照片,让数字人真正「活」起来。
> 你是否想过拥有一个属于自己的 J.A.R.V.I.S.——能真正看见你、听见你、陪伴你的 AI?
>
> 想再次见到思念之人,听见 TA 的声音,看见 TA 对你微笑?
>
> 又或者,你一直想把某个角色带到现实世界中?
>
> **只需一张照片,CyberVerse 就能让 TA 「活」过来。**
## 什么是数字人 Agent?

## 演示
以下角色仅用于 Demo 演示,不会随 CyberVerse 内置提供,也不用于商业用途。


| [](https://youtu.be/Lk88sew2x4o) | [](https://youtu.be/8jdQ3ThcwgA) |
|:---:|:---:|
| [**爱丽丝 — 在 YouTube 观看**](https://youtu.be/Lk88sew2x4o) | [**丽娜 — 在 YouTube 观看**](https://youtu.be/8jdQ3ThcwgA) |
| [](https://youtu.be/WjEHUYZx5Gs) |
|:---:|
| [**小龙女 — 在 YouTube 观看**](https://youtu.be/WjEHUYZx5Gs) |
## 功能特性
### 实时语音 Agent
语音是 CyberVerse 的默认交互方式,面向低延迟、可长时间进行的实时对话。用户可以通过麦克风与 Agent 连续交流,在模型说话时随时打断,也可以在同一轮会话中混合使用语音和文本输入。
每个角色可单独配置声线、欢迎语与人格设定,并支持语音克隆。对话过程中支持会话中断与恢复;将 `inference.avatar.enabled` 设为 `false` 时,平台会以纯语音模式运行,只发布音频流,无需本地 Avatar GPU,核心语音体验保持不变。
### 基于 WebRTC 的音视频
会话链路基于 WebRTC 构建,可按部署场景选择直连 P2P(内嵌 TURN / NAT 穿透)或 LiveKit SFU 模式,兼顾低延迟与复杂网络环境下的连通性。
在 standard 模式及受支持的 omni 会话中,Agent 还可以接收用户摄像头画面或屏幕共享帧作为视觉输入,实现「能听、能看」的面对面式交互,而不局限于纯文本上下文。
### PersonaAgent + SubAgent 任务
CyberVerse 采用multi-agent架构:PersonaAgent 始终驻守前台,负责与用户保持流畅对话、快速响应打断和上下文切换;搜索、调研、资料整理、总结以及 HTML 报告生成等耗时工作则交给后台 SubAgent 异步执行。
这样复杂任务不会拖慢语音回合,用户可以继续说话、追问或调整方向,待 SubAgent 完成后再把结果回传给前台对话。
### 角色记忆与 RAG
每个角色的会话历史会持久化到本地磁盘,重新进入对话时会自动加载,保证跨会话的连续感。你还可以为角色导入知识库、文档和人物生平类素材,系统会建立索引并用于检索增强生成,让回答更贴合角色背景与设定。
### 可选数字人视频
当你具备 GPU 资源并希望 Agent「可见」时,可开启 avatar inference:只需一张角色参考图,即可通过 FlashHead、LiveAct 等可配置后端驱动实时面部动画、口型同步,并在不说话时播放缓存的待机视频。没有 GPU 或暂时不需要视频时,关闭该能力即可退回纯语音 Agent,同一套角色与人设配置仍可继续使用。
### 插件化技术栈
大脑、声音、听觉、工具、记忆和面孔均为可替换模块。你可以通过 `cyberverse_config.yaml` 组合 omni 模型、LLM、TTS、ASR、Embedding、RAG、工具调用与 Avatar 后端,并在 Web UI 的 **`/settings`** 中配置不同厂商的 API Key 与服务端点,按场景自由切换供应商与模型组合。
## 快速开始
### 前置条件
- Node 18+
- Go 1.25(需安装:`protoc-gen-go`、`protoc-gen-go-grpc`)
- Conda
- Python 3.10+
- FFmpeg
> 纯语音会话不需要本地 Avatar GPU。运行成本取决于你配置的实时语音 / omni / LLM / TTS / ASR 服务提供商。
可用以下命令验证:
```bash
node --version
go version
protoc --version
ffmpeg -version
conda --version
```
### 第 1 步:克隆仓库
```bash
git clone https://github.com/dsd2077/CyberVerse.git
cd CyberVerse
```
### 第 2 步:创建 Python 环境
```bash
conda create -n cyberverse python=3.10
conda activate cyberverse
```
### 第 3 步:配置环境变量
```bash
cp infra/.env.example .env
```
编辑 `.env`,填入支持的API key:
aliyun Qwen系列模型
```env
DASHSCOPE_API_KEY=your_dashscope_api_key
```
或者火山引擎:Doubao系列模型:
```env
DOUBAO_ACCESS_TOKEN=your_doubao_access_token
DOUBAO_APP_ID=your_doubao_app_id
```
豆包语音:按照 [火山引擎快速入门](https://www.volcengine.com/docs/6561/2119699?lang=zh) 获取 **App ID** / **API Key**,并填入 `DOUBAO_APP_ID` / `DOUBAO_ACCESS_TOKEN`。
服务启动后,你也可以在 Web UI 的 **`/settings`** 页面修改 API Key 和服务端点,而不必只依赖编辑 `.env`。
### 第 4 步:创建本地配置并启用 voice-only 模式
```bash
cp infra/cyberverse_config.example.yaml cyberverse_config.yaml
```
编辑 `cyberverse_config.yaml`:
```yaml
inference:
avatar:
enabled: false
```
当 `enabled: false` 时,CyberVerse 会作为纯语音 Agent 助手运行。
### 第 5 步:安装项目依赖
```bash
make setup
```
这一步会安装基础可编辑包(`[dev,inference]`)、生成 gRPC stubs,并安装前端依赖。
安装默认配置所需的语音 Agent extras:
```bash
# 一次安装全部可选组
pip install -e ".[all]"
```
### 第 6 步:启动服务(3 个终端)
**终端 1** — Python 推理服务:
```bash
conda activate cyberverse
make inference
```
**终端 2** — Go API 服务:
```bash
make server
```
**终端 3** — 前端:
```bash
make frontend
```
### 第 7 步:验证
```bash
# 检查 API 健康状态
curl -s http://localhost:8080/api/v1/health
```
在浏览器中打开 http://localhost:5173。
## 可选:完整数字人视频模式
如果你希望用 FlashHead 或 LiveAct 驱动实时 Avatar 视频,请按如下步骤执行。
### 额外要求
- 支持 CUDA 12.8+ 的 GPU
- PyTorch 2.8(CUDA 12.8)
- FFmpeg(需包含 `libvpx`,用于视频编码)
- Avatar 模型权重
安装 PyTorch(CUDA 12.8):
```bash
pip3 install torch==2.8.0 torchvision==0.23.0 torchaudio==2.8.0 --index-url https://download.pytorch.org/whl/cu128
```
如果使用 LiveAct,安装 vllm:
```bash
pip install vllm==0.11.0
```
### 下载模型权重
CyberVerse 目前支持 **FlashHead** 与 **LiveAct**,按需下载即可;后续会继续接入更多模型。
```bash
pip install "huggingface_hub[cli]"
```
#### FlashHead(SoulX-FlashHead)
| 模型组件 | 说明 | 链接 |
| :--- | :--- | :--- |
| `SoulX-FlashHead-1_3B` | 1.3B FlashHead 权重 | [Hugging Face](https://huggingface.co/Soul-AILab/SoulX-FlashHead-1_3B), [ModelScope](https://modelscope.cn/models/Soul-AILab/SoulX-FlashHead-1_3B) |
| `wav2vec2-base-960h` | 音频特征提取器 | [Hugging Face](https://huggingface.co/facebook/wav2vec2-base-960h), [ModelScope](https://modelscope.cn/models/facebook/wav2vec2-base-960h) |
```bash
# 如果你在中国大陆,可以先使用镜像:
# export HF_ENDPOINT=https://hf-mirror.com
hf download Soul-AILab/SoulX-FlashHead-1_3B \
--local-dir ./checkpoints/SoulX-FlashHead-1_3B
hf download facebook/wav2vec2-base-960h \
--local-dir ./checkpoints/wav2vec2-base-960h
```
#### LiveAct(SoulX-LiveAct)
| 模型名称 | 下载 |
|-----------|----------|
| SoulX-LiveAct | [Hugging Face](https://huggingface.co/Soul-AILab/LiveAct), [ModelScope](https://modelscope.cn/models/Soul-AILab/LiveAct) |
| chinese-wav2vec2-base | [Hugging Face](https://huggingface.co/TencentGameMate/chinese-wav2vec2-base), [ModelScope](https://modelscope.cn/models/TencentGameMate/chinese-wav2vec2-base) |
```bash
hf download Soul-AILab/LiveAct \
--local-dir ./checkpoints/LiveAct
hf download TencentGameMate/chinese-wav2vec2-base \
--local-dir ./checkpoints/chinese-wav2vec2-base
```
### 配置 Avatar Inference
将 `enabled` 设为 `true`,并把模型路径改成你的本地 checkpoint 路径:
```yaml
inference:
avatar:
enabled: true
default: "flash_head" # 指定启动的数字人模型;若设为 live_act,请填写下方 live_act 配置
runtime:
cuda_visible_devices: 0 # 共享 GPU ID,例如多卡可写 0,1
world_size: 1 # 共享 GPU 数量,双卡时设为 2
flash_head:
checkpoint_dir: "./checkpoints/SoulX-FlashHead-1_3B" # ← 你的路径
wav2vec_dir: "./checkpoints/wav2vec2-base-960h" # ← 你的路径
model_type: "lite" # 如需更高画质可设为 "pro"(需要更多 GPU)
compile_model: true
compile_vae: true
dist_worker_main_thread: true
infer_params:
frame_num: 33
motion_frames_latent_num: 2
tgt_fps: 20
sample_rate: 16000
sample_shift: 5
color_correction_strength: 1.0
cached_audio_duration: 8
num_heads: 12
height: 512
width: 512
live_act:
ckpt_dir: "./checkpoints/LiveAct" # ← 你的路径
wav2vec_dir: "./checkpoints/chinese-wav2vec2-base" # ← 你的路径
seed: 42
fp8_gemm: true
fp4_gemm: false
compile_wan_model: false
compile_vae_decode: false
dist_worker_main_thread: true
default_prompt: "一个人在说话"
infer_params:
size: "320*480"
fps: 20
audio_cfg: 1.0
```
这些选项之后也可以在 Web UI 中调整。
### SageAttention 和 FlashAttention(可选)
```bash
# SageAttention(源码编译)
git clone https://github.com/thu-ml/SageAttention.git
cd SageAttention
export EXT_PARALLEL=4 NVCC_APPEND_FLAGS="--threads 8" MAX_JOBS=32 # Optional
python setup.py install
```
```bash
# FlashAttention(可选)
wget -O flash_attn-2.8.1+cu12torch2.8cxx11abiTRUE-cp312-cp312-linux_x86_64.whl \
"https://github.com/Dao-AILab/flash-attention/releases/download/v2.8.1/flash_attn-2.8.1%2Bcu12torch2.8cxx11abiTRUE-cp312-cp312-linux_x86_64.whl"
pip install flash_attn-2.8.1+cu12torch2.8cxx11abiTRUE-cp312-cp312-linux_x86_64.whl
```
### Avatar 硬件基准
实时数字人视频需要 GPU 加速。下表为 FlashHead 和 LiveAct Avatar 模型的性能基准:
| 模型 | 档位 | GPU | 数量 | 分辨率 | FPS | 实时运行? |
|-------|---------|-----|-------|------------|-----|------------|
| FlashHead 1.3B | Pro | RTX 5090 | 2 | 512×512 | 25+ | ✅ 是 |
| FlashHead 1.3B | Pro | RTX 5090 | 1 | 464x464 | 20 | ✅ 是 |
| FlashHead 1.3B | Pro | RTX PRO 6000 | 1 | 512×512 | 20 | ✅ 是 |
| FlashHead 1.3B | Pro | RTX 4090 | 1 | 512×512 | ~10.8 | ❌ 否 |
| FlashHead 1.3B | Lite | RTX 4090 | 1 | 512×512 | 25+ | ✅ 是 |
| LiveAct 18B | — | RTX PRO 6000 | 2 | 320×480 | 20 | ✅ 是 |
| LiveAct 18B | — | RTX PRO 6000 | 1 | 256×417 | 20 | ✅ 是 |
> **Pro** 偏重画质;**Lite** 偏重速度。表中配置体现画质与算力的大致平衡:算力更充裕时可进一步提高画质;算力不足时请降低画质相关选项(分辨率、Pro / Lite 档位等)以保持实时流畅。
Avatar inference 启用后,`make inference` 会读取 `cyberverse_config.yaml` 中的 `inference.avatar.default`,并且只在当前推理进程中初始化该一个 Avatar 模型。等待日志中出现:
- `Active avatar model initialized: `
- `CyberVerse Inference Server started on port 50051`
## 远程访问说明
当 `streaming_mode: direct` 且使用内嵌 TURN 时,浏览器必须能够访问服务端的 `8443/TCP`。如果页面可以打开,但音视频始终无法建立连接,或者服务端日志中出现 `ICE connection state: failed`、`publish timeout waiting for connection`,请先在本机检查与服务器 `8443` 端口是否连通:
```bash
nc -vz 8443
```
如果 `8443` 不可达,通常是云安全组、防火墙或 NAT 限制导致。此时可以通过 SSH 隧道将本机 `8443` 转发到服务器:
```bash
ssh -L 8443:127.0.0.1:8443 user@host -p port
```
建立隧道后,浏览器会通过本机 `127.0.0.1:8443` 转发访问远端 TURN 服务。
如果你不是通过 SSH 隧道访问,而是希望浏览器直接连接远端服务器,请将 `cyberverse_config.yaml` 中的 `pipeline.ice_public_ip` 设置为服务器的公网 IP 或域名;如果使用 SSH 隧道,可以保持默认值(`127.0.0.1`)。
## 路线图
### 1. **实时音视频 Agent 平台**
让语音优先的实时 Agent 更容易运行、定制和嵌入。
- [x] 支持角色 CRUD,包含多张参考图、激活图、固定/随机展示模式、可选人脸裁剪、标签、声音字段、人格设定、欢迎语和系统提示词
- [x] 基于 WebRTC 的实时语音会话,支持直连 P2P(内嵌 TURN)或 LiveKit SFU
- [x] 支持通过 `inference.avatar.enabled: false` 启动纯语音会话
- [x] 所有模块以插件化方式提供(omni model、LLM、TTS、ASR、Embedding、RAG、avatar),支持通过 YAML 和 UI settings 配置不同厂商的 API Key
- [x] 会话管理,按角色将会话历史持久化到磁盘,并在启动对话时加载历史聊天记录
- [x] 声音克隆:支持豆包语音克隆声音
- [x] 支持语音和文本混合输入
- [x] 支持对话过程中的语音打断与会话中断/恢复
- [x] standard 模式和受支持的 omni 会话支持用户摄像头输入和屏幕共享视觉帧
- [x] PersonaAgent 与后台 SubAgent 任务执行
- [x] 支持知识、文档及人物生平类素材导入,用于面向角色的 RAG 问答
- [ ] 面向开发者的网站嵌入(Web 组件或 SDK),便于将自部署实例接入自有站点
- [ ] 支持面向直播的音视频推流
### 2. **实时数字人通话**
当具备 Avatar GPU 资源时,把语音 Agent 变成实时视频通话。
- [x] 基于参考图,通过可配置 Avatar 插件(例如 FlashHead、LiveAct)驱动实时头像视频
- [x] 支持角色待机视频缓存播放
- [x] 支持实时说话片段的音视频同步
- [ ] 增加更多具有不同画质、延迟和成本取舍的 Avatar 后端
- [ ] 为消费级 GPU、工作站 GPU 和云 GPU 提供更好的 Avatar 部署配置
### 3. **智能体网络**
连接多个智能体,让它们能够沟通、协作,并逐步形成网络。
- [ ] 支持 agent-to-agent 通信
- [ ] 支持多智能体协作与委派
- [ ] 支持智能体之间共享记忆与知识
- [ ] 构建开放的智能体互联网络
## 社区交流

如果二维码过期,可添加本人微信:wx_dsd2077,并备注 CyberVerse,我会邀请您进群
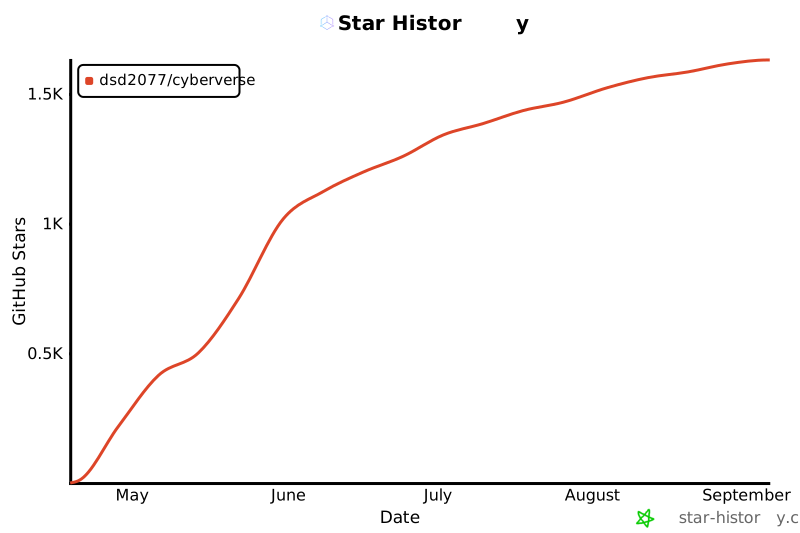
## 星标历史
## 许可证
GNU General Public License v3.0,详见 [LICENSE](LICENSE)。
## 致谢
- [SoulX-FlashHead](https://github.com/Soul-AILab/SoulX-FlashHead) — Soul AI Lab 提供的 Avatar 模型
- [SoulX-LiveAct](https://github.com/Soul-AILab/SoulX-LiveAct) - Soul AI Lab 提供的 Avatar 模型
- [Pion](https://github.com/pion/webrtc) — Go WebRTC 实现
- [Linux.do](https://linux.do/)