# deer-flow
**Repository Path**: framework-learning-notes/deer-flow
## Basic Information
- **Project Name**: deer-flow
- **Description**: An open-source long-horizon SuperAgent harness that researches, codes, and creates. With the help of sandboxes, memories, tools, skill, subagents and message gateway, it handles different levels of tasks that could take minutes to hours.
- **Primary Language**: Unknown
- **License**: MIT
- **Default Branch**: main
- **Homepage**: None
- **GVP Project**: No
## Statistics
- **Stars**: 0
- **Forks**: 0
- **Created**: 2026-10-10
- **Last Updated**: 2026-10-10
## Categories & Tags
**Categories**: Uncategorized
**Tags**: None
## README
# 🦌 DeerFlow - 2.0
[English](./README.md) | 中文 | [日本語](./README_ja.md) | [Français](./README_fr.md) | [Русский](./README_ru.md) | [Português](./README_pt.md)
[](./backend/pyproject.toml)
[](./Makefile)
[](./LICENSE)
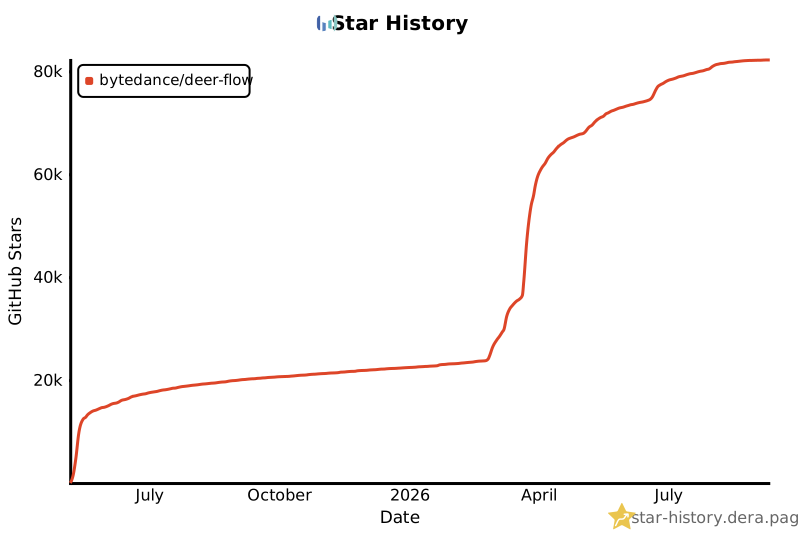
 > 2026 年 2 月 28 日,DeerFlow 2 发布后登上 GitHub Trending 第 1 名。非常感谢社区的支持,这是大家一起做到的。
DeerFlow(**D**eep **E**xploration and **E**fficient **R**esearch **Flow**)是一个开源的 **super agent harness**。它把 **sub-agents**、**memory** 和 **sandbox** 组织在一起,再配合可扩展的 **skills**,让 agent 可以完成几乎任何事情。
https://github.com/user-attachments/assets/a8bcadc4-e040-4cf2-8fda-dd768b999c18
> [!NOTE]
> **DeerFlow 2.0 是一次彻底重写。** 它和 v1 没有共用代码。如果你要找的是最初的 Deep Research 框架,可以前往 [`1.x` 分支](https://github.com/bytedance/deer-flow/tree/main-1.x)。那里仍然欢迎贡献;当前的主要开发已经转向 2.0。
## 官网
想了解更多,或者直接看**真实演示**,可以访问[**官网**](https://deerflow.tech)。
## 姐妹项目
 - [**LLM Space**](https://github.com/deer-flow/llm-space) - 认识 DeerFlow 背后的秘密武器——一款桌面工具,用于原型化 agent 想法、检查 harness 的每个步骤、回放失败用例并基准测试性能。
## 字节跳动火山引擎方舟 Coding Plan
- 我们推荐使用 Doubao-Seed-2.0-Code、DeepSeek v3.2 和 Kimi 2.5 运行 DeerFlow
- [现在就加入 Coding Plan](https://www.volcengine.com/activity/codingplan?utm_campaign=deer_flow&utm_content=deer_flow&utm_medium=devrel&utm_source=OWO&utm_term=deer_flow)
- [海外地区的开发者请点击这里](https://www.byteplus.com/en/activity/codingplan?utm_campaign=deer_flow&utm_content=deer_flow&utm_medium=devrel&utm_source=OWO&utm_term=deer_flow)
## InfoQuest
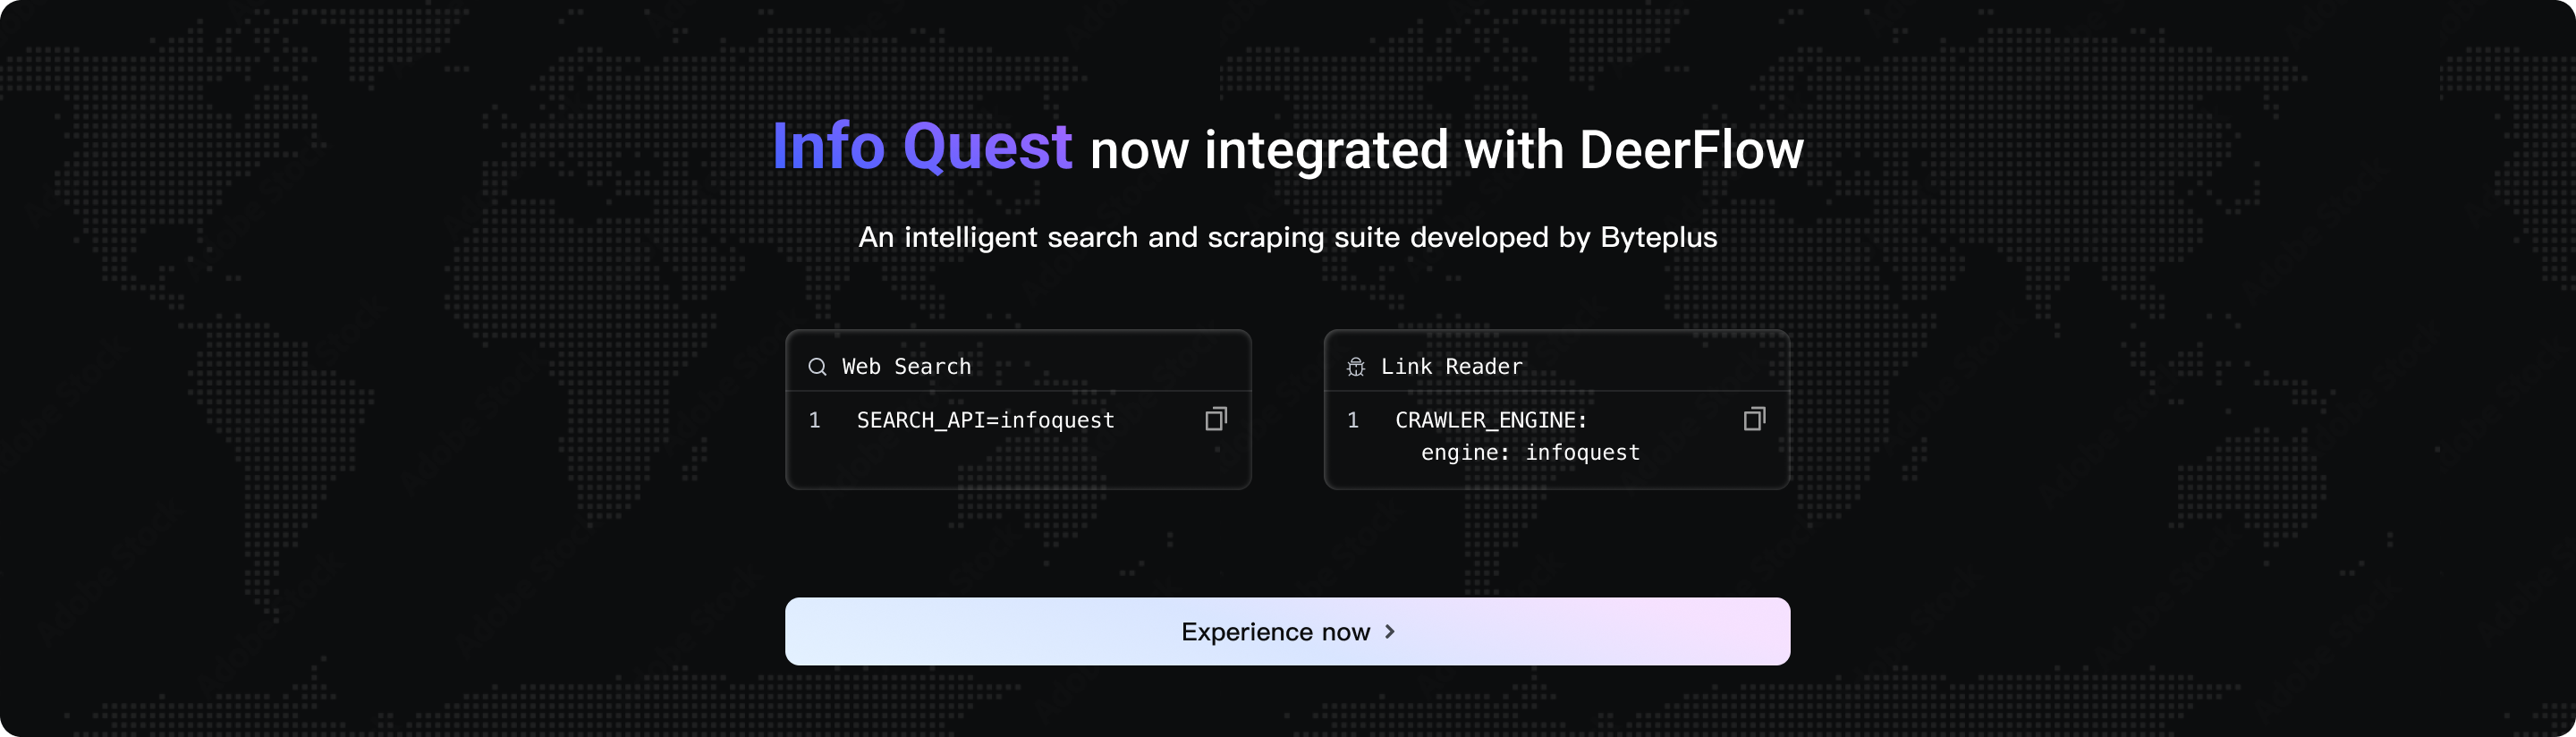
DeerFlow 新近集成了 BytePlus 自研的智能搜索与抓取工具集——[InfoQuest(支持免费在线体验)](https://docs.byteplus.com/en/docs/InfoQuest/What_is_Info_Quest)
 ## 目录
- [🦌 DeerFlow - 2.0](#-deerflow---20)
- [官网](#官网)
- [字节跳动火山引擎方舟 Coding Plan](#字节跳动火山引擎方舟-coding-plan)
- [InfoQuest](#infoquest)
- [目录](#目录)
- [一句话交给 Coding Agent 安装](#一句话交给-coding-agent-安装)
- [快速开始](#快速开始)
- [配置](#配置)
- [运行应用](#运行应用)
- [部署建议与资源规划](#部署建议与资源规划)
- [方式一:Docker(推荐)](#方式一docker推荐)
- [升级已有的代码仓库](#升级已有的代码仓库)
- [方式二:本地开发](#方式二本地开发)
- [进阶配置](#进阶配置)
- [Sandbox 模式](#sandbox-模式)
- [MCP Server](#mcp-server)
- [IM 渠道](#im-渠道)
- [LangSmith 链路追踪](#langsmith-链路追踪)
- [Langfuse 链路追踪](#langfuse-链路追踪)
- [同时使用两种追踪服务](#同时使用两种追踪服务)
- [从 Deep Research 到 Super Agent Harness](#从-deep-research-到-super-agent-harness)
- [核心特性](#核心特性)
- [Skills 与 Tools](#skills-与-tools)
- [Claude Code 集成](#claude-code-集成)
- [Session Goals](#session-goals)
- [手动上下文压缩](#手动上下文压缩)
- [Sub-Agents](#sub-agents)
- [Sandbox 与文件系统](#sandbox-与文件系统)
- [Agentic Browser Control](#agentic-browser-control)
- [Context Engineering](#context-engineering)
- [当前任务笔记](#当前任务笔记)
- [长期记忆](#长期记忆)
- [推荐模型](#推荐模型)
- [内嵌 Python Client](#内嵌-python-client)
- [项目 (Projects)](#项目-projects)
- [定时任务 (Scheduled Tasks)](#定时任务-scheduled-tasks)
- [升级说明](#升级说明)
- [终端工作台 (TUI)](#终端工作台-tui)
- [文档](#文档)
- [⚠️ 安全使用](#️-安全使用)
- [参与贡献](#参与贡献)
- [许可证](#许可证)
- [致谢](#致谢)
- [核心贡献者](#核心贡献者)
- [Star History](#star-history)
## 一句话交给 Coding Agent 安装
如果你在用 Claude Code、Codex、Cursor、Windsurf 或其他 coding agent,可以直接把下面这句话发给它:
```text
如果还没 clone DeerFlow,就先 clone,然后按照 https://raw.githubusercontent.com/bytedance/deer-flow/main/Install.md 把它的本地开发环境初始化好
```
这条提示词是给 coding agent 用的。它会在需要时先 clone 仓库,优先选择 Docker,完成初始化,并在结束时告诉你下一条启动命令,以及还缺哪些配置需要你补充。
## 快速开始
### 配置
1. **克隆 DeerFlow 仓库**
```bash
git clone https://github.com/bytedance/deer-flow.git
cd deer-flow
```
2. **运行安装向导(推荐)**
在项目根目录(`deer-flow/`)执行:
```bash
make setup
```
这会启动一个交互式向导,引导你选择 LLM provider、可选的 web 搜索工具,以及 sandbox 模式、bash 权限、文件写入等执行/安全偏好。它会生成一份最小化的 `config.yaml`,并把 API key 写入 `.env`,大约 2 分钟完成。
随时可以运行 `make doctor` 检查配置和系统环境,并获得可执行的修复建议。
如果你要提交本地安装、配置或运行问题,可以执行 `make support-bundle`。
命令会直接打印 reporter 下一步建议,并在 `.deer-flow/support-bundles/` 下生成
`*-issue-summary.md`、面向 AI 辅助提 issue 的 `*-issue-draft.md`,以及可选证据
zip。提交 GitHub issue 时,先把 `*-issue-summary.md` 粘贴到 issue 正文;如果由
AI 助手代填 issue,就从 `*-issue-draft.md` 开始,并先替换所有 REQUIRED 占位符,
不要编造未知事实。只有维护者要求证据包,或摘要不足以诊断时,再附上 zip。维护者
或 AI 辅助 triage 可以优先读取 `triage.json`;bundle 只包含脱敏后的诊断信息和
文件 manifest,不包含 `.env`、原始对话消息或用户文件内容;提交前仍建议自己快速
检查一遍。
> **进阶 / 手动配置**:如果你更想直接编辑 `config.yaml`,可以改用 `make config` 复制完整的示例模板。完整参考见 `config.example.yaml`,其中包含 CLI-backed provider(Codex CLI、Claude Code OAuth)、OpenRouter、Responses API 等更多配置。
手动模型配置示例
```yaml
models:
- name: gpt-4o
display_name: GPT-4o
use: langchain_openai:ChatOpenAI
model: gpt-4o
api_key: $OPENAI_API_KEY
- name: openrouter-gemini-2.5-flash
display_name: Gemini 2.5 Flash (OpenRouter)
use: langchain_openai:ChatOpenAI
model: google/gemini-2.5-flash-preview
api_key: $OPENROUTER_API_KEY
base_url: https://openrouter.ai/api/v1
- name: opper-claude-sonnet-4-6
display_name: Claude Sonnet 4.6 (Opper)
use: langchain_openai:ChatOpenAI
model: claude-sonnet-4-6
api_key: $OPPER_API_KEY
base_url: https://api.opper.ai/v3/compat
- name: gpt-5-responses
display_name: GPT-5 (Responses API)
use: langchain_openai:ChatOpenAI
model: gpt-5
api_key: $OPENAI_API_KEY
use_responses_api: true
output_version: responses/v1
- name: qwen3-32b-vllm
display_name: Qwen3 32B (vLLM)
use: deerflow.models.vllm_provider:VllmChatModel
model: Qwen/Qwen3-32B
api_key: $VLLM_API_KEY
base_url: http://localhost:8000/v1
supports_thinking: true
when_thinking_enabled:
extra_body:
chat_template_kwargs:
enable_thinking: true
```
OpenRouter 以及类似的 OpenAI 兼容网关,建议通过 `langchain_openai:ChatOpenAI` 配合 `base_url` 来配置。如果你更想用 provider 自己的环境变量名,也可以直接把 `api_key` 指向对应变量,例如 `api_key: $OPENROUTER_API_KEY`。
如果要让 OpenAI 模型走 `/v1/responses`,继续使用 `langchain_openai:ChatOpenAI`,并设置 `use_responses_api: true` 和 `output_version: responses/v1`。
如果某个模型的 provider 约定与 DeerFlow 通用的 thinking/effort 假设不同,可以为该模型声明 `reasoning:` 块(thinking 为 `unsupported`/`optional`/`required`、允许的 effort 取值及别名和默认值、payload 方言、推理历史要求)。Setup Wizard 内置的 Z.AI GLM-5.3-Flash 配置就使用了它:前台和后台调用都会保持 thinking 开启,effort 选择器只提供该模型自己的 `low`/`high`/`max` 档位。未声明该块的配置行为保持不变。具体格式与等价的手动配置见 `config.example.yaml`。
对于 vLLM 0.19.0,请使用 `deerflow.models.vllm_provider:VllmChatModel`。对于 Qwen 风格的推理模型,DeerFlow 通过 `extra_body.chat_template_kwargs.enable_thinking` 开关推理,并在多轮 tool-call 对话中保留 vLLM 非标准的 `reasoning` 字段。旧版 `thinking` 配置会自动规范化以保持向后兼容。推理模型可能还需要在启动 vLLM 服务时加上 `--reasoning-parser ...` 参数。如果你的本地 vLLM 部署接受任意非空 API key,可以把 `VLLM_API_KEY` 设为一个占位值。
CLI-backed provider 配置示例:
```yaml
models:
- name: gpt-5.4
display_name: GPT-5.4 (Codex CLI)
use: deerflow.models.openai_codex_provider:CodexChatModel
model: gpt-5.4
supports_thinking: true
supports_reasoning_effort: true
- name: claude-sonnet-4.6
display_name: Claude Sonnet 4.6 (Claude Code OAuth)
use: deerflow.models.claude_provider:ClaudeChatModel
model: claude-sonnet-4-6
max_tokens: 4096
supports_thinking: true
```
- Codex CLI 会读取 `~/.codex/auth.json`
- Claude Code 支持 `CLAUDE_CODE_OAUTH_TOKEN`、`ANTHROPIC_AUTH_TOKEN`、`CLAUDE_CODE_CREDENTIALS_PATH`,或 `~/.claude/.credentials.json`
- ACP agent 条目与 model provider 是分开配置的——如果你配置了 `acp_agents.codex`,请把它指向一个 Codex ACP 适配器,例如 `npx -y @zed-industries/codex-acp`
- MiniMax Code 原生支持 ACP,不需要额外适配器。先安装并登录,再把它配置成 ACP agent:
```bash
npm install --global @minimax-ai/code
mcode login
```
```yaml
acp_agents:
mcode:
command: mcode
args: ["acp"]
description: MiniMax Code for implementation, refactoring, debugging, and repository tasks
auto_approve_permissions: false
```
`mcode` 必须位于 Gateway 进程的 `PATH` 中;只安装在 Docker host 上并不会让 Gateway 容器内可用。DeerFlow 会通过 `invoke_acp_agent` 在每个 thread 独立的 ACP workspace 中调用 MCode,并转发已启用的 MCP server。处理不可信任务时请保持 `auto_approve_permissions: false`;只有在任务可信且确实需要 MCode 修改文件或执行命令时才启用它。
- 在 macOS 上,如有需要可显式导出 Claude Code 的认证信息:
```bash
eval "$(python3 scripts/export_claude_code_oauth.py --print-export)"
```
API key 也可以手动写入 `.env` 文件(推荐)或在 shell 中导出:
```bash
OPENAI_API_KEY=your-openai-api-key
TAVILY_API_KEY=your-tavily-api-key
```
### 运行应用
#### 部署建议与资源规划
可以先按下面的资源档位来选择 DeerFlow 的运行方式:
| 部署场景 | 起步配置 | 推荐配置 | 说明 |
|---------|-----------|------------|-------|
| 本地体验 / `make dev` | 4 vCPU、8 GB 内存、20 GB SSD 可用空间 | 8 vCPU、16 GB 内存 | 适合单个开发者或单个轻量会话,且模型走外部 API。`2 核 / 4 GB` 通常跑不稳。 |
| Docker 开发 / `make docker-start` | 4 vCPU、8 GB 内存、25 GB SSD 可用空间 | 8 vCPU、16 GB 内存 | 镜像构建、源码挂载和 sandbox 容器都会比纯本地模式更吃资源。 |
| 长期运行服务 / `make up` | 8 vCPU、16 GB 内存、40 GB SSD 可用空间 | 16 vCPU、32 GB 内存 | 更适合共享环境、多 agent 任务、报告生成或更重的 sandbox 负载。 |
- 上面的配置只覆盖 DeerFlow 本身;如果你还要本机部署本地大模型,请单独为模型服务预留资源。
- 持续运行的服务更推荐使用 Linux + Docker。macOS 和 Windows 更适合作为开发机或体验环境。
- 如果 CPU 或内存长期打满,先降低并发会话或重任务数量,再考虑升级到更高一档配置。
#### 方式一:Docker(推荐)
需要 Docker Desktop / Docker Engine,以及 **Docker Compose v2.24+**
(`docker compose version`)。更旧的 Compose 客户端无法解析
`docker/docker-compose.yaml` 与 `docker/docker-compose-dev.yaml` 里的可选 `env_file` 语法。
**开发模式**(支持热更新,挂载源码):
```bash
make docker-init # 拉取 sandbox 镜像(首次运行或镜像更新时执行)
make docker-start # 启动服务(会根据 config.yaml 自动判断 sandbox 模式)
```
如果 `config.yaml` 使用的是 provisioner 模式(`sandbox.use: deerflow.community.aio_sandbox:AioSandboxProvider` 且配置了 `provisioner_url`),`make docker-start` 才会启动 `provisioner`。
**生产模式**(本地构建镜像,并挂载运行期配置与数据):
```bash
make up # 构建镜像并启动全部生产服务
make down # 停止并移除容器
```
> [!NOTE]
> 当前 Agent 运行时嵌入在 Gateway 中运行,`/api/langgraph/*` 会由 nginx 重写到 Gateway 的 LangGraph-compatible API。
访问地址:http://localhost:2026
更完整的 Docker 开发说明见 [CONTRIBUTING.md](CONTRIBUTING.md)。
#### 升级已有的代码仓库
保留现有的 `config.yaml`、`.env` 和 `extensions_config.json`。停止当前运行的服务后,
执行 `git pull --ff-only`,再按原运行方式启动。日常源码升级不需要再次运行 `make config`
或 `make docker-init`;如果新版本需要变更配置,请在重启前运行 `make config-upgrade`。
各运行方式的命令见[运维与排障](frontend/src/content/zh/application/operations-and-troubleshooting.mdx#升级已有的代码仓库)。
#### 方式二:本地开发
如果你更希望直接在本地启动各个服务:
前提:先完成上面的“配置”步骤(`make setup`)。`make dev` 需要有效配置文件,默认读取项目根目录下的 `config.yaml`。可以用 `DEER_FLOW_PROJECT_ROOT` 显式指定项目根目录,也可以用 `DEER_FLOW_CONFIG_PATH` 指向某个具体配置文件。运行期状态默认写到项目根目录下的 `.deer-flow`,可用 `DEER_FLOW_HOME` 覆盖;skills 默认读取项目根目录下的 `skills/`,可用 `DEER_FLOW_SKILLS_PATH` 覆盖。启动前先运行 `make doctor` 校验配置。
在 Windows 上,请使用 Git Bash 运行本地开发流程。基于 bash 的服务脚本不支持直接在原生 `cmd.exe` 或 PowerShell 中执行,且 WSL 也不保证可用,因为部分脚本依赖 Git for Windows 的 `cygpath` 等工具。
1. **检查依赖环境**:
```bash
make check # 校验 Node.js 22+、pnpm、uv、nginx
```
2. **安装依赖**:
```bash
make install # 安装 backend + frontend 依赖
```
pre-commit 由 uv 调用,不要求其工具目录在 `PATH` 中。
3. **(可选)预拉取 sandbox 镜像**:
```bash
# 如果使用 Docker / Container sandbox,建议先执行
make setup-sandbox
```
4. **启动服务**:
```bash
make dev
```
5. **访问地址**:http://localhost:2026
#### 启动模式
DeerFlow 将 Agent 运行时内嵌在 Gateway API 中运行。开发模式支持热更新;生产模式使用预构建的前端。
| | **本地前台** | **本地守护进程** | **Docker 开发** | **Docker 生产** |
|---|---|---|---|---|
| **开发模式** | `./scripts/serve.sh --dev`
`make dev` | `./scripts/serve.sh --dev --daemon`
`make dev-daemon` | `./scripts/docker.sh start`
`make docker-start` | — |
| **生产模式** | `./scripts/serve.sh --prod`
`make start` | `./scripts/serve.sh --prod --daemon`
`make start-daemon` | — | `./scripts/deploy.sh`
`make up` |
| 操作 | 本地 | Docker 开发 | Docker 生产 |
|---|---|---|---|
| **停止** | `./scripts/serve.sh --stop`
`make stop` | `./scripts/docker.sh stop`
`make docker-stop` | `./scripts/deploy.sh down`
`make down` |
| **重启** | `./scripts/serve.sh --restart [flags]` | `./scripts/docker.sh restart` | — |
`make start` 与 `make start-daemon` 每次运行都会用 `next build` 重新构建前端。如需复用上一次的构建结果,可传入 `SKIP_FRONTEND_BUILD=1`(或在直接调用 `./scripts/serve.sh --prod` 时附加 `--skip-frontend-build`)。该选项为可选行为:当 `frontend/.next` 中没有已完成的构建时会快速失败。
#### LangGraph Studio(可选)
默认的 `make dev` 拓扑使用 DeerFlow 内嵌于 Gateway 的运行时,无需 LangGraph Studio。
如需用独立开发服务器检查和测试已注册的 lead-agent 图,请在 `backend/` 目录下运行
以下命令,以便 CLI 发现 `langgraph.json`:
```bash
cd backend
uv run langgraph dev --allow-blocking
```
该命令会打印本地 API 与 Studio UI 地址。这个内存态服务器仅用于开发与测试;
该标志允许 DeerFlow 在处理本地 Studio 请求时执行同步的配置加载与图工厂初始化,
不能当作生产服务器设置使用。本地 Studio 的认证会自动处理,连接无需自定义请求头。
生产负载请使用 DeerFlow 文档中的生产启动模式或受支持的 LangSmith 部署。在这种
独立模式下,assistant 的归属与来源由服务器管理:Studio 可以发现已注册的图及其
创建的 assistants,正常的 assistant 版本选择依然可用。在锁定态本地运行时加载其
持久化开发存储之前,DeerFlow 会修复历史遗留的 assistant 行与版本历史,防止历史
客户端元数据恢复服务器权限,或被运行时的启动清理流程丢弃。请用 `uv sync` 保持
后端依赖同步;该兼容路径依赖已声明的 LangGraph 运行时版本,若持久化存储契约
与预期不再匹配会记录警告。文档中的命令使用 LangGraph 基于文件的自定义应用加载器,
DeerFlow 的回归测试也直接覆盖了它。
对通过 LangGraph Studio 或直连 LangGraph Server 调用 `backend/langgraph.json`
的工作流,DeerFlow 会消费该运行时发布的已认证身份,并将其用于 custom-agent
配置/SOUL、用户技能与技能策略、上传、线程数据以及记忆读写。这使经过认证的运行
不会落入共享的 `default` 文件系统桶,且服务器管理的身份优先于普通客户端提供的
`user_id` 值。诸如邮箱地址之类的外部身份会在访问 DeerFlow 存储前,被映射为稳定、
抗碰撞且目录安全的用户 ID。默认的 DeerFlow 服务拓扑仍是上文描述的 Gateway 内嵌
运行时。
Gateway 运行时会自动强制对 `/mnt/user-data/outputs` 下创建或修改的产物执行原生交付:`present_files` 必须至少展示一个由当前运行产出的输出,且终止时的 `run.delivery` 回执必须被持久化记录。虚拟产物路径会在产出该输出的同一已认证用户与线程范围内解析,然后再校验输出目录边界。未产出产物文件的运行保持普通对话行为。
DeerFlow 的内置自定义事件同时通过两种 LangGraph 流式接口提供:原生客户端可以继续订阅 `stream_mode="custom"`,基于回调的集成则可以从 `astream_events(version="v2")` 以 `on_custom_event` 记录的形式消费相同载荷。回调事件名与载荷的 `type` 字段一致。
### 进阶配置
#### Sandbox 模式
DeerFlow 支持多种 sandbox 执行方式:
- **本地执行**(直接在宿主机上运行 sandbox 代码)
- **Docker 执行**(在隔离的 Docker 容器里运行 sandbox 代码)
- **Docker + Kubernetes 执行**(通过 provisioner 服务在 Kubernetes Pod 中运行 sandbox 代码)
Docker 开发时,服务启动行为会遵循 `config.yaml` 里的 sandbox 模式。在 Local / Docker 模式下,不会启动 `provisioner`。
如果要配置你自己的模式,参见 [Sandbox 配置指南](backend/docs/CONFIGURATION.md#sandbox)。
#### MCP Server
DeerFlow 支持可配置的 MCP Server 和 skills,用来扩展能力。
对于 HTTP/SSE MCP Server,还支持 OAuth token 流程(`client_credentials`、`refresh_token`)。
详细说明见 [MCP Server 指南](backend/docs/MCP_SERVER.md)。
#### IM 渠道
DeerFlow 支持从即时通讯应用接收任务。只要配置完成,对应渠道会自动启动,而且都不需要公网 IP。
DeerFlow 还可以在 workspace UI 里暴露用户自有的 IM 渠道连接。启用 `channel_connections` 后,已登录用户可以从侧边栏 / Settings > Channels 绑定 Telegram、Slack、Discord、Feishu/Lark、DingTalk、WeChat、WeCom、QQ 或 Buzz。它复用现有的 `channels.*` 出站传输,因此不需要公网 IP 或 provider 回调地址。入站 IM 消息会以所连接的 DeerFlow 用户身份运行。设置和安全注意事项参见 [IM Channel Connections](backend/docs/IM_CHANNEL_CONNECTIONS.md)。
| 渠道 | 传输方式 | 上手难度 |
|---------|-----------|------------|
| Telegram | Bot API(long-polling) | 简单 |
| Slack | Socket Mode | 中等 |
| Feishu / Lark | WebSocket | 中等 |
| WeChat | Tencent iLink(long-polling) | 中等 |
| 企业微信智能机器人 | WebSocket | 中等 |
| 钉钉 | Stream Push(WebSocket) | 中等 |
| QQ | WebSocket(仅文本私聊及群 @;每条来源消息最多回复 4 / 5 条) | 中等 |
| Buzz | Nostr relay(WebSocket,NIP-42) | 中等 |
**`config.yaml` 中的配置示例:**
```yaml
channels:
# LangGraph-compatible Gateway API base URL(默认:http://localhost:8001/api)
langgraph_url: http://localhost:8001/api
# Gateway API URL(默认:http://localhost:8001)
gateway_url: http://localhost:8001
# 可选:所有移动端渠道共用的全局 session 默认值
session:
assistant_id: lead_agent # 也可以填自定义 agent 名;渠道层会自动转换为 lead_agent + agent_name
config:
recursion_limit: 100
context:
thinking_enabled: true
is_plan_mode: false
subagent_enabled: false
feishu:
enabled: true
app_id: $FEISHU_APP_ID
app_secret: $FEISHU_APP_SECRET
# domain: https://open.feishu.cn # 国内版(默认)
# domain: https://open.larksuite.com # 国际版
wecom:
enabled: true
bot_id: $WECOM_BOT_ID
bot_secret: $WECOM_BOT_SECRET
slack:
enabled: true
bot_token: $SLACK_BOT_TOKEN # xoxb-...
app_token: $SLACK_APP_TOKEN # xapp-...(Socket Mode)
allowed_users: [] # 留空表示允许所有人
telegram:
enabled: true
bot_token: $TELEGRAM_BOT_TOKEN
allowed_users: [] # 填数字用户 ID,不是 @用户名;留空表示允许所有人
# 可选:按渠道 / 按用户单独覆盖 session 配置
session:
assistant_id: mobile-agent # 这里同样支持自定义 agent 名
context:
thinking_enabled: false
users:
"123456789":
assistant_id: vip-agent
config:
recursion_limit: 150
context:
thinking_enabled: true
subagent_enabled: true
wechat:
enabled: false
bot_token: $WECHAT_BOT_TOKEN
ilink_bot_id: $WECHAT_ILINK_BOT_ID
qrcode_login_enabled: true # 可选:bot_token 缺失时允许首次扫码登录引导
allowed_users: [] # 留空表示允许所有人
polling_timeout: 35
state_dir: ./.deer-flow/wechat/state
max_inbound_image_bytes: 20971520
max_outbound_image_bytes: 20971520
max_inbound_file_bytes: 52428800
max_outbound_file_bytes: 52428800
dingtalk:
enabled: true
client_id: $DINGTALK_CLIENT_ID # 钉钉开放平台 ClientId
client_secret: $DINGTALK_CLIENT_SECRET # 钉钉开放平台 ClientSecret
allowed_users: [] # 留空表示允许所有人
card_template_id: "" # 可选:AI 卡片模板 ID,用于流式打字机效果
```
说明:
- `assistant_id: lead_agent` 会直接调用默认的 LangGraph assistant。
- 如果 `assistant_id` 填的是自定义 agent 名,DeerFlow 仍然会走 `lead_agent`,同时把该值注入为 `agent_name`,这样 IM 渠道也会生效对应 agent 的 SOUL 和配置。
在 `.env` 里设置对应的 API key:
```bash
# Telegram
TELEGRAM_BOT_TOKEN=123456789:ABCdefGHIjklMNOpqrSTUvwxYZ
# Slack
SLACK_BOT_TOKEN=xoxb-...
SLACK_APP_TOKEN=xapp-...
# Feishu / Lark
FEISHU_APP_ID=cli_xxxx
FEISHU_APP_SECRET=your_app_secret
# WeChat iLink
WECHAT_BOT_TOKEN=your_ilink_bot_token
WECHAT_ILINK_BOT_ID=your_ilink_bot_id
# 企业微信智能机器人
WECOM_BOT_ID=your_bot_id
WECOM_BOT_SECRET=your_bot_secret
# 钉钉
DINGTALK_CLIENT_ID=your_client_id
DINGTALK_CLIENT_SECRET=your_client_secret
```
**Telegram 配置**
1. 打开 [@BotFather](https://t.me/BotFather),发送 `/newbot`,复制生成的 HTTP API token。
2. 在 `.env` 中设置 `TELEGRAM_BOT_TOKEN`,并在 `config.yaml` 里启用该渠道。
3. 机器人支持接收入站文本、图片和文档(可带说明文字,也可不带);托管版 Bot API 的单个附件下载上限为 20 MB。
**Slack 配置**
1. 前往 [api.slack.com/apps](https://api.slack.com/apps) 创建 Slack App:Create New App → From scratch。
2. 在 **OAuth & Permissions** 中添加 Bot Token Scopes:`app_mentions:read`、`chat:write`、`im:history`、`im:read`、`im:write`、`files:write`。
3. 启用 **Socket Mode**,生成带 `connections:write` 权限的 App-Level Token(`xapp-...`)。
4. 在 **Event Subscriptions** 中订阅 bot events:`app_mention`、`message.im`。
5. 在 `.env` 中设置 `SLACK_BOT_TOKEN` 和 `SLACK_APP_TOKEN`,并在 `config.yaml` 中启用该渠道。
**Feishu / Lark 配置**
1. 在 [飞书开放平台](https://open.feishu.cn/) 创建应用,并启用 **Bot** 能力。
2. 添加权限:`im:message`、`im:message.p2p_msg:readonly`、`im:resource`。
3. 在 **事件订阅** 中订阅 `im.message.receive_v1`,连接方式选择 **长连接**。
4. 复制 App ID 和 App Secret,在 `.env` 中设置 `FEISHU_APP_ID` 和 `FEISHU_APP_SECRET`,并在 `config.yaml` 中启用该渠道。
**WeChat 配置**
1. 在 `config.yaml` 中启用 `wechat` 渠道。
2. 在 `.env` 中设置 `WECHAT_BOT_TOKEN`,或者把 `qrcode_login_enabled` 设为 `true` 以便首次扫码登录引导。
3. 当 `bot_token` 缺失且启用了扫码引导时,留意后端日志里 iLink 返回的二维码内容,并完成绑定流程。
4. 扫码流程成功后,DeerFlow 会把获取到的 token 持久化到 `state_dir`,便于后续重启复用。
5. Docker Compose 部署时,请把 `state_dir` 放在持久化卷上,这样 `get_updates_buf` 游标和已保存的登录状态才能在重启后保留。
**企业微信智能机器人配置**
1. 在企业微信智能机器人平台创建机器人,获取 `bot_id` 和 `bot_secret`。
2. 在 `config.yaml` 中启用 `channels.wecom`,并填入 `bot_id` / `bot_secret`。
3. 在 `.env` 中设置 `WECOM_BOT_ID` 和 `WECOM_BOT_SECRET`。
4. 安装后端依赖时确保包含 `wecom-aibot-python-sdk`,渠道会通过 WebSocket 长连接接收消息,无需公网回调地址。
5. 当前支持文本、图片和文件入站消息;agent 生成的最终图片/文件也会回传到企业微信会话中。
**钉钉配置**
1. 在 [钉钉开放平台](https://open.dingtalk.com/) 创建应用,并启用 **机器人** 能力。
2. 在机器人配置页面设置消息接收模式为 **Stream模式**。
3. 复制 `Client ID` 和 `Client Secret`,在 `.env` 中设置 `DINGTALK_CLIENT_ID` 和 `DINGTALK_CLIENT_SECRET`,并在 `config.yaml` 中启用该渠道。
4. *(可选)* 如需开启流式 AI 卡片回复(打字机效果),请在[钉钉卡片平台](https://open.dingtalk.com/document/dingstart/typewriter-effect-streaming-ai-card)创建 **AI 卡片**模板,然后在 `config.yaml` 中将 `card_template_id` 设为该模板 ID。同时需要申请 `Card.Streaming.Write` 和 `Card.Instance.Write` 权限。
**命令**
渠道连接完成后,你可以直接在聊天窗口里和 DeerFlow 交互:
| 命令 | 说明 |
|---------|-------------|
| `/new` | 开启新对话 |
| `/status` | 查看当前 thread 信息 |
| `/models` | 列出可用模型 |
| `/model [name\|default]` | 查看或固定当前会话使用的模型 |
| `/memory` | 查看 memory |
| `/help` | 查看帮助 |
> 没有命令前缀的消息会被当作普通聊天处理。DeerFlow 会自动创建 thread,并以对话方式回复。
模型选择是会话级的:`/model ` 将模型固定到**当前**会话——会按调用方可见的模型列表校验,选择写入 thread 元数据(Gateway 重启后仍有效),从下一条消息开始生效,无需新开对话。`/model` 查看当前生效模型及其来源,`/model default` 清除固定,`/models` 会报告当前固定的模型。
#### 请求链路关联
每个 Gateway HTTP 响应都携带 `X-Trace-Id` 响应头。若调用方传入了入站 `X-Trace-Id` 则继承之,否则自动生成,代理或上游服务可以借此跨服务固定同一个 id。该行为无需配置,也无法关闭。
同一 id 会附着在生命周期超出 HTTP 响应的工作上:分离出的运行任务、它委派的 subagent,以及后台记忆更新线程。它以 `deerflow_trace_id` 的形式记录在 run 记录上(runs API 可见)、thread 的 checkpoint 元数据中,以及 Langfuse 追踪里。定时任务、MCP 任务通知运行和 IM 渠道消息不经 HTTP 启动,会为每次出现自行铸造一个 id。
仅当增强日志开启时,日志记录才会携带该 id:
```yaml
logging:
enhance:
enabled: true # 将 trace_id 打印进日志记录
format: text # 或 json
```
该开关默认关闭,因为开启会改变日志格式。`logging` 配置需要重启才能生效,所以请编辑 `config.yaml` 并重启 Gateway。该设置只影响日志输出——id、响应头和运行元数据不受影响。
`deerflow_trace_id` 是 DeerFlow 的链路关联 id:它不是 run id,也不是 provider 的原生追踪 id,同样不是查询键——没有任何逻辑用它反查 thread 或 run;它只用于关联日志行。在 run 请求的 `metadata` 或 `config.context` 中传入的 `deerflow_trace_id` 会被忽略并覆盖,因此响应头、日志和持久化的运行记录永远不会相互矛盾。要固定关联 id,请发送 `X-Trace-Id` 请求头。
Gateway 的运行历史还会为每次运行记录一条终止时的 `run.delivery` 回执,包括零产出与崩溃恢复的运行。正常执行时,该回执会在持久化终止运行状态之前写入。孤儿恢复会先原子地认领过期租约,再幂等地回填回执,因此过期的恢复扫描不会覆盖仍在运行的详细交付事实。在事件存储中断期间,回执持久化保持尽力而为。对 checkpoint 预检失败(或在等待前序 finalization 时被取消)的运行,保持既有的完成数据行为:它们会收到零交付回执,但不会用空快照覆盖 RunStore 的完成字段。
当 `tool_progress.enabled` 为 true 时,同一份运行事件历史还会记录结果质量防护器的阶段变化。它也会为 lead agent 与普通 task subagent 记录 loop-detection 判定和延迟 MCP 工具晋升。晋升事件会标识新晋升的延迟工具名称,以及是路由元数据还是 `tool_search` 选中了它们,但不会把搜索查询、路由关键词、schema、参数、结果或目录哈希复制进晋升事件本身。
#### LangSmith 链路追踪
DeerFlow 内置了 [LangSmith](https://smith.langchain.com) 集成,用于可观测性。启用后,所有 LLM 调用、agent 运行和工具执行都会被追踪,并在 LangSmith 仪表盘中展示。
在 `.env` 文件中添加以下配置:
```bash
LANGSMITH_TRACING=true
LANGSMITH_ENDPOINT=https://api.smith.langchain.com
LANGSMITH_API_KEY=lsv2_pt_xxxxxxxxxxxxxxxx
LANGSMITH_PROJECT=xxx
```
#### Langfuse 链路追踪
DeerFlow 同样支持 [Langfuse](https://langfuse.com) 可观测性,适用于兼容 LangChain 的运行。
在 `.env` 文件中添加以下配置:
```bash
LANGFUSE_TRACING=true
LANGFUSE_PUBLIC_KEY=pk-lf-xxxxxxxxxxxxxxxx
LANGFUSE_SECRET_KEY=sk-lf-xxxxxxxxxxxxxxxx
LANGFUSE_BASE_URL=https://cloud.langfuse.com
```
如果你使用自托管的 Langfuse 实例,请将 `LANGFUSE_BASE_URL` 设置为你的部署地址。
**链路关联字段。** 每次 agent 运行都会标注 Langfuse 的保留追踪属性,这样 Sessions 和 Users 页面就能自动填充数据:
- `session_id` = LangGraph 的 `thread_id`——将同一会话的所有 trace 归为一组
- `user_id` = 来自 `get_effective_user_id()` 的有效用户(在无鉴权模式下回退为 `default`)
- `trace_name` = assistant id(默认为 `lead-agent`)
- `tags` = `[env:, model:]`(未设置时省略)
- `metadata.deerflow_trace_id` = DeerFlow 的请求关联 id,始终与同一请求返回的 `X-Trace-Id` 响应头一致(`logging.enhance.enabled` 只控制该 id 是否打印到日志中)
这些字段会在图(graph)调用的根部注入到 `RunnableConfig.metadata`,同时覆盖 gateway 路径(`runtime/runs/worker.py::run_agent`)和内嵌路径(`client.py::DeerFlowClient.stream`),因此任何兼容 LangChain 的 callback 都能读取到它们。设置 `DEER_FLOW_ENV`(或 `ENVIRONMENT`)可按部署环境为 trace 打标签。
#### 同时使用两种追踪服务
如果同时启用 LangSmith 和 Langfuse,DeerFlow 会挂载两个追踪 callback,并将相同的模型活动上报到两个系统。
如果某个 provider 被显式启用但缺少必要的凭据,或其 callback 初始化失败,DeerFlow 会在创建模型、初始化追踪时快速失败(fail fast),错误信息会指明导致失败的 provider。
Docker 部署时,追踪默认关闭。在 `.env` 中设置 `LANGSMITH_TRACING=true` 和 `LANGSMITH_API_KEY` 即可启用。
## 从 Deep Research 到 Super Agent Harness
DeerFlow 最初是一个 Deep Research 框架,后来社区把它一路推到了更远的地方。上线之后,开发者拿它去做的事情早就不止研究:搭数据流水线、生成演示文稿、快速起 dashboard、自动化内容流程,很多方向一开始连我们自己都没想到。
这让我们意识到一件事:DeerFlow 不只是一个研究工具。它更像一个 **harness**,一个真正让 agents 把事情做完的运行时基础设施。
所以我们把它从头重做了一遍。
DeerFlow 2.0 不再是一个需要你自己拼装的 framework。它是一个开箱即用、同时又足够可扩展的 super agent harness。基于 LangGraph 和 LangChain 构建,默认就带上了 agent 真正会用到的关键能力:文件系统、memory、skills、sandbox 执行环境,以及为复杂多步骤任务做规划、拉起 sub-agents 的能力。
你可以直接拿来用,也可以拆开重组,改成你自己的样子。
## 核心特性
### Skills 与 Tools
Skills 是 DeerFlow 能做“几乎任何事”的关键。
标准的 Agent Skill 是一种结构化能力模块,通常就是一个 Markdown 文件,里面定义了工作流、最佳实践,以及相关的参考资源。DeerFlow 自带一批内置 skills,覆盖研究、报告生成、演示文稿制作、网页生成、图像和视频生成等场景。真正有意思的地方在于它的扩展性:你可以加自己的 skills,替换内置 skills,或者把多个 skills 组合成复合工作流。
Skills 采用按需渐进加载,不会一次性把所有内容都塞进上下文。只有任务确实需要时才加载,这样能把上下文窗口控制得更干净,也更适合对 token 比较敏感的模型。
回答加载过技能时,底部工具栏会显示「使用的技能」。悬停或点击图标可查看本轮技能及其来源,悬停技能名称显示下划线,点击名称即可在可拖拽侧栏(手机端为抽屉)查看当时加载的 `SKILL.md` 快照。自动读取和 `/技能名` 显式调用均会记录,同一技能按首次加载顺序去重;之后修改或删除技能不会改变这份历史。复制得到包含 YAML 元数据的原始 Markdown 快照;包内相对链接和图片显示为引用,不会误跳转离开对话。范围读取或超出快照大小上限时会标明内容不完整。旧对话、失败读取以及通过 shell 等其他工具加载的技能不会凭回答文本推断为已使用。
通过 Gateway 安装 `.skill` 压缩包时,DeerFlow 会接受标准的可选 frontmatter 元数据,比如 `version`、`author`、`compatibility`,不会把本来合法的外部 skill 拒之门外。
Tools 也是同样的思路。DeerFlow 自带一组核心工具:网页搜索、网页抓取、网页渲染截图、文件操作、bash 执行;同时也支持通过 MCP Server 和 Python 函数扩展自定义工具。你可以替换任何一项,也可以继续往里加。
### 私有知识检索(RAGFlow)
DeerFlow 可连接租户级 RAGFlow,并通过 `knowledge_search` 按 embedding 模型分组并行召回运维允许的知识库;dataset ID 与 API key 不会暴露给模型。
使用内置 RAGFlow `knowledge_search` provider 时,可在 `config.yaml` 中设置 `knowledge_base.scope_selection_enabled: true`,为主智能体和自定义智能体聊天开放模式选择器右侧的纯图标“知识库”按钮。图标持续高亮表示知识检索已启用,普通状态表示本轮检索已关闭。用户可选择全部允许知识库、指定知识库/文件或关闭本轮检索。同一个配置开关统一控制两类聊天;关闭时两类输入框都不显示、也不提交知识范围。选择仅保存在当前页面内,刷新或切换对话后恢复“全部”;每条已发送的人类消息保留不可变的范围快照,用于历史回显、重试和恢复。回复待处理的澄清问题或编辑后重新生成时,若提交了当前选择器快照则以该新范围为准,未提交时继承来源轮次已接纳的范围;知识库仍处于“全部可检索文件”时,展开文件区域不会加载目录,切换为“指定文件”后才加载。Gateway 会校验快照、与运维 allowlist 取交集,把仅含执行字段的范围传递给 native/durable 子智能体,并在模型输入和外部 trace 中清除完整范围。`knowledge_base` 是与 provider 无关的能力开关,只控制知识能力和选择器是否启用;RAGFlow 的连接、dataset allowlist 和检索参数(`base_url`、`api_key`、`datasets`、`page_size`、阈值及输出上限)必须配置在 `tools[].name: knowledge_search` 条目中,`knowledge_base` 中的这些字段不会被读取。
每条消息仍可选择最多 1000 份文档;同一知识库超过 100 份时,DeerFlow 会按每批最多 100 份校验,保留完整选择范围。任何一批文档不可访问或不可检索,都会拒绝本次检索。
自定义智能体聊天请求会同时携带该智能体名称作为 `assistant_id` 和
`context.agent_name`,确保 Gateway 的范围校验与运行时加载的是同一个智能体;主智能体聊天使用 `lead_agent`,两者都只有在共享配置启用 RAGFlow provider 时才会提交知识范围。
本版不在工作区侧边栏增加独立的“知识库”入口,也不提供 DeerFlow 知识库管理页面;知识库和文件的创建、上传、解析与删除仍直接在 RAGFlow 中完成。
Gateway 生成后续建议时,现在会先把普通字符串输出和 block/list 风格的富文本内容统一归一化,再去解析 JSON 数组响应,因此不同 provider 的内容包装方式不会再悄悄把建议吞掉。
Web UI 支持从已完成的 assistant 回复分叉出一个新的主对话。自动继承的分叉标题会使用下一个空闲的数字后缀(`标题 (2)`、`标题 (3)`……);显式指定或手动重命名得到的同名后缀也会占号,即使它没有生成序号 metadata,后续自动分叉也不会与它重名。API 调用方显式提供的标题保持不变;重命名会清除旧的生成序号,因此从新标题继续自动分叉时会重新从 `(2)` 开始。最近对话列表还会把已加载的分叉直接排列在已加载的父对话下方,并显示低干扰的树形连接线。父对话尚未加载、谱系数据错误或成环、父子置顶状态不一致时,分叉会安全地保留在顶层,不会被隐藏或跨越置顶边界移动。新 thread 会保留该轮回复的 checkpoint 以及用户消息之前的重放 checkpoint,因此分叉后可以立即重新生成该回复。对于缺少 checkpoint 父链接的旧历史或导入历史,Gateway 会进行有界的时间顺序查找;如果不存在更早的重放 checkpoint,分叉仍会按旧版单-checkpoint 形态成功创建,但无法重新生成继承的回复。已有的单-checkpoint 分叉会保持不变,不会通过不安全的 checkpoint 复制尝试修复。只有从最新回合分叉时才会尽力复制当前 thread 的工作区文件;从历史回合分叉不会带入后续时间线创建的文件。
```text
# sandbox 容器内的路径
/mnt/skills/public
├── research/SKILL.md
├── report-generation/SKILL.md
├── slide-creation/SKILL.md
├── web-page/SKILL.md
└── image-generation/SKILL.md
/mnt/skills/custom
└── your-custom-skill/SKILL.md ← 你的 skill
```
#### Claude Code 集成
借助 `claude-to-deerflow` skill,你可以直接在 [Claude Code](https://docs.anthropic.com/en/docs/claude-code) 里和正在运行的 DeerFlow 实例交互。不用离开终端,就能下发研究任务、查看状态、管理 threads。
**安装这个 skill:**
```bash
npx skills add https://github.com/bytedance/deer-flow --skill claude-to-deerflow
```
然后确认 DeerFlow 已经启动(默认地址是 `http://localhost:2026`),在 Claude Code 里使用 `/claude-to-deerflow` 命令即可。
**你可以做的事情包括:**
- 给 DeerFlow 发送消息,并接收流式响应
- 选择执行模式:flash(更快)、standard、pro(规划模式)、ultra(sub-agents 模式)
- 检查 DeerFlow 健康状态,列出 models / skills / agents
- 管理 threads 和会话历史
- 上传文件做分析
**环境变量**(可选,用于自定义端点):
```bash
DEERFLOW_URL=http://localhost:2026 # 统一代理基地址
DEERFLOW_GATEWAY_URL=http://localhost:2026 # Gateway API
DEERFLOW_LANGGRAPH_URL=http://localhost:2026/api/langgraph # LangGraph API
```
完整 API 说明见 [`skills/public/claude-to-deerflow/SKILL.md`](skills/public/claude-to-deerflow/SKILL.md)。
Web UI 输入框支持浏览器侧语音听写。浏览器提供 Web Speech API 时,麦克风按钮会把语音转写为本地草稿;DeerFlow 只接收转写后的文本,音频处理交由浏览器或操作系统语音识别服务按其环境策略完成。用户可以在发送前继续检查和编辑文本。
### 会话归档
在侧栏最近会话的菜单中点击「归档」,可以隐藏已完成的会话,同时保留消息、文件和原链接。成功提示提供「撤销」。在「对话 → 已归档」中查看并逐条恢复;已打开的归档会话也会在顶部显示恢复入口。搜索匹配已加载会话的标题,较早记录可通过「加载更多」查找。
归档与恢复保留会话原有的活动时间和置顶状态。归档不会停止运行中的任务或暂停定时任务,新消息也不会自动恢复会话。需要移除会话及其文件时,使用原有的删除操作。
### Session Goals
用 `/goal <完成条件>` 为当前 thread 绑定一个激活态的完成条件。这个 goal 是 thread 维度的状态,而不是技能激活,所以它会跨轮次持续生效,直到 DeerFlow 判定它已被满足、或者你手动清除它。
支持的命令:
```text
/goal finish the implementation and make all tests pass
/goal # 查看当前激活的 goal
/goal clear # 清除它
```
每次 Gateway 驱动的 run 结束后,DeerFlow 会用一个 non-thinking 的评估模型,把可见的对话内容(包括助手的工具调用和截短的工具结果)拿去和激活的 goal 比对。工具调用成功本身不代表 goal 已完成;如果助手不得不猜测缺失或含糊的信息,评估模型会报告 `needs_user_input`。评估模型必须返回一个带类型的 blocker(`missing_evidence`、`needs_user_input`、`run_failed`、`external_wait` 或 `goal_not_met_yet`),并附上可见证据。只有在最近一轮 assistant 回复已被持久化 checkpoint、blocker 是 `goal_not_met_yet`、评估期间 thread 没有变化、且无进展熔断器没有触发时,DeerFlow 才会注入一次 hidden continuation。安全上限默认是 8 次 hidden continuation;连续两次相同的无进展评估后就会停止。`/goal clear` 以及任何用户手动输入的新内容,优先级都高于排队中的 continuation。当 goal 被满足时,DeerFlow 会自动清除它,并发布更新后的 thread 状态。同一个 checkpoint 会把这次达成记为 `goal_outcome`,保留到下一次修改 goal。
Web UI 会在输入框上方展示当前激活的 goal,说明自动续跑为什么停下,并在 goal 达成后显示「目标已达成」提示;设置了 goal 时不能编辑最后一条消息。同样的命令在 TUI 和受支持的 IM 渠道里也可用。在 Web UI 和受支持的 IM 渠道里,设置 `/goal <完成条件>` 还会以该条件作为任务启动一次 run;状态查询和清除命令则只管理 goal 状态本身。
### 手动上下文压缩
启用 `task_continuity.enabled` 后,可用 `history_search` 检索当前任务的活跃消息和
已压缩历史。可选参数 `role` 接受 `user`、`assistant`、`tool`,在最多八条结果的
截断前过滤;省略或 `null` 保持原有全角色搜索。使用 `history_read` 核对来源原文,
历史用户消息不代表当前授权。详见[任务连续性说明(英文)](docs/task-continuity.md)。
在 Web UI 输入框中使用 `/compact`,可以把当前 thread 的早期上下文压缩成摘要。完整聊天记录仍会保留在界面上,但后续模型调用会基于压缩摘要和最近消息继续。当前历史不足时不会压缩;thread 正在运行任务时会阻止压缩。
### Sub-Agents
Sub-agent 是一种执行优化,而不是遇到复杂任务时的默认选择。
lead agent 只会在委派具有明确净收益时动态拉起 sub-agents,例如真正缩短耗时的并行工作、专业能力收益或上下文隔离收益。存在跨 Agent 依赖或重叠副作用的工作不会并行分派;当专业能力或上下文隔离收益明显占优时,一条有界的顺序任务链仍可交给一个 sub-agent 完成。lead agent 会使用能取得收益的最少 sub-agents,并在每一批完成后重新评估,而不会仅仅因为任务规模大或步骤多就继续拆分。每个 sub-agent 都有自己独立的上下文、工具和终止条件,返回结构化结果后由 lead agent 验证并汇总成完整输出。
管理员可以在**设置 → 子智能体**中添加、修改、停用和删除可复用的工作智能体;内置项和 `config.yaml` 项会在同一目录中以只读方式展示。默认 Lead Agent 可以使用全部已启用的运行时 sub-agents;页面创建的每个 Custom Agent 则可以选择允许全部、全部禁用或仅允许指定项。该范围同时约束模型可见目录和服务端 `task` 工具,不能通过直接填写名称绕过。当前版本的设置页管理定义是部署级全局数据,并跟随 `agent_storage.backend`:单机使用原子文件,多实例使用共享应用数据库。
例如,彼此独立的只读研究可以在并行节省的时间明显高于重复检索和结果合并成本时并发执行;而会修改相同文件、依赖连续测试反馈的仓库重构则由 lead agent 直接完成。当 `max_concurrent_subagents` 为 `1` 时,提示词会关闭并行和多批次路由指导,仅在专业能力或上下文隔离具有明确收益时保留委派。
### Sandbox 与文件系统
上传文档的转换大纲和预览会校验原文件版本,包括修改时间戳。检测到原文件版本变化后,即使大小不变,也不会再使用旧转换结果。缺少原文件时间戳的旧归属记录同样会被拒绝;可在启用 `uploads.auto_convert_documents: true` 后重新上传原文件以恢复转换大纲。文件都会保留,未通过校验的转换 Markdown 会在 Agent 的历史文件列表中作为独立文件显示。Windows 上的 `st_ctime_ns` 可能表示创建时间,因此等长度覆盖后若恢复原 `mtime`,校验可能无法识别变化。时间戳校验是保守的元数据校验,不能保证文件内容完全一致。
DeerFlow 不只是“会说它能做”,它是真的有一台自己的“电脑”。
每个任务都运行在隔离的 Docker 容器里,里面有完整的文件系统,包括 skills、workspace、uploads、outputs。agent 可以读写和编辑文件,可以执行 bash 命令和代码,也可以查看图片。整个过程都在 sandbox 内完成,可审计、会隔离,不会在不同 session 之间互相污染。
这就是“带工具的聊天机器人”和“真正有执行环境的 agent”之间的差别。
```text
# sandbox 容器内的路径
/mnt/user-data/
├── uploads/ ← 你的文件
├── workspace/ ← agents 的工作目录
└── outputs/ ← 最终交付物
```
### Agentic Browser Control
读取页面和真正“使用”页面不是一回事。除了只读的 `web_fetch` 和 `web_capture` 工具外,DeerFlow 还提供一组可选的 agentic browser 工具,为每次对话保持一个实时浏览器会话,让 agent 真正操作页面——导航、读取可交互元素、点击、输入、提交表单,并在重度 JavaScript 站点上完成多步流程。
每次操作都会返回页面可交互元素的最新快照,每个元素用稳定的 `[ref]` 编号寻址,因此 agent 基于刚观察到的内容行动,而不是猜测选择器。出站 URL 默认会经过 SSRF 筛查,浏览器的 TCP 连接也都经过一个本地代理,该代理把每个连接固定到筛查通过的地址,因此检查之后才改变的 DNS 应答无法把连接引向内网主机(WebRTC UDP 不在覆盖范围内)。该能力由 Playwright 提供,作为 optional extra 发布,以保持核心安装精简:
```bash
cd backend
uv sync --extra browser
uv run playwright install chromium
```
然后在 `config.yaml` 中取消注释 `group: browser` 工具项(`browser_navigate`、`browser_snapshot`、`browser_click`、`browser_type`、`browser_get_text`、`browser_back`、`browser_screenshot`、`browser_close`)。`make dev` / Docker 启动时如果检测到已启用 `browser_navigate`,会在依赖同步时保留 `browser` extra。如果配置了 browser control 但缺少 Playwright,Gateway 会启动失败;`/api/features` 也会在后端无法提供该能力时隐藏 Browser UI。除本地、受信任的调试外,请保持 `headless: true` 和 `allow_private_addresses: false`。通过 `cdp_url` 连接到已有 Chrome 时,DeerFlow 无法强制执行子资源和重定向的 SSRF 防护,因此会 fail closed,除非显式设置 `allow_unguarded_cdp: true` 确认该风险;仅用于受信任的本地浏览器。Browser session 是进程本地的;启用该工具组时请保持 `GATEWAY_WORKERS=1`,因为普通 uvicorn worker 调度不提供 thread affinity。
已有的、非 mock 的 Custom Agent 对话会在 browser control 可用、且该 agent 未限制 `tool_groups` 或已包含 `browser` 组时,展示同样的 Browser Live 控件。如果显式 allowlist 里没有 `browser`,这些控件会保持隐藏。
workspace 的 Browser Live 客户端通过二进制 JPEG WebSocket 帧协商画面,每个显示刷新只保留最新的待处理帧,并回收被替换的 object URL。Gateway 控制消息仍是 JSON;未请求二进制能力的客户端继续使用旧的 JSON/base64 帧协议。
### Context Engineering
**隔离的 Sub-Agent Context**:每个 sub-agent 都在自己独立的上下文里运行。它看不到主 agent 的上下文,也看不到其他 sub-agents 的上下文。这样做的目的很直接,就是让它只聚焦当前任务,不被无关信息干扰。
**摘要压缩**:在单个 session 内,DeerFlow 会比较积极地管理上下文,包括总结已完成的子任务、把中间结果转存到文件系统、压缩暂时不重要的信息。这样在长链路、多步骤任务里,它也能保持聚焦,而不会轻易把上下文窗口打爆。
### 读取引用的会话
Gateway API 调用方可以启用 `read_conversation`,并在一次 run 中提交 `conversation_references` 列表。主 agent 随后可以分页读取这些归属会话当前可见文本的有界页面。读取权限随该次 run 结束而失效,旧消息中的文本不会授予访问权限。访问权限失效或来源被删除后,agent 已经读过的文本仍会保留在目标会话中。一条消息如果单次读取放不下,会带有续接,agent 可以继续读取剩余部分;只有在那次读取不可用时,它才会请求缺失的部分。
无法在请求顶层添加字段的 SDK 客户端可以把同样的列表放在 `context.conversation_references` 中发送,`GET /api/features` 会报告该工具是否启用。启用后,Web UI 输入框会在附件按钮旁边显示一个"引用会话"按钮:最多选择你最近的三个会话,它们只附加到下一条消息上,以 chips 的形式显示在输入框与对话记录里。不会自动搜索历史。参见[配置](backend/docs/CONFIGURATION.md#reading-referenced-conversations)与[请求契约](backend/docs/API.md#referencing-a-previous-conversation)。
### 当前任务笔记
当前任务可通过 `task_continuity.enabled: true` 开启[任务笔记与历史回查](docs/task-continuity.md)。
任务笔记最多八条;并行新增超出剩余名额时返回 `note_capacity`,保留原有笔记。
启用资源句柄解析时按解析后的实际 key 计数,指向同一笔记的别名共用名额。
同批调用中格式异常的非字典参数不会占用名额或影响正常笔记调用。
无效 key、超过 750 字符的内容、超过四个引用或格式无效的引用 ID 也不会占用名额。
已有 key 仍可替换或删除;同批删除及运行时失败(如来源不可读或策略拒绝)释放的名额在下一批可用,可届时重试。
### 长期记忆
大多数 agents 会在对话结束后把一切都忘掉,DeerFlow 不一样。
跨 session 使用时,DeerFlow 会逐步积累关于你的持久 memory,包括你的个人偏好、知识背景,以及长期沉淀下来的工作习惯。你用得越多,它越了解你的写作风格、技术栈和重复出现的工作流。memory 保存在本地,控制权也始终在你手里。
默认 DeerMem `middleware` 模式会先判断候选信息的作用域、持久性和授权属性,再由确定性写入门决定是否保存。只有稳定、描述性的用户级事实能进入长期 memory;当前对话或项目的约束、一次性操作授权仍留在对话状态中。用户全局 summary 必须同时具有用户级作用域和描述性授权属性,基于矛盾的删除也会经过作用域保护;如果删除依赖一条替代事实,只有替代事实真正通过校验并保留下来后才执行删除。这些分类字段只用于本次抽取,不写入 fact 文件,也不增加 LLM 调用次数。`memory.mode: tool` 的显式 CRUD 仍是独立的模型直写路径。如果通过 `memory.backend_config.prompts_dir` 覆盖了内置抽取模板,必须同步在自定义模板中加入新的分类字段(`memory_update` 的 fact/summary/removal 格式与 `consolidation` 的合并 fact 结构):写入门是 fail closed 的,未迁移的旧模板会导致所有抽取驱动的 fact、summary 与删除写入停止,只能通过 `rejected_by_scope_gate` 指标和高拒绝率告警发现。
当一个作用域的 fact 达到 `max_facts` 时,DeerMem 默认仍沿用仅按 confidence 排序的旧策略。可以显式设置 `memory.backend_config.fact_eviction_policy: hybrid-v1`,改用有界综合分:confidence 65%、用户明确确认的新鲜度 25%、查询召回热度 10%。只有开启 hybrid-v1 或 shadow 模式时才会收集这两类信号元数据。确认由已有的 memory-update LLM 调用返回 `factsToReinforce`,但只有确定性消息检测也发现用户 reinforcement 信号时才会更新,并同时重置该 fact 的 staleness review 时钟。这个确定性门禁是批次级的:它只能证明当前抽取批次最后六条已过滤消息中的某条用户消息命中了 reinforcement 模式。具体 fact 由 LLM 选择的 `factsToReinforce` ID 绑定;DeerMem 不会另外校验该信号与 fact 的一一对应关系。重复抽取、自动注入和单纯召回都不会确认 fact。自定义 `memory_update` prompt 如果希望参与确认新鲜度,需要加入可选的 `factsToReinforce` 数组。召回热度单独保存在衰减 sidecar 中,只有 `memory_search` 真正返回的 fact 才增加,不会重写 canonical Markdown 或污染 `updatedAt`。Hybrid 模式还为 correction 保留有限的最低槽位(容量的 10%,最多 10 个;未使用的槽位会释放给其他类别)。容量删除仍是物理删除,但会留下不含正文的有界审计记录。启用 `fact_eviction_shadow_enabled` 可以在不改变实际保留结果的情况下比较 hybrid-v1;整个功能不增加 LLM 调用,切回 `confidence` 即可回滚。
## 推荐模型
DeerFlow 对模型没有强绑定,只要实现了 OpenAI 兼容 API 的 LLM,理论上都可以接入。不过在下面这些能力上表现更强的模型,通常会更适合 DeerFlow:
- **长上下文窗口**(100k+ tokens),适合深度研究和多步骤任务
- **推理能力**,适合自适应规划和复杂拆解
- **多模态输入**,适合理解图片和视频
- **稳定的 tool use 能力**,适合可靠的函数调用和结构化输出
## 内嵌 Python Client
DeerFlow 也可以作为内嵌的 Python 库使用,不必启动完整的 HTTP 服务。`DeerFlowClient` 提供了进程内的直接访问方式,覆盖所有 agent 和 Gateway 能力,返回的数据结构与 HTTP Gateway API 保持一致。HTTP Gateway 还提供 `DELETE /api/threads/{thread_id}`,用于在 LangGraph thread 本身被删除之后,清理 DeerFlow 托管的本地 thread 数据:
```python
from deerflow.client import DeerFlowClient
client = DeerFlowClient()
# Chat
response = client.chat("Analyze this paper for me", thread_id="my-thread")
# Streaming(LangGraph SSE 协议:values、messages-tuple、end)
for event in client.stream("hello"):
if event.type == "messages-tuple" and event.data.get("type") == "ai":
print(event.data["content"])
# 配置与管理:返回值与 Gateway 对齐的 dict
models = client.list_models() # {"models": [...]}
skills = client.list_skills() # {"skills": [...]}
client.update_skill("web-search", enabled=True)
client.upload_files("thread-1", ["./report.pdf"]) # {"success": True, "files": [...]}
client.set_goal("thread-1", "finish the implementation and make all tests pass")
client.get_goal("thread-1") # {"goal": {...}} or {"goal": None}
client.clear_goal("thread-1")
```
所有返回 dict 的方法都会在 CI 中通过 Gateway 的 Pydantic 响应模型校验(`TestGatewayConformance`),以确保内嵌 client 始终和 HTTP API schema 保持同步。完整 API 说明见 `backend/packages/harness/deerflow/client.py`。
## 项目 (Projects)
项目把相关会话组织在同一个名称、共享指令和文档架之下。
会话在创建时(选择了某个项目)或之后通过移动菜单加入项目。运行不会修改归属关系:发送消息不会把会话指派或改派到任何项目。把会话移出项目后,它会保持未归属状态,直到再次被显式移动。
移动会话会同时刷新会话顶部的归属信息和项目列表,即使还有较早的元数据请求尚未返回。
项目依赖当前的数据库表和列。如果数据库停留在旧的 0018 rollout 的 `0019_thread_incarnations` 版本且缺少项目表结构,启动会被拒绝。请先在启动本版本之前按照[离线数据库恢复流程](docs/database-forward-revision-recovery.md)处理。
项目依赖当前的数据库表和列。如果数据库停留在旧的 0018 rollout 的 `0019_thread_incarnations` 版本且缺少项目表结构,启动会被拒绝。请先在启动本版本之前按照[离线数据库恢复流程](docs/database-forward-revision-recovery.md)处理。
### 项目指令 (Project instructions)
每个项目可以保存一段自由文本指令——适用于项目内所有会话的背景、约定和约束——在项目页的 Instructions 标签页编辑,并带有实时字节计数。成员线程每次发起运行时,Gateway 会一次性固定(pin)项目当前状态,把指令渲染成一个有界的、仅在本次请求内有效的 `` 块:它不会进入系统提示词,也不会写入持久化历史;每次新运行都会读到最新保存的指令。指令长度上限为 `projects.instructions_max_bytes`(按 UTF-8 字节计,默认 8192,可配范围 256–262144),多字节字符按其 UTF-8 字节长度计数。超限的指令会在写入时被 `422` 拒绝,绝不会被静默截断。
### 文档架 (Document shelf)
每个项目都有一个文档架,用于存放整个项目共享的文件,在项目页的 Documents 区域管理:
- **上传**文件(按钮或拖拽,每次请求一个文件)。大小限制复用 `uploads.max_file_size`(默认 50 MiB);重复上传相同内容会返回已有条目,而不是产生重复。
- **列出**条目,包含名称、大小、修改时间和来源徽标(直接上传 vs. 从会话保存),并可预览或下载任意条目。
- **从会话文件保存到项目**:文档架下方只读的会话文件浏览器按 thread 分组列出成员会话的上传与输出文件,每个条目都带 Save to project 操作。
- **附加到会话(Attach to thread)**:把文档架文件复制到某个会话的上传目录,走与常规上传相同的接入管线,让该会话可以直接使用。
成员线程的运行还会收到一个按运行渲染的有界 `` 索引(由固定快照生成,受 `projects.shelf_index_max_entries` 和 `projects.shelf_index_max_bytes` 限制),agent 也可以通过 `list_project_documents` 和 `read_project_document` 工具分页浏览文档架并读取文档。
### 归档读取语义 (Archive read semantics)
归档项目会冻结写入,但保留读取。归档项目中的会话仍可运行,仍会收到项目指令和文档架索引;文档架也保持完全可读:列表、预览/下载、会话文件浏览器和附加到会话都继续可用。上传、保存到项目、把单个文档架文件移入回收站都要求项目处于活跃状态,回收站中的文档也不能恢复到已归档的项目。删除已归档项目仍然允许,并会把它的整个文档架移入回收站。
### 回收站 (Trash)
删除文档架文档会把它移入回收站而不是直接抹除:条目保留其字节内容和来源项目快照,保留期为 `projects.trash_retention_days`(默认 30 天),之后保留期清理才可能将其永久清除。`/workspace/trash` 页面——可从项目页 Documents 区域和侧边栏 Projects 标题进入——列出回收站中的文档及其来源项目和剩余保留天数,提供逐条 Restore(恢复)和 Delete permanently(永久删除)操作,以及清空回收站(Empty trash,立即永久删除回收站中的全部条目,无需等到保留期结束;保留期只决定单条记录在被保留期清理回收前最多能停留多久)。恢复会把文档放回其来源项目;来源项目已删除或已归档时,可以选择一个目标项目;如果目标项目中已有内容完全相同的活跃文件,两个条目会合并。删除项目会在同一步骤中把它的整个文档架移入回收站。
## 定时任务 (Scheduled Tasks)
DeerFlow 现在在 workspace 里内置了一个一等的定时任务(scheduled-task)MVP。
当前 MVP 能力:
- 在 `/workspace/scheduled-tasks` 管理任务
- 支持按任务标题或提示词搜索,可与状态、类型筛选及当前会话范围组合使用
- 每个定时任务可以选择复用同一个 thread 及其历史对话,也可以选择每次运行新建一个 thread
- 每个任务可以固定使用 `lead_agent`(默认)或当前用户已有的自定义 agent;未知名字会被拒绝
- 将现有任务复制到创建表单中作为可编辑草稿,不复制运行历史
- 支持 `once`、`cron` 和 `interval` 三种调度方式
- 后台定时执行以非交互式 DeerFlow run 运行(那里不会暴露 `ask_clarification`)
- 当所复用的 thread 或全局执行配额正忙时,到期执行会持久化为 `queued`,并在可用后启动;队列项在 Gateway 重启后保留,超过 `scheduler.queue_timeout_seconds` 后标记为失败
- 执行位置在任务所有者之间公平分配:同一所有者同时启动或运行的定时运行最多 `scheduler.max_concurrent_runs_per_user` 个(默认 2,不超过 `max_concurrent_runs`;设为 `0` 即关闭这一按所有者的上限)。等待队列按所有者轮流取出,一个人积压的运行不会挡住别人的运行。等待超过 `scheduler.queue_timeout_seconds` 的运行会被跳过,运行记录显示“已跳过:等待空闲位置的时间过长”
- 当某次执行处于 `queued`、`launching` 或 `running` 时冻结任务定义,避免持久化的执行意外换用新的 prompt、thread 或调度;将任务切换为暂停或删除任务会取消已在等待的执行,而 `launching`/`running` 执行结束后才能重试这些变更;显式手动触发在调度已暂停时仍可等待并执行,且不会自动恢复调度
- 支持暂停、恢复、手动触发、查看历史和删除任务
- 定时任务通过正常的 DeerFlow run 生命周期执行
- 当 `channel_connections.enabled: true` 时,定时任务通知会发送到任务所有者已绑定、且支持主动推送的 IM 应用(outbox + 投递 worker),目前只有企业微信支持;设置页会在每个应用上标明是否发送,其它应用不会收到通知。每次执行最多发一条消息,内容可能是:一次运行完成、出错或未达成目标,连续 3 次未达成目标后自动暂停,由智能体暂停(停止条件已满足),或任务已结束(`max_runs` 次运行全部完成、已到 `end_at`);同时发生多件事时,以暂停或结束为准,并在同一条消息里说明最后一次运行的结果。单次任务只发它那次运行的结果。消息与执行结果在同一个数据库事务中入队,因此崩溃或租约失效后恢复的执行也只通知一次。消息内容可以单独读懂,使用你在网页界面中选择的语言(未设置时用 `channel_connections.notification_locale`):任务标题、发生了什么、智能体有回复时附一行结果,最后是“在 DeerFlow 的定时任务页查看详情。”,不含任何 ID 或链接。单纯的手动「立即运行」试跑和被中断的运行不通知;没有跑完一次运行就结束的执行记录(启动失败、排队超时、因重启而中断)也不通知。渠道/传输宕机时会停车且不耗尽重试,最长约一天;平台拒绝大约重试 15 分钟后落为 `failed`。等待期间被你解绑的身份不会再收到推送:该条投递直接落为 `failed`。
- 按每页 50 条浏览执行历史;历史页暂停自动刷新,可随时返回最新记录。 仅在读取成功后显示条数,加载中或失败不会误显示为零条。
**通过 API 筛选执行历史**
排查失败记录时,无需先下载所有成功记录。已认证且具有 `threads:read` 权限的客户端,可以针对自己的任务请求 `GET /api/scheduled-tasks/{task_id}/runs?status=failed&limit=50&offset=0`。可选的 `status` 支持 `queued`、`launching`、`running`、`success`、`failed`、`skipped`、`interrupted`、`unmet`;这些是执行记录的状态,`completed` 等任务状态会被拒绝(422)。
筛选先于分页执行。`limit`(1–200,默认 50)和 `offset`(非负整数,默认 0)作用于匹配记录,按创建时间、ID 依次降序排列。不传 `status` 时保留原有的混合历史数组,无匹配项返回 `[]`。此 API 不改变任务执行行为,workspace 历史界面仍展示未筛选的记录。
当前 MVP 限制:
- 没有纯文本通知任务
- 没有渠道或 GitHub 分发目标(上面的结果推送不是分发目标)
通过 `config.yaml -> scheduler.enabled` 开启后台轮询。手动触发使用同样的 scheduled-task 资源和执行路径。
### 生命周期、保险上限和停止条件
- 任务页面和 REST API(`POST` / `PATCH /api/scheduled-tasks`)与对话一样,支持每次运行的目标(`goal_objective`)、保险上限(`max_runs`、`end_at`)和停止条件(`stop_condition`)。在 PATCH 中传 `null` 可以清除这四项中的任意一项;不带 UTC 偏移的 `end_at` 按任务所在时区的本地时间理解。
- 停止条件是用户“满足某个条件就停”的规则,单独保存在自己的字段里(迁移 `0031`),不会写进任务指令。只有在运行启动时,DeerFlow 才把它附加到这次运行的消息中,要求运行在条件满足时调用 `stop_scheduled_task`。开启 `scheduler.tool_enabled` 时,无论任务是在对话中还是在任务页面创建的,每次定时运行都能暂停自己的定时任务;关闭时,运行只会说明条件已满足,不会被要求调用它没有的工具。
- 在任务页面创建的带目标任务,现在也会像对话中创建的任务一样检查目标,其运行同样会收到已保存的备注和上一次运行的引用。
- 恢复时从当前时间重新计算下次运行,长时间暂停后不会补跑。时间已过的单次任务返回 `422 once_time_passed`,需要设置新的时间。恢复一个已启用的任务不会有任何变化;暂停已结束的任务返回 `409 task_finished`。
- `max_runs` 统计任务累计的自动运行次数,试运行不计入。重新启用保险上限已用完的任务(恢复,或通过 PATCH 修改已结束任务的运行时间使其重新启用)会返回 `409 limits_exhausted`,除非同一个请求放宽了已用完的那项上限:运行次数用完时,需要提高 `max_runs` 或传 `null` 取消;结束时间已过时,需要把 `end_at` 改晚或传 `null` 取消(只把 `end_at` 改晚,不能让次数已用完的任务恢复)。`POST /api/scheduled-tasks/{task_id}/resume` 为此接受可选的 `{"max_runs": …, "end_at": …}` 请求体(`null` 表示取消这项上限;在对话中创建、且比每小时更频繁的任务必须保留一项上限)。只修改已结束任务上限的 PATCH 会保存新上限,任务仍保持已结束。
- 未能检查目标(评估器出错,或检查期间对话发生了变化)既不计入连续 3 次未达成目标的自动暂停,也不会让计数清零。修改目标、任务指令或停止条件,以及新增备注,都会重新计数;恢复不会清零。
- 当前 Gateway 进程的调度器未运行时,新建任务(包括复制)会返回 `409 scheduler_not_running`,因为这样的任务不会按计划运行。`GET /api/features` 会返回 `scheduled_tasks.available`、`running`、`tool_enabled` 和 `min_interval_seconds`。
- `/api/scheduled-tasks*` 的错误格式为 `{"detail": {"code", "message", "params"}}`,详见 [`backend/docs/API.md`](backend/docs/API.md#scheduled-tasks) 和 `contracts/scheduled_task_errors_contract.json`。
### 在对话中创建定时任务
同时设置 `scheduler.enabled: true` 和 `scheduler.tool_enabled: true`,重启
Gateway 后,具有权限的交互式对话可以通过 `schedule_task` 创建、修改、列出、
暂停、恢复或删除任务,发起试运行,或保存备注。例如:“每个工作日 9 点检查
release-checklist.md,把没勾的项告诉我;全部勾完就停。”在 Web 应用中,结果会
显示为一张实时更新的卡片,包含运行时间、停止条件和操作按钮,智能体只用一两句
话回复;IM 等非 Web 对话则用文字说明运行时间、下次运行和停止条件。
- **一个对话能管理哪些任务。** 在该对话中创建的任务;在某次运行的对话(定时
运行发出结果的那个对话)里,还能管理这次运行所属的任务,例如“暂停这个”
“改到 10 点”。这只适用于你发出的消息;定时运行本身只能用
`stop_scheduled_task` 暂停自己的定时任务。
- **修改不会换任务。** 修改运行时间、任务指令、目标、停止条件或保险上限,都是
对同一个任务执行 `update`,任务 ID 和运行记录保持不变。`resume` 会恢复已暂停
或已结束的任务,不会补跑。保险上限已用完时,智能体会针对用完的那项上限问你
怎么处理(提高 `max_runs` 或取消;推迟 `end_at` 或取消),再随恢复一起提交。
- **时区。** 你指定的时区优先。否则,新任务使用 Web 应用随每条消息发送的浏览器
时区(`context.client_timezone`,只用于这一点),结果中会说明用了哪个时区。
按间隔运行的任务和带 UTC 偏移的单次时间不需要时区;如果是 cron 或不带偏移的
单次本地时间,又不知道时区(例如来自 IM),智能体会先问你。修改任务时沿用
已保存的时区,浏览器时区不会改动已有任务。
- **结果发在哪里。** 每次运行都会把结果发在一个新的对话里,标题为“任务名 · 本地
时间”;如果任务在来源对话中运行,就发在来源对话里。调度由智能体暂停、被自动
暂停或已结束时,来源对话会在当时对话所在的位置显示一行说明,并附上查看那次运行
或打开任务的链接;除此之外,不会再往来源对话发送任何内容。删除任务后,这行说明
仍会保留。运行对话会把任务指令收起为运行信息下方的一行“任务指令”,不再显示成
一长段用户消息。
- **语言。** 智能体会用你的语言写标题、任务指令和停止条件;定时运行用任务指令
的语言回复。
新任务默认每次创建独立会话。`goal_objective` 只验证当次执行,达成它不会结束
周期性调度。运行中的 Agent 在用户的停止条件满足后,可以请求
`stop_scheduled_task` 停止自己的调度,请求在执行终结时生效。`max_runs` 只计算
自动启动次数,`end_at` 指定结束时间;结束条件优先于暂停请求。工具创建的每小时
多次调度必须带结束条件,每位用户最多保留 20 个活动工具任务,暂停任务也占名额。
未达目标的执行记为 `unmet`,与执行故障区分。周期任务连续三次符合条件的自动
执行未达目标后会暂停。成功会重置计数,包括依赖已声明假设的成功;手动试跑、
中断、执行故障、等待外部条件和未能检查目标都不递增计数。恢复不重置计数,下一次符合条件的
未达目标可能再次暂停。支持主动推送的已绑定 IM 应用会通过同一个持久化 outbox,
每次执行收到一条通知(未达成目标、自动暂停、由智能体暂停、已结束);单纯的手动试跑不通知。
用户可以在能管理该任务的对话中明确要求保存今后执行的备注,最多 10 条、每条
500 字符。新会话中的周期任务可以通过按需开启的 `read_conversation` 回查上一次
已执行的会话,仍须满足属主和读取权限检查。这是来源引用,不会自动生成记忆,
也不会把结果回写到来源会话。
试运行时请直接提出,例如“先跑一次吧”“好的,先试一下”或“Run it now”;在 Web
应用中,卡片上的“立即试运行”按钮效果相同。宿主只接受本轮用户消息中限定的中英文
直接执行请求,前面可以带“好的,”“可以,”这类简短应答;单独回答“好”或“yes”、
只提到任务、引用或条件句都不会启动付费运行。如果已有一次运行在排队等待开始,
就不会再添加试运行,智能体会说明这一点。试运行不计入 `max_runs`。
一次目标执行最多包含九轮智能体回合,每轮后可以有一次评估器请求。运行用量
包含评估器请求及服务商返回的 token;缺少用量时,对应费用估算为未知。
`token_budget` 限制主图,并在模型调用后检查;评估器用量另行计入,因此它
不是严格的整个运行用量上限,也不是金额上限。
**目标评估升级:** 现有 scheduled、webhook、autonomous 模式的目标运行可以
接受已声明的低风险、可逆假设,并将 `relied_on_assumption` 记录到评估结果。
交互式目标评估仍保持严格。即使未启用对话调度工具,此策略也适用;它不授予
敏感操作权限,也不代替用户授权。
定时任务运行会读取 `config.yaml` 中的 `scheduler.recursion_limit`(默认 `1000`,与 Web UI 的交互式预算一致)。超过 `max_recursion_limit` 的值会被截断。该字段在 dispatch 时读取,因此下一次定时运行即可生效,无需重启 Gateway。
后台调度器默认是单实例。多 Pod 部署时,请设置 `scheduler.multi_instance: true`,并使用共享 Postgres、`run_ownership.heartbeat_enabled: true` 和 `run_events.backend: db`;启动和周期性恢复会保留仍由对端持有的运行,把过期的 launch claim 原子退回队列,只接管过期的 run lease,并隔离过期的 launch 写入。`max_concurrent_runs` 是跨 Pod 共享的全局上限,只计入 `launching` / `running` 的执行;等待中的 `queued` 行不占用该配额。没有这些配置时,请只在一个 Gateway Pod 上启用调度器。这些 scheduler 字段只在启动时生效;修改后需要一起重启所有 Gateway Pod。
### 通过 API 预览 cron 执行时间
已认证且具有 `threads:read` 权限的客户端,可在创建任务前调用 `POST /api/scheduled-tasks/preview-cron`:
```json
{"cron":"0 9 * * 1-5","timezone":"Asia/Shanghai","count":3,"start_at":"2026-09-12T00:00:00Z"}
```
响应包含规范化的 `cron`、`timezone`、生效的 UTC `start_at`,以及 `occurrences` 列表中的 UTC `run_at` 和带偏移量的 `local_time`。此例的首次执行时间为 `2026-09-14T01:00:00Z` / `2026-09-14T09:00:00+08:00`。
`count` 为 1–10 的整数,默认 5。`start_at` 必须带时区,省略时只读取一次服务器当前时间。cron 沿用调度器的五字段语法,最长 256 字符;时区名称最长 128 字符。输入无效或无法计算所需未来时间时返回 422。预览沿用实际调度器的夏令时语义,不创建任务、thread 或 run,也不预留执行资源。此能力目前通过 API 提供,workspace 表单尚未展示这些时间。
### 升级说明
- 升级 `GATEWAY_WORKERS > 1` 且 `scheduler.enabled: true` 的部署前,要么只在一个 Gateway worker 上启用调度器,要么配置 `scheduler.multi_instance: true`,并同时使用共享 Postgres、`run_ownership.heartbeat_enabled: true` 和 `run_events.backend: db`。升级后的 Gateway 会在启动时拒绝这种不安全组合,而不是静默启动。
- 多实例模式下,`scheduler.max_concurrent_runs` 是集群级执行上限,而不是每个 Pod 各自一份。它计入 `launching` 和 `running` 的定时执行,因此容量不会随副本数倍增;持久化等待行仍在上限之外。
- `scheduler.multi_instance` 以及相关的 scheduler、ownership、run-event 设置都只在启动时生效。变更需要协调重启所有 Gateway Pod;只改 ConfigMap 不会启用多实例恢复。
## 终端工作台 (TUI)
`deerflow` 是一个面向终端用户的工作台,**内嵌**运行在 `DeerFlowClient` 之上——无需启动 Gateway、前端、nginx 或 Docker,同时沿用与 DeerFlow 其它部分相同的 `config.yaml`、checkpointer、技能、记忆、MCP 和沙箱配置。

```bash
uv pip install 'deerflow-harness[tui]' # 可选的 'textual' 依赖
deerflow # 启动终端 UI(需要 TTY)
deerflow --continue # 恢复最近一次会话
deerflow --resume THREAD # 按 id 恢复指定会话
deerflow --print "总结一下这个仓库" # 无头模式,结果打印到 stdout
deerflow --json "hello" # 无头模式,输出按行分隔的 StreamEvent
```
键盘驱动的对话界面:流式渲染的对话区(回答按 Markdown 渲染)、紧凑的工具活动卡片、`/` 斜杠命令面板、`/model` 与 `/threads` 选择器、输入历史,以及 `Esc` / `Ctrl+C` 打断。在 TUI 里开启的会话也会出现在 Web UI 侧边栏——它会以本地默认用户身份写入共享的会话存储,因此终端与网页保持同步,**无需运行 Gateway**。
完整说明见 [backend/docs/TUI.md](backend/docs/TUI.md)。
## 文档
- [贡献指南](CONTRIBUTING.md) - 开发环境搭建与协作流程
- [配置指南](backend/docs/CONFIGURATION.md) - 安装与配置说明
- [架构概览](backend/CLAUDE.md) - 技术架构说明
- [后端架构](backend/README.md) - 后端架构与 API 参考
## ⚠️ 安全使用
### 不恰当的部署可能导致安全风险
DeerFlow 具备**系统指令执行、资源操作、业务逻辑调用**等关键高权限能力,默认设计为**部署在本地可信环境(仅本机 127.0.0.1 回环访问)**。若您将 agent 部署至不可信局域网、公网云服务器等可被多终端访问的网络环境,且未采取严格的安全防护措施,可能导致安全风险,例如:
- **未授权的非法调用**:agent 功能被未授权的第三方、公网恶意扫描程序探测到,进而发起批量非法调用请求,执行系统命令、文件读写等高危操作,可能导致安全后果。
- **合规与法律风险**:若 agent 被非法调用用于实施网络攻击、信息窃取等违法违规行为,可能面临法律责任与合规风险。
### Gateway 管理员权限等同于代码执行
管理员可以注册 stdio 类型的 MCP server,其命令会在 Gateway 容器内执行。API 会将可执行命令限制在允许清单内(默认为 `npx`、`uvx`,可通过 `DEER_FLOW_MCP_STDIO_COMMAND_ALLOWLIST` 扩展),并拒绝会导致任意代码求值的参数与环境变量。这属于纵深防御,而不是安全边界:这类启动器本身的用途就是拉取并运行远程包,因此请**将 Gateway 管理员权限视为等同于在宿主机上执行代码**,并据此谨慎授权。
### 外部聊天消息角色 (External Chat Message Roles)
Gateway 的 run 请求与手动线程状态更新会拒绝客户端提交的 `system` / `developer` 消息,并返回 HTTP 400,包括等价的序列化消息形式。普通聊天、附件以及 assistant/tool 历史回放仍然受支持。Session 或 PAT 认证并不会授予 system-prompt 权限;受信任的内部 run 生产者保留这一权限。
这一检查用于阻止新的角色注入;它不会重写已有的 checkpoint。如果旧版本接受了一条注入的 system 消息,请使用全新的线程,或让操作人员审查并清理受影响的状态。重启服务不会移除已持久化的指令,而恢复旧的 checkpoint 可能会把它们一并恢复。
本地验证可运行 `python backend/tests/poc_external_system_message_injection.py --help`。这个可选的 PoC 在隔离的旧版本上支持 `--expect vulnerable`,在修复后支持 `--expect blocked`。其帮助信息包含 PAT 创建、thread-ID 选择、浏览器后续操作,以及持久化与模型遵循之间的区别。每次运行请使用一个全新的一次性线程;该测试会追加消息。
在隔离的未修复检出上,`--expect vulnerable` 仅在请求返回 200、且注入的确切消息在正常后续对话后仍以 `type=system` 保留在 checkpoint 中时,才演示“被接受”。网页回答中的标记取决于模型本身,并不能证明角色已被提升。应用修复后,用 `--expect blocked` 运行同一脚本:它要求出现特定的角色拒绝 400、checkpoint 保持不变、一次成功的普通后续对话,并且被拒绝的消息 ID 不再存在。其他 400 响应、认证、冲突或服务器错误均属无法得出结论的情况,而非通过。
PoC 不会自动清理。验证完成后,请用网页侧边栏的删除操作删除该一次性聊天,并在创建了短期 PAT 的情况下吊销它。重启服务不会移除一条已持久化的注入指令。
### 部署默认值
Docker 部署栈默认只把入口端口发布在 `127.0.0.1` 上,与上文所述的本地可信环境模型一致。若需要从其他机器访问,请在 `.env` 中设置 `BIND_HOST`(例如 `BIND_HOST=0.0.0.0`),并且必须在落实下方的安全措施之后再这样做。
**请在主机变为可访问之前完成首次初始化设置。** 全新实例尚未创建任何账号,因此对于任何非仅回环访问的部署,请在启动后立即通过 `/setup` 创建管理员账号。
### 安全使用建议
**注意:建议您将 DeerFlow 部署在本地可信的网络环境下。** 若您有跨设备、跨网络的部署需求,必须加入严格的安全措施。例如,采取如下手段:
- **设置访问 IP 白名单**:使用 `iptables`,或部署硬件防火墙 / 带访问控制(ACL)功能的交换机等,**配置规则设置 IP 白名单**,拒绝其他所有 IP 进行访问。
- **前置身份验证**:配置反向代理(nginx 等),并**开启高强度的前置身份验证功能**,禁止无任何身份验证的访问。
- **网络隔离**:若有可能,建议将 agent 和可信设备划分到**同一个专用 VLAN**,与其他网络设备做隔离。
- **持续关注项目更新**:请持续关注 DeerFlow 项目的安全功能更新。
## 参与贡献
欢迎参与贡献。开发环境、工作流和相关规范见 [CONTRIBUTING.md](CONTRIBUTING.md)。
目前回归测试已经覆盖 Docker sandbox 模式识别,以及 `backend/tests/` 中 provisioner kubeconfig-path 处理相关测试。
## 许可证
本项目采用 [MIT License](./LICENSE) 开源发布。
## 致谢
DeerFlow 建立在开源社区大量优秀工作的基础上。所有让 DeerFlow 成为可能的项目和贡献者,我们都心怀感谢。毫不夸张地说,我们是站在巨人的肩膀上继续往前走。
特别感谢以下项目带来的关键支持:
- **[LangChain](https://github.com/langchain-ai/langchain)**:它提供的优秀框架支撑了我们的 LLM 交互与 chains,让整体集成和能力编排顺畅可用。
- **[LangGraph](https://github.com/langchain-ai/langgraph)**:它在多 agent 编排上的创新方式,是 DeerFlow 复杂工作流得以成立的重要基础。
这些项目体现了开源协作真正的力量,我们也很高兴能继续在此基础上建立。
### 核心贡献者
感谢 `DeerFlow` 的核心作者,是他们的判断、投入和持续推进,才让这个项目真正落地:
- **[Daniel Walnut](https://github.com/hetaoBackend/)**
- **[Henry Li](https://github.com/magiccube/)**
## Star History
[](https://star-history.dera.page/#bytedance/deer-flow&Date)