# yovoice
**Repository Path**: hantea/yovoice
## Basic Information
- **Project Name**: yovoice
- **Description**: yovoice 是一个开源的本地 AI 音频与音乐工作室,支持 macOS 与 Windows,把音色复刻、情绪调节、文稿配音与歌曲创作放进一个本地工作区,语音与音频全部在本地生成
- **Primary Language**: Unknown
- **License**: Apache-2.0
- **Default Branch**: main
- **Homepage**: https://www.oschina.net/p/yovoice
- **GVP Project**: No
## Statistics
- **Stars**: 0
- **Forks**: 1
- **Created**: 2026-10-15
- **Last Updated**: 2026-10-15
## Categories & Tags
**Categories**: Uncategorized
**Tags**: None
## README

yovoice
让文字拥有你的声音,让创意谱成完整乐章。


English · 简体中文
官方网站 · CLI 与 Agent Skill · API / MCP 部署 · 开发指南
---
yovoice 是一款适用于 macOS 和 Windows 的开源、本地优先(Local-first)声音与音乐创作工作台。
在本地将文字转化为自然逼真的语音、整首带人声歌曲或多轨乐谱。支持零样本音色克隆、情绪风格控制、带歌词人声的 AI 音乐生成、多轨 MIDI 编曲渲染与音频工程管理。**完全在本地运行,无云端 API 调用,无按字/按秒扣费开销,无需复杂的 Python 环境配置**,让旁白、配音、有声内容与音乐创作更自主、更私密、更低成本。

---
## 为什么选择 yovoice?
- 🔒 **100% 本地离线与数据隐私**:所有模型均在本地显卡/CPU 推理,文本稿件和声音样本永远不会上传到第三方云端。
- 💸 **零按字/按秒扣费**:无需订阅昂贵的云端 API(告别 ElevenLabs、Suno、商用配音会员计费)。
- ⚡ **原生 C++ 极速引擎,免配 Python**:基于 [audio.cpp](https://github.com/0xShug0/audio.cpp) v0.9.1 原生构建,支持 macOS Metal 与 Windows NVIDIA CUDA 12.4/13.3 开箱即用,告别 Conda 与 PyTorch 依赖地狱。
- 🎛️ **全流程专业创作流**:多版本试听对比(Takes)、多轨时间轴吸附裁剪、General MIDI 音色库本地渲染与分轨导出(Stems)。
- 🤖 **原生 MCP 与 AI Agent 协创**:支持接入 DeepSeek、通义千问、Claude、OpenAI 或本地 Ollama 自动写歌写谱,并提供 Model Context Protocol (MCP) 服务,支持在 Cursor 或 Claude Code 中直接调用。
---
## 功能
- **音色与表达** — 跟随参考音色、模仿参考演绎、调整情绪,或用文字描述想要的表达方式。
- **完整音频流程** — 导入或录制参考音频、裁剪片段、试听语音、导出作品。
- **声音设计与克隆** — VoxCPM2 支持文字设计音色、带风格指导的克隆及参考原文辅助的精细克隆,自动多语言、48 kHz 输出。
- **音乐生成** — 描述风格、写下带段落标记的歌词,用 ACE-Step 1.5 生成整首歌曲或纯音乐,每次生成都保留为可对比的版本。
- **编曲** — 按小节和拍写下每个声部,或导入 MIDI、交给 Agent 写谱,用 General MIDI 音色库渲染并按角色对齐电平混音;结果可精确复现,可导出 MIDI 和分轨。详见[编曲](docs/score_zh.md)。
- **可选 AI 服务** — 接入 DeepSeek、通义千问、Kimi、OpenAI、Anthropic、Ollama 或任意兼容接口,让 AI 写谱、写歌词;密钥只保存在本机。详见[AI 服务](docs/ai_zh.md)。
- **本地模型** — 通过 audio.cpp 运行 IndexTTS 2.0 / 2.5、VoxCPM2、OmniVoice、Qwen3-TTS、Breeze TTS 2 和 Kokoro,支持模型下载续传与 GGUF 导入。
- **硬件加速** — Apple Silicon 支持 Metal;Windows 支持 CPU、NVIDIA CUDA 和实验性 Vulkan。
- **Agent Skill & MCP** — 让 AI Agent 准备本地语音生成环境,根据文稿和参考音频完成配音。
---
## 硬件配置速查指引
| 创作场景 | 推荐配置 | 适用模型推荐 |
| --- | --- | --- |
| 🟢 **轻量极速朗读与旁白** | 任何 CPU / 4GB+ 内存 | **Kokoro-82M** (Q8 仅 189 MB,毫秒级合成,纯 CPU 也能飞快运行) |
| 🟡 **高音质克隆与声音设计** | 4GB ~ 6GB 显存 / Apple Silicon 8GB+ | **VoxCPM2** (2B, 48kHz)、**IndexTTS 2.0/2.5**、**Qwen3-TTS** |
| 🔴 **整首歌生成与伴奏演奏** | 12GB+ 显存 / Apple Silicon 16GB+ | **ACE-Step 1.5 Turbo** (BF16, 10GB)、**YuE2 3B** |
---
## 支持模型
| 模型 | 参数量 | 模型文件大小(按精度) | 核心能力 |
| --- | --- | --- | --- |
| IndexTTS 2.0 | — | Q8 · 3.63 GB
F16 · 4.65 GB
ORIG · 8.08 GB | 中英音色克隆、情绪控制、参考演绎 |
| IndexTTS 2.5 | — | Q8 · 3.50 GB
F16 · 4.55 GB
ORIG · 7.89 GB | 多语言音色克隆、情绪控制、发音调整 |
| VoxCPM2 | 2B | Q8 · 2.96 GB
BF16 · 4.77 GB
ORIG · 4.96 GB | 文字设计音色、音色克隆、参考原文辅助的精细克隆 |
| OmniVoice | 0.6B | Q8 · 1.35 GB
BF16 · 1.64 GB
F16 · 1.64 GB | 属性设计音色、音色克隆、非语言声音标签 |
| Qwen3-TTS Base | 0.6B | Q8 · 1.99 GB
BF16 · 2.52 GB | 参考音色克隆、可选原文辅助、多语言生成 |
| Qwen3-TTS Base | 1.7B | Q8 · 2.70 GB
BF16 · 4.20 GB
ORIG · 4.54 GB | 参考音色克隆、可选原文辅助、多语言生成 |
| Qwen3-TTS CustomVoice | 1.7B | Q8 · 2.82 GB
BF16 · 4.18 GB | 9 种内置音色、文字控制风格与情绪 |
| Qwen3-TTS VoiceDesign | 1.7B | Q8 · 2.82 GB
BF16 · 4.18 GB | 自然语言描述设计音色,无需参考音频 |
| Breeze TTS 2 | 约 3B | Q4 · 3.79 GB
Q8 · 5.08 GB
BF16 · 7.34 GB | 中英自然语言设计音色、音色克隆与演绎指导;建议使用显卡,需要 v0.9.1 内核 |
| Kokoro-82M 1.0 Official | 82M | Q8 · 189.55 MB
BF16 · 211.95 MB | 49 种内置音色、多语言生成,不含日语 |
| Kokoro-82M 1.0 | 82M | Q8 · 932.66 MB | 54 种内置音色、包含日语的完整多语言资源;仅支持导入 |
| Kokoro-82M 1.1-zh | 82M | Q8 · 255.32 MB | 100 种中文音色及 3 种英文音色;实验性,仅支持导入 |
| ACE-Step 1.5 Turbo | — | BF16 · 10.09 GB | 根据风格描述和歌词生成歌曲或纯音乐,支持 50 多种演唱语言;需要 v0.9.1 内核 |
App 与 CLI 均支持以上模型,输入要求与示例见[模型选择](docs/models_zh.md)。OmniVoice 权重采用 CC-BY-NC 许可,Breeze TTS 2 权重采用 BreezeBlue 研究与非商业许可,均仅限非商业用途。
---
## 安装
在仓库的 [Releases](../../releases) 页面选择对应平台的安装包,或访问[官方网站](https://yovoice.leemysw.com)。
| 平台 | 安装包 | 安装方式 |
| --- | --- | --- |
| macOS 14+ · Apple Silicon | `.dmg` | 打开磁盘映像,将 yovoice 拖入 Applications |
| Windows 10/11 · x64 | `-setup.exe` | 运行安装向导,安装后从开始菜单打开 |
| Windows 10/11 · x64 · NVIDIA 显卡 | `-cuda12.4-setup.exe` | 内置 CUDA 12.4 内核,兼容较旧的显卡与驱动,首次启动即用 GPU |
| Windows 10/11 · x64 · NVIDIA 显卡 | `-cuda13.3-setup.exe` | 内置 CUDA 13.3 内核,需要较新的驱动,安装包更小 |
Windows 安装器会在缺少时联网安装 [WebView2 Runtime](https://developer.microsoft.com/microsoft-edge/webview2/)。模型在应用内下载。卸载应用保留 `~/.yovoice` 中的作品和模型。
macOS 和 Windows 均支持在应用菜单中检查更新,也会自动检查并后台下载;下载完成后可选择重启安装。Windows 自动更新只下载应用本体(`-update.exe`),保留已安装的内核;新版本推荐更高的内核时,可在 设置 → 推理引擎 中选择升级。

---
## 快速上手
1. **准备模型。** 在设置中下载所需模型(例如轻量朗读用 Kokoro-82M,声音克隆用 VoxCPM2)。
2. **新建作品。** 选择“故事配音”、“语音生成”、“音乐生成”或“编曲”。
3. **填写内容。** 输入文字、歌词或音符,选择角色并调整风格。
4. **生成音频。** 点击“生成”,试听对比多版本(Takes)、编辑并导出。
---
## CLI 与 Agent Skill
将 [yovoice Skill](https://github.com/leemysw/yovoice/tree/main/skills/yovoice) 链接发给 Agent,让它安装 Skill,并准备本地 CLI、引擎和模型:
> 安装这个 Skill,并帮我配置好 yovoice 本地语音生成环境:https://github.com/leemysw/yovoice/tree/main/skills/yovoice
之后直接描述需求:
> 用 voice.wav 的音色朗读 narration.txt,语气平静,保存为 narration.wav。
Agent 通过独立 CLI 完成配音,无需打开桌面应用。详细用法见 [CLI 指南](docs/cli_zh.md)。
---
运行 `yovoice serve` 可为其他机器提供带认证的 HTTP API 与 MCP 推理服务,支持上传参考音频与生成 WAV。部署和调用示例见[API / MCP 部署指南](docs/api_zh.md)。
## 开发
```sh
make install
make app-run
```
环境要求见[开发指南](docs/development_zh.md),其中也介绍了浏览器预览、测试和项目结构。
---
## 参与贡献
欢迎提交问题、功能建议和 Pull Request。报告问题时,请附上操作系统、模型及复现步骤;提交代码前运行 `make check`。
---
## 鸣谢
- [audio.cpp](https://github.com/0xShug0/audio.cpp) — ShugoAI 开发的本地音频推理引擎。
- [VoxCPM](https://github.com/OpenBMB/VoxCPM) — 声音设计与克隆模型,Apache-2.0 许可。
- [IndexTTS](https://github.com/index-tts/index-tts) — 为 yovoice 提供语音合成模型。
- [OmniVoice](https://github.com/k2-fsa/OmniVoice) — 声音设计与音色克隆模型。
- [Qwen3-TTS](https://github.com/QwenLM/Qwen3-TTS) — 支持音色克隆、内置音色与文字设计声音。
- [ACE-Step](https://github.com/ace-step/ACE-Step-1.5) — 根据风格描述与歌词生成音乐。
- [go-meltysynth](https://github.com/sinshu/go-meltysynth)、[MuseScore General](https://musescore.org/en/handbook/3/soundfonts-and-sfz-files#gm_soundfonts)、[GeneralUser GS](https://www.schristiancollins.com/generaluser) 与 David Shan 的 SGM-V2.01 — 编曲渲染使用的 SoundFont 合成器与音色库。
- Kokoro — 使用内置音色的轻量语音合成模型:[Kokoro-82M](https://huggingface.co/hexgrad/Kokoro-82M) 与 [Kokoro-82M-v1.1-zh](https://huggingface.co/hexgrad/Kokoro-82M-v1.1-zh)。
---
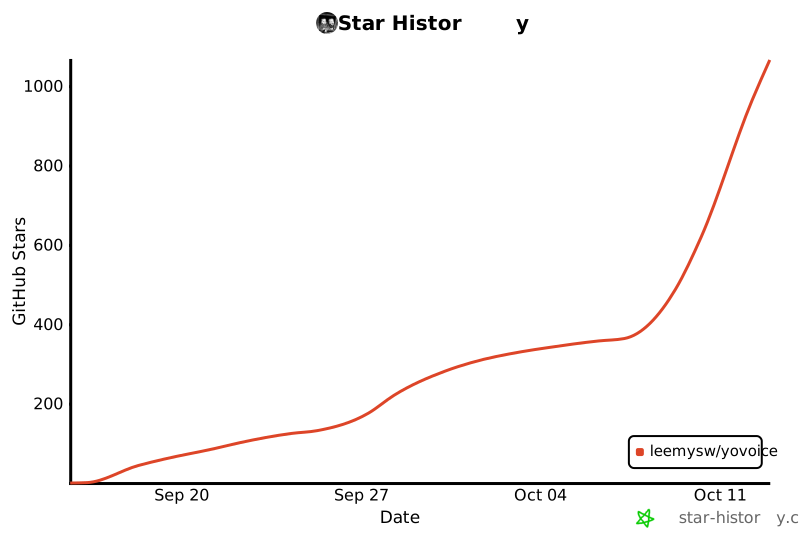
## Star History
 ---
## 开源协议
[Apache-2.0](LICENSE)。依赖组件保留[各自的许可证](THIRD_PARTY_NOTICES.md),IndexTTS 模型单独遵循其[模型使用许可协议](web/public/model-license.txt)。