# LLMs-from-scratch
**Repository Path**: rickqi/LLMs-from-scratch
## Basic Information
- **Project Name**: LLMs-from-scratch
- **Description**: Implement a ChatGPT-like LLM in PyTorch from scratch, step by step
- **Primary Language**: Unknown
- **License**: Apache-2.0
- **Default Branch**: main
- **Homepage**: None
- **GVP Project**: No
## Statistics
- **Stars**: 0
- **Forks**: 0
- **Created**: 2026-09-26
- **Last Updated**: 2026-10-22
## Categories & Tags
**Categories**: Uncategorized
**Tags**: None
## README
# 从零构建大型语言模型(Build a Large Language Model From Scratch)
本仓库包含了开发、预训练和微调一个类 GPT 大型语言模型的完整代码,是书籍 [*Build a Large Language Model (From Scratch)*](https://amzn.to/4fqvn0D) 的官方代码仓库。
在 [*Build a Large Language Model (From Scratch)*](http://mng.bz/orYv) 一书中,你将通过从零开始、一步一步编码的方式,深入理解大型语言模型(LLM)的内部工作原理。本书将通过清晰的文字、图表和示例,引导你创建自己的 LLM。
本书所描述的训练和开发小型但功能完整的教育用途模型的方法,与创建 ChatGPT 背后的大规模基础模型所使用的方法一脉相承。此外,本书还包含加载更大预训练模型权重进行微调的代码。
- 官方[源代码仓库](https://github.com/rasbt/LLMs-from-scratch)
- [Manning 出版社链接](http://mng.bz/orYv)
- [Amazon 购买链接](https://www.amazon.com/gp/product/1633437167)
- ISBN 9781633437166
下载本仓库,请点击 [Download ZIP](https://github.com/rasbt/LLMs-from-scratch/archive/refs/heads/main.zip) 按钮,或在终端执行以下命令:
```bash
git clone --depth 1 https://github.com/rasbt/LLMs-from-scratch.git
```
(如果你是从 Manning 网站下载的代码包,建议访问 GitHub 上的官方代码仓库 [https://github.com/rasbt/LLMs-from-scratch](https://github.com/rasbt/LLMs-from-scratch) 获取最新更新。)
## 目录
> **提示:**
> 如果你需要 Python 和 Python 包的安装指导以及代码环境配置,请阅读 [setup](setup) 目录下的 [README.md](setup/README.md) 文件。
[](https://github.com/rasbt/LLMs-from-scratch/actions/workflows/basic-tests-linux-uv.yml)
[](https://github.com/rasbt/LLMs-from-scratch/actions/workflows/basic-tests-windows-uv-pip.yml)
[](https://github.com/rasbt/LLMs-from-scratch/actions/workflows/basic-tests-macos-uv.yml)
- [常见问题排查指南](./troubleshooting.md)
| 章节 | 主要内容 | 主代码(快速访问) | 全部代码 + 补充材料 |
|------|---------|-------------------|---------------------|
| [环境配置建议](setup) | Python 环境搭建 | - | - |
| 第 1 章:理解大型语言模型 | LLM 概念介绍 | 无代码 | - |
| 第 2 章:处理文本数据 | 分词(Tokenization)、嵌入(Embedding)、数据加载 | [ch02.ipynb](ch02/01_main-chapter-code/ch02.ipynb) | [./ch02](./ch02) |
| 第 3 章:编码注意力机制 | 多头注意力(Multi-Head Attention)、因果掩码 | [ch03.ipynb](ch03/01_main-chapter-code/ch03.ipynb) | [./ch03](./ch03) |
| 第 4 章:从零实现 GPT 模型 | Transformer 模块、GPT 架构 | [ch04.ipynb](ch04/01_main-chapter-code/ch04.ipynb) / [gpt.py](ch04/01_main-chapter-code/gpt.py) | [./ch04](./ch04) |
| 第 5 章:在无标签数据上预训练 | 训练循环、权重加载、文本生成 | [ch05.ipynb](ch05/01_main-chapter-code/ch05.ipynb) / [gpt_train.py](ch05/01_main-chapter-code/gpt_train.py) | [./ch05](./ch05) |
| 第 6 章:文本分类微调 | 分类微调、垃圾邮件检测 | [ch06.ipynb](ch06/01_main-chapter-code/ch06.ipynb) | [./ch06](./ch06) |
| 第 7 章:指令跟随微调 | 指令微调、模型评估 | [ch07.ipynb](ch07/01_main-chapter-code/ch07.ipynb) | [./ch07](./ch07) |
| 附录 A:PyTorch 入门 | PyTorch 基础、分布式训练 | [code-part1.ipynb](appendix-A/01_main-chapter-code/code-part1.ipynb) | [./appendix-A](./appendix-A) |
| 附录 B:参考文献与扩展阅读 | 参考资料 | 无代码 | [./appendix-B](./appendix-B) |
| 附录 C:练习解答 | 各章节练习题答案 | [练习解答列表](appendix-C) | [./appendix-C](./appendix-C) |
| 附录 D:训练循环增强功能 | 学习率调度器、梯度裁剪等 | [appendix-D.ipynb](appendix-D/01_main-chapter-code/appendix-D.ipynb) | [./appendix-D](./appendix-D) |
| 附录 E:使用 LoRA 进行参数高效微调 | LoRA 微调技术 | [appendix-E.ipynb](appendix-E/01_main-chapter-code/appendix-E.ipynb) | [./appendix-E](./appendix-E) |
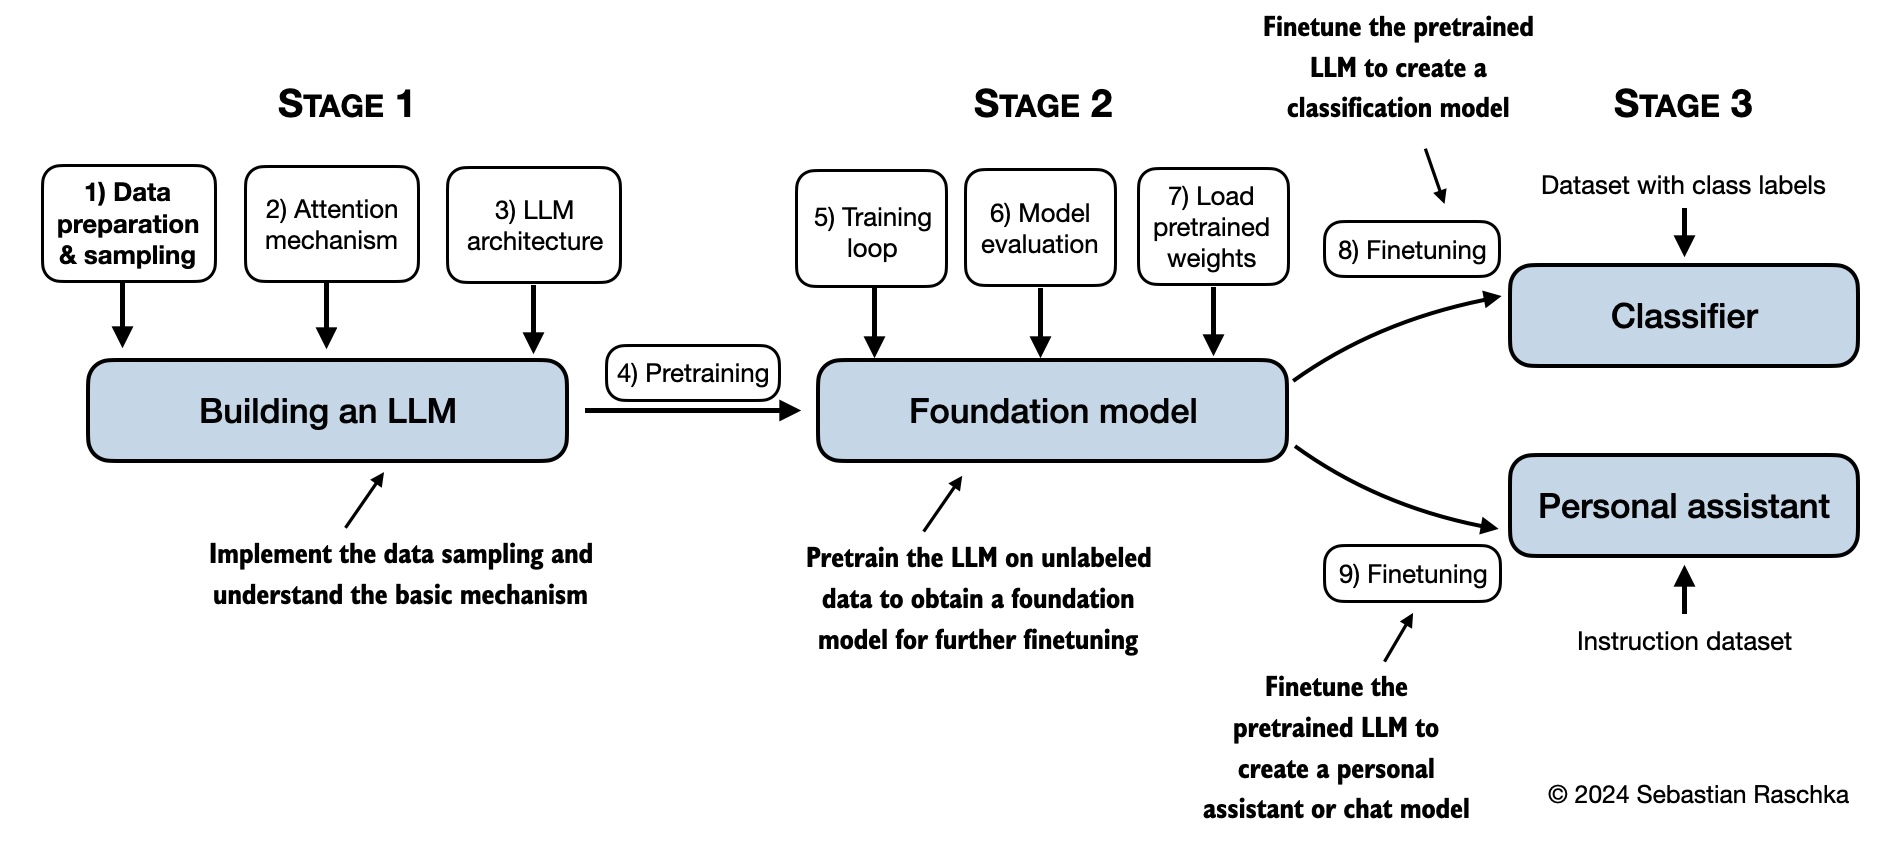
以下思维导图总结了本书所涵盖的内容:
## 前置知识要求
最重要的前置条件是扎实的 **Python 编程基础**。有了这个基础,你将能够很好地探索 LLM 的迷人世界,并理解本书中介绍的概念和代码示例。
如果你有一些深度神经网络的实践经验,可能会发现某些概念更加熟悉,因为 LLM 正是建立在深度神经网络架构之上的。
本书使用 **PyTorch** 从零实现代码,不使用任何外部 LLM 库。虽然不需要精通 PyTorch,但熟悉 PyTorch 基础知识肯定会有所帮助。如果你是 PyTorch 新手,附录 A 提供了 PyTorch 的简明入门。此外,你可能会发现我的另一本书 [*PyTorch in One Hour: From Tensors to Training Neural Networks on Multiple GPUs*](https://sebastianraschka.com/teaching/pytorch-1h/) 对学习 PyTorch 核心概念很有帮助。
## 硬件要求
本书主章节的代码设计为可在普通笔记本电脑上在合理时间内运行,不需要专门的硬件。这一设计确保广大读者都能学习这些内容。此外,如果有 GPU 可用,代码会自动利用 GPU 加速。(请参阅[环境配置](https://github.com/rasbt/LLMs-from-scratch/blob/main/setup/README.md)文档获取更多建议。)
## 视频课程
[17小时15分钟的配套视频课程](https://www.manning.com/livevideo/master-and-build-large-language-models),我在其中逐章编码演示了书中的每个章节。课程按照书本的章节和结构组织,既可以作为书本的独立替代品,也可以作为互补的跟练资源。

## 姊妹篇 / 续作
[*Build A Reasoning Model (From Scratch)*](https://mng.bz/lZ5B) 虽然是一本独立的书,但可以看作是 *Build A Large Language Model (From Scratch)* 的续作。
它从一个预训练模型出发,实现了不同的推理方法,包括**推理时扩展(Inference-time Scaling)**、**强化学习(Reinforcement Learning)**和**蒸馏(Distillation)**,以提升模型的推理能力。
与本书类似,[*Build A Reasoning Model (From Scratch)*](https://mng.bz/lZ5B) 也采用从零实现的动手实践方式。
 - [Manning 链接](https://mng.bz/lZ5B)
- [GitHub 仓库](https://github.com/rasbt/reasoning-from-scratch)
## 练习题
本书每章都包含多个练习题。答案汇总在附录 C 中,相应的代码 notebook 可在本仓库各章文件夹中找到(例如 [./ch02/01_main-chapter-code/exercise-solutions.ipynb](./ch02/01_main-chapter-code/exercise-solutions.ipynb))。
除了代码练习外,你还可以从 Manning 网站免费下载一本 170 页的 PDF —— [*Test Yourself On Build a Large Language Model (From Scratch)*](https://www.manning.com/books/test-yourself-on-build-a-large-language-model-from-scratch),其中包含每章约 30 道测验题及解答,帮助你检验学习成果。

## 额外补充材料
多个文件夹中包含面向有兴趣读者的可选补充材料:
### 环境配置(Setup)
- [Python 环境配置技巧](setup/01_optional-python-setup-preferences)
- [安装本书使用的 Python 包和库](setup/02_installing-python-libraries)
- [Docker 环境配置指南](setup/03_optional-docker-environment)
### 第 2 章:处理文本数据
- [从零实现 BPE(Byte Pair Encoding)分词器](ch02/05_bpe-from-scratch/bpe-from-scratch-simple.ipynb)
- [比较不同的 BPE 实现](ch02/02_bonus_bytepair-encoder)
- [理解嵌入层与线性层的区别](ch02/03_bonus_embedding-vs-matmul)
- [数据加载器直觉理解](ch02/04_bonus_dataloader-intuition)
### 第 3 章:编码注意力机制
- [比较高效多头注意力实现](ch03/02_bonus_efficient-multihead-attention/mha-implementations.ipynb)
- [理解 PyTorch Buffers](ch03/03_understanding-buffers/understanding-buffers.ipynb)
### 第 4 章:从零实现 GPT 模型
- [FLOPs 分析(浮点运算量分析)](ch04/02_performance-analysis/flops-analysis.ipynb)
- [KV 缓存(KV Cache)](ch04/03_kv-cache)
- **注意力机制的替代方案**:
- [分组查询注意力(Grouped-Query Attention, GQA)](ch04/04_gqa) — Llama、Qwen、Gemma 等主流模型使用
- [多头潜在注意力(Multi-Head Latent Attention, MLA)](ch04/05_mla) — DeepSeek V3 使用
- [滑动窗口注意力(Sliding Window Attention, SWA)](ch04/06_swa) — Gemma 3 使用
- [门控 DeltaNet(Gated DeltaNet)](ch04/08_deltanet) — 线性注意力变体,Qwen3-Next 使用
- [DeepSeek 稀疏注意力(DSA)](ch04/09_dsa)
- [跨层 KV 共享(Cross-Layer KV Sharing)](ch04/10_kv-sharing) — Gemma 4 使用
- [混合专家模型(Mixture-of-Experts, MoE)](ch04/07_moe)
### 第 5 章:在无标签数据上预训练
- [替代权重加载方法](ch05/02_alternative_weight_loading/)
- [在 Project Gutenberg 数据集上预训练 GPT](ch05/03_bonus_pretraining_on_gutenberg)
- [训练循环增强功能](ch05/04_learning_rate_schedulers)(学习率调度器、梯度裁剪)
- [预训练超参数优化](ch05/05_bonus_hparam_tuning)
- [构建用户界面与预训练 LLM 交互](ch05/06_user_interface)
- [将 GPT 转换为 Llama 架构](ch05/07_gpt_to_llama)
- [内存高效的模型权重加载](ch05/08_memory_efficient_weight_loading/memory-efficient-state-dict.ipynb)
- [扩展 Tiktoken BPE 分词器](ch05/09_extending-tokenizers/extend-tiktoken.ipynb)
- [PyTorch 性能优化技巧加速 LLM 训练](ch05/10_llm-training-speed)
- **从零实现各主流 LLM 架构**:
- [Llama 3.2 从零实现](ch05/07_gpt_to_llama/standalone-llama32.ipynb)
- [Qwen3(稠密版和 MoE 版)从零实现](ch05/11_qwen3/)
- [Gemma 3 从零实现](ch05/12_gemma3/)
- [Olmo 3 从零实现](ch05/13_olmo3/)
- [Tiny Aya 从零实现](ch05/15_tiny-aya/)
- [Qwen3.5 从零实现](ch05/16_qwen3.5/)
- [Gemma 4 E2B 和 E4B 从零实现](ch05/17_gemma4/)
- [使用其他 LLM(如 Llama 3, Qwen 3)替换 GPT 进行第 5 章实验](ch05/14_ch05_with_other_llms/)
### 第 6 章:文本分类微调
- [微调不同层和使用更大模型的额外实验](ch06/02_bonus_additional-experiments)
- [在 5万条 IMDb 电影评论数据集上微调不同模型](ch06/03_bonus_imdb-classification)
- [构建用户界面与基于 GPT 的垃圾邮件分类器交互](ch06/04_user_interface)
### 第 7 章:指令跟随微调
- [数据集工具:查找近似重复和创建被动语态条目](ch07/02_dataset-utilities)
- [使用 OpenAI API 和 Ollama 评估指令响应](ch07/03_model-evaluation)
- [生成指令微调数据集](ch07/05_dataset-generation/llama3-ollama.ipynb)
- [改进指令微调数据集](ch07/05_dataset-generation/reflection-gpt4.ipynb)
- [使用 Llama 3.1 70B 和 Ollama 生成偏好数据集](ch07/04_preference-tuning-with-dpo/create-preference-data-ollama.ipynb)
- [LLM 对齐的直接偏好优化(DPO)](ch07/04_preference-tuning-with-dpo/dpo-from-scratch.ipynb)
- [构建用户界面与指令微调后的 GPT 模型交互](ch07/06_user_interface)
### 来自 [Reasoning From Scratch](https://github.com/rasbt/reasoning-from-scratch) 仓库的更多补充材料
- **Qwen3 从零基础入门**
- [Qwen3 源码走读](https://github.com/rasbt/reasoning-from-scratch/blob/main/chC/01_main-chapter-code/chC_main.ipynb)
- [优化版 Qwen3](https://github.com/rasbt/reasoning-from-scratch/tree/main/ch02/03_optimized-LLM)
- **模型评估**
- [基于验证器的评估(MATH-500)](https://github.com/rasbt/reasoning-from-scratch/tree/main/ch03)
- [多选题评估(MMLU)](https://github.com/rasbt/reasoning-from-scratch/blob/main/chF/02_mmlu)
- [LLM 排行榜评估](https://github.com/rasbt/reasoning-from-scratch/blob/main/chF/03_leaderboards)
- [LLM 作为裁判评估](https://github.com/rasbt/reasoning-from-scratch/blob/main/chF/04_llm-judge)
- **推理时扩展**
- [自一致性(Self-Consistency)](https://github.com/rasbt/reasoning-from-scratch/blob/main/ch04/01_main-chapter-code/ch04_main.ipynb)
- [自我优化(Self-Refinement)](https://github.com/rasbt/reasoning-from-scratch/blob/main/ch05/01_main-chapter-code/ch05_main.ipynb)
- **强化学习(RL)**
- [从零实现 RLVR with GRPO](https://github.com/rasbt/reasoning-from-scratch/blob/main/ch06/01_main-chapter-code/ch06_main.ipynb)
## 问题、反馈与贡献
欢迎各种形式的反馈,最好通过 [Manning 论坛](https://livebook.manning.com/forum?product=raschka&page=1) 或 [GitHub Discussions](https://github.com/rasbt/LLMs-from-scratch/discussions) 分享。同样,如果你有任何问题或想与他人交流想法,请不要犹豫在论坛中发帖。
请注意,由于本仓库包含与纸质书籍对应的代码,目前我无法接受会扩展主章节代码内容的贡献,因为这会导致与纸质书产生偏差。保持一致性有助于确保所有人都有顺畅的学习体验。
## 📂 实战项目
基于本书知识体系构建的 4 个独立 ML 项目,覆盖 **100% 教程知识点**:
| 项目 | 领域 | 模型 | 亮点 | 文档 |
|------|------|------|------|------|
| [**Kronos Stock**](projects/kronos-stock-predictor/) | 金融时序 | LSTM + BSQ | 波动率 RankIC=+0.58 | [详细](projects/docs/kronos-stock-predictor.md) |
| [**医疗文本**](projects/chinese-medical-text-generation/) | 医学文本 | Qwen3+LoRA+DPO | 0.7M极低资源 | [详细](projects/docs/chinese-medical-text-generation.md) |
| [**法规文本**](projects/company-regulations-training/) | 法规文本 | Qwen3+LoRA | 329行最简 | [详细](projects/docs/company-regulations-training.md) |
| [**控费ML**](projects/gbcost-insurance-ml/) | 保险理赔 | LightGBM+Optuna | Tweedie+贝叶斯 | [详细](projects/docs/gbcost-insurance-ml.md) |
> 📊 [项目总览](projects/docs/README.md) | [教程覆盖分析](projects/docs/curriculum-coverage-analysis.md) | [综合技术分析](projects/docs/comprehensive-analysis.md)
## 引用
如果你觉得本书或代码对你的研究有帮助,请考虑引用。
芝加哥格式引用:
> Raschka, Sebastian. *Build A Large Language Model (From Scratch)*. Manning, 2024. ISBN: 978-1633437166.
BibTeX 条目:
```bibtex
@book{build-llms-from-scratch-book,
author = {Sebastian Raschka},
title = {Build A Large Language Model (From Scratch)},
publisher = {Manning},
year = {2024},
isbn = {978-1633437166},
url = {https://www.manning.com/books/build-a-large-language-model-from-scratch},
github = {https://github.com/rasbt/LLMs-from-scratch}
}
```