# dsh-ears
**Repository Path**: secns/dsh-ears
## Basic Information
- **Project Name**: dsh-ears
- **Description**: No description available
- **Primary Language**: Unknown
- **License**: MIT
- **Default Branch**: master
- **Homepage**: None
- **GVP Project**: No
## Statistics
- **Stars**: 0
- **Forks**: 0
- **Created**: 2026-08-29
- **Last Updated**: 2026-09-05
## Categories & Tags
**Categories**: Uncategorized
**Tags**: None
## README

dsh-ears
一款支持润色整理的 DeepSeek Harness 语音输入插件。
简体中文 ·
English


https://github.com/user-attachments/assets/1363768e-a393-44bd-a008-1ce2055cac41
---
dsh-ears 为 DeepSeek Harness 提供语音输入与 LLM 润色整理能力。支持浏览器 Web Speech、本地 Whisper 以及主流语音识别(ASR)API 服务。
## 安装
前置依赖:[DeepSeek Harness](https://github.com/deepseek-ai/deepseek-harness) `>=0.1.2-rc.1`,以及 Node.js `^22.19.0 || >=24.0.0`。
### 通过 npm 安装
```sh
dsh plugin --profile web add dsh-ears
```
> **仍在使用 dsh 0.1.1?** dsh 0.1.2 包含破坏性更新,dsh-ears `0.3.0` 不再兼容 dsh 0.1.1。请安装 `0.3.0` 以前的插件版本:
>
> ```sh
> dsh plugin --profile web add "dsh-ears@<0.3.0"
> ```
### 从源码安装
```sh
git clone https://github.com/WizisCool/dsh-ears.git
cd dsh-ears
pnpm use:platform
pnpm install
pnpm build
dsh plugin --profile web add "$PWD"
# Windows 的 cmd 请使用 "%CD%";PowerShell 直接使用 $PWD
```
`pnpm use:platform` 将 `node_modules` 切换到当前平台的 native 依赖树(Windows / Linux 各自独立),首次克隆和跨平台切换后都需要运行。
安装完成后刷新 Web UI,输入框右侧会显示麦克风图标。
## 更新
```sh
dsh plugin --profile web add dsh-ears
```
`add` 会从 npm 拉取最新版本,任何已装版本都可以直接运行。更新后需要重启 `dsh web` 加载新的服务端代码,再刷新 Web UI;也可以在设置页的"关于"面板检查新版本。
## 卸载
```sh
dsh plugin --profile web remove dsh-ears
```
卸载后刷新 Web UI。
## 使用
1. 点击麦克风图标,或按下 `Ctrl+Shift+Space`(可在设置页更改)
2. 开始说话
3. 再次按下快捷键或点击麦克风,停止录音并开始转写
4. 开启润色后,原始转写会先写入草稿,润色完成后再更新,期间的手动编辑会被保留
5. 检查内容后手动发送
转写结果始终写入可编辑草稿,不会自动发送。如果所选后端尚未就绪,麦克风图标会变灰,悬停即可查看原因。
## 识别后端
| 后端 | 工作方式 | 需要什么 |
| --- | --- | --- |
| Web Speech | 浏览器实时识别 | 默认后端;Chromium 内核浏览器 |
| 本地 Whisper | 录音结束后本地转写 | 在设置页下载 GGML 模型 |
| [Groq](https://console.groq.com) | [Groq Whisper API](https://console.groq.com/docs/speech-text) | API key |
| [Deepgram](https://deepgram.com) | [预录音频](https://developers.deepgram.com/docs/pre-recorded-audio)或[实时音频流](https://developers.deepgram.com/docs/live-streaming-audio) | API key、模型名(如 `nova-3`) |
| [阿里云百炼](https://www.aliyun.com/product/bailian) | [DashScope 同步转写](https://help.aliyun.com/zh/model-studio/developer-reference/tongyi-qianwen-audio-api) | API key、模型名;单次最长 300 秒 |
| [腾讯云](https://cloud.tencent.com/product/asr) | [录音文件识别](https://cloud.tencent.com/document/api/1093/37823)或[实时语音识别](https://cloud.tencent.com/document/api/1093/48982) | AppID、SecretID、SecretKey、`engine_type` |
| [小米 MiMo](https://mimo.mi.com) | [语音识别 API](https://mimo.mi.com/docs/zh-CN/api/audio/Speech-Recognition),支持标准 API 或 [Token Plan](https://mimo.mi.com/docs/zh-CN/tokenplan/Token%20Plan/subscription) | API key、模型名(如 `mimo-v2.5-asr`);Token Plan 需选择区域集群 |
| [硅基流动 (CN)](https://siliconflow.cn) | [语音转写 API](https://api-docs.siliconflow.cn/docs/api/audio-transcriptions-post) | API key、模型名(如 `FunAudioLLM/SenseVoiceSmall`) |
| [火山引擎](https://www.volcengine.com/product/doubao) | [录音文件识别(大模型)](https://docs.volcengine.com/docs/6561/1354868)或[单向流式语音识别](https://docs.volcengine.com/docs/6561/2628951) | API key(新版控制台 X-Api-Key)、资源 ID |
| 自定义 OpenAI 兼容 | 发送到指定 `/audio/transcriptions` 端点 | 端点地址、API key、模型名 |
> **本地 Whisper**:基于 `@fugood/whisper.node` 本地运行 whisper.cpp,无需 Python、FFmpeg 或外部依赖。支持在设置页下载管理 GGML 模型(`tiny`(默认)至 `turbo`),并可选 `default`(自动)、`vulkan` 或 `cuda` 加速。
>
> **火山引擎**:仅支持新版控制台的 API Key(`X-Api-Key`)鉴权(不支持旧版 AppID + Access Token),可在[控制台 API Key 管理](https://console.volcengine.com/speech/new/setting/apikeys)页面获取。
## 润色
默认开启。提供方和模型都留空时使用 dsh 的默认 Agent 模型(包括默认推理设置);也可以从 dsh 已配置的模型中选择。LLM 凭据复用 dsh 现有配置。支持设置推理强度。
默认提示词会删除口头禅、修正 ASR 错字、处理自我纠正和口头列举。可在设置页自定义提示词或查看默认内容。润色失败或取消时保留原始转写。
## 设置
安装后在 Web UI 的设置页出现 dsh-ears 面板,分为四个标签页:
| 标签页 | 可配置项 |
| --- | --- |
| 常规 | 设置页显示名称、语音快捷键开关与组合键、提示音开关、最长录音时间(1–600 秒,默认 120 秒) |
| 识别 | 后端选择、语言、本地 Whisper 模型和加速方式、云服务提供方及各提供方凭据 |
| 润色 | 开关、LLM 提供方和模型、推理强度、自定义提示词(最长 4000 字) |
| 关于 | 版本号、许可证、dsh 兼容范围、检查更新 |
## 已知限制
- Web Speech 后端依赖浏览器实现,音频可能被发送到浏览器厂商的服务端处理,不是完全的本地/离线方案。
- 百炼单次录音最长 300 秒。
- Deepgram Flux 系列模型需要 Listen V2 协议,当前不支持。
- 本地 Whisper 单次音频限制 24 MB,转写超时 120 秒。
- 加速方式(`default` / `vulkan` / `cuda`)在首次 native 加载后锁定,切换需重启 `dsh web`。
## 本地开发
```sh
pnpm use:platform
pnpm install
dsh plugin --profile web add "$PWD"
# Windows 的 cmd 请使用 "%CD%";PowerShell 直接使用 $PWD
pnpm check # 类型检查
pnpm test # 运行测试
pnpm build # 构建
pnpm dev:config # 构建并生成 HMR 配置
pnpm dev:web # 启动 dsh web
```
开发时在另一个终端运行 `pnpm dev:watch` 实时重编译。
修改前端 UI 代码只需刷新浏览器;修改服务端、设置注册、Remote 或 schema 代码需重启 `dsh web` 再刷新。
## 文档
- [CHANGELOG](./CHANGELOG.md)
- [CONTRIBUTING](./CONTRIBUTING.md)
- [SECURITY](./SECURITY.md)
- [LICENSE](./LICENSE)
## License
[MIT](./LICENSE)
## 友链
- [LINUX DO](https://linux.do) — 新的理想型社区
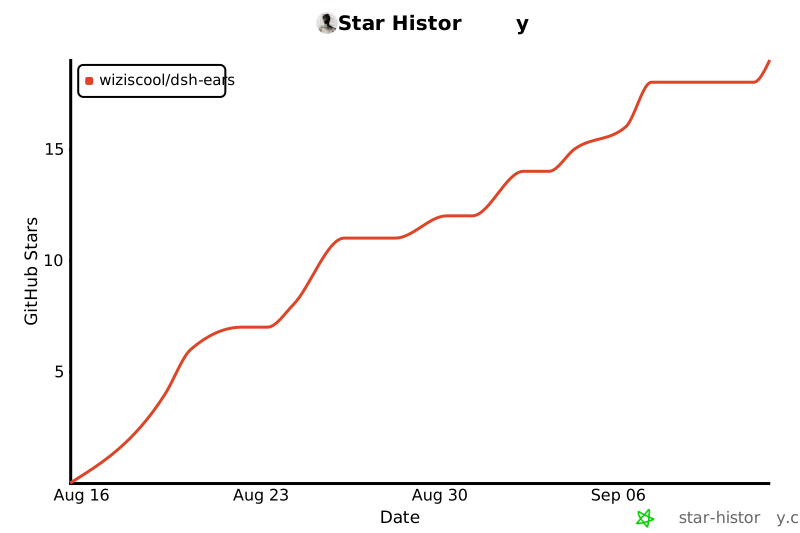
## Star History